Google 推出新的 AI 課程,幫助所有人學習 AI

Google 推出一系列針對所有人及中小學教師的 AI 課程

人工智能 (AI) 的快速發展正在深刻地影響著我們的生活和工作方式。從智慧助理到自動駕駛汽車,AI 技術已經滲透到社會的方方面面。為了幫助更多人瞭解和應用 AI,Google 推出了一系列的 AI 課程,旨在普及 AI 知識,培養大眾的 AI 素養。

Google 推出的 AI 課程介紹

AI Essentials 課程

    Google 推出的 AI Essentials 課程是一門面向所有人的 AI 入門課程。課程內容涵蓋了 AI 的基礎知識、AI 在日常生活中的應用、以及 AI 的未來發展趨勢等主題。學習者不需要具備任何技術背景,只要對 AI 感興趣,就可以通過這門課程對 AI 有一個全面的瞭解。

    課程採用線上自主學習的方式,包含影片講解、互動練習、小測驗等多樣化的學習元素。透過生動有趣的案例和與生活緊密結合的說明,AI Essentials 課程讓 AI 知識變得淺顯易懂,適合所有年齡層和背景的學習者。

    AI for Educators 課程

      除了面向普通大眾的 AI Essentials 課程,Google 還特別為教育工作者設計了 AI for Educators 課程。這門課程的目標是幫助中小學教師瞭解 AI 在教育領域的應用,掌握如何將 AI 技術融入教學,以及設計出有效的 AI 教學活動。

      AI for Educators 課程採用線上課程與實作專案相結合的學習方式。教師們不僅可以學習 AI 教育的理論知識,還能透過實際的教學專案,將所學應用到教學實踐中。課程還提供豐富的教學資源和社群支持,幫助教師們在 AI 教育的道路上不斷成長。

      Google 推廣 AI 教育的意義

      Google 大力推廣 AI 教育,其意義不僅僅在於傳授 AI 知識和技能,更在於為 AI 時代的到來做好準備。

      首先,普及 AI 知識可以幫助消除大眾對 AI 的誤解和恐懼。許多人對 AI 存在著各種疑慮,擔心 AI 會取代人類的工作,甚至危及人類的生存。透過 AI 教育,我們可以讓更多人瞭解 AI 的真正面貌,看到 AI 技術在改善我們生活、解決問題方面的巨大潛力,從而消除對 AI 的偏見和恐懼。

      其次,培養 AI 素養是幫助人們在 AI 時代保持競爭力的關鍵。隨著 AI 技術的不斷發展,未來將有越來越多的崗位需要具備 AI 知識和技能的人才。通過學習 AI 課程,人們可以掌握 AI 的基本原理和應用,提升自己的數位技能,在職場上保持競爭優勢。

      再者,Google 推廣 AI 教育還有助於鼓勵更多人參與到 AI 的發展中來,促進 AI 技術的創新應用。AI 的發展離不開各行各業人才的參與和貢獻。通過普及 AI 教育,我們可以吸引更多不同背景的人才加入 AI 領域,為 AI 技術注入新的創意和活力,推動 AI 在各個行業的應用和發展。

      最後,Google 推廣 AI 教育的一個重要目標是縮小 AI 教育的數位落差,實現教育平等。傳統的 AI 教育往往集中在高等院校和科技公司,普通民眾很難有機會接觸和學習 AI 知識。而 Google 推出的 AI 課程是完全免費和開放的,任何人都可以隨時隨地學習 AI,這大大降低了 AI 教育的門檻,為更多人提供了平等的學習機會。

      結語

      Google 推出 AI 課程的願景是讓每個人都有機會學習和應用 AI,共同參與到 AI 時代的建設中來。無論你是學生、教師、還是普通的社會大眾,都可以通過 Google 的 AI 課程,對 AI 有一個全面的瞭解,提升自己的 AI 素養。

      Google 2024 年 3 月核心更新完成推出

      Google 2024年3月核心更新及垃圾郵件政策更新

      Google 於2024年3 月5日推出了一次重大的核心更新,旨在減少僅為吸引點擊的內容,並顯示更多對使用者有用的內容,以提升 Google 搜尋品質。這次更新涉及多個核心系統的變更,認定內容實用性的方式有重大改變,運用多種創新信號和方法來顯示實用結果。

      2024年4月27日, Google 於其官方 X 宣佈,本次核心更新已於4月19日完成。

      更新目的:減少無用內容,提升搜尋品質

      Google 公眾搜尋聯絡人 Danny Sullivan 表示:「我們的目標是減少那些僅為吸引點擊而製作的內容,並顯示更多對使用者真正有用的內容。」 這次更新運用了多種新方法來判斷內容的實用性,包括內容的原創性、專業性、可信度等。

      Sullivan 補充說:「我們希望這次更新能夠提升 Google 搜尋的整體品質,讓使用者能夠更輕鬆地找到所需的資訊。」 這反映了 Google 一直以來對於提供高品質搜尋結果的承諾。

      更新複雜程度高,排名波動大

      這次核心更新的複雜程度很高,涉及多個核心系統的變更,因此對搜尋結果的影響也將更為顯著, Google 表示這次更新相較一般的核心更新排名波動會更大。

      不同的系統將全面更新並相輔相成,以確保搜尋結果的品質。Sullivan 解釋說:「我們採用了多種創新的信號和方法來判斷內容的實用性,這需要多個系統的配合。」

      對網站創作者的影響

      對於那些一直致力於製作令使用者滿意的內容的網站創作者來說,這次更新對他們的影響應該不大。Sullivan 表示:「如果你一直在製作高品質、實用的內容,那麼你就不需要採取任何行動。」

      但是,如果某些網站的排名在更新後出現下滑, Google 建議他們應該參考「建立實用、可靠且以使用者為優先的內容」的指南,並檢視自己的內容是否真正對使用者有用。

      新版垃圾內容政策

      為了進一步打擊那些可能對搜尋結果品質造成負面影響的做法,Google 也推出了三種新的垃圾內容政策:過期網域濫用、大規模內容濫用和網站信譽濫用。

      過期網域濫用

      這種做法是指購買過期的網域,並將其用於與原本用途完全不同的內容。主要目的是為了操控搜尋排名。Google 表示,這種做法將受到懲罰。

      大規模內容濫用

      這是指大量產生對使用者幾乎無價值的非原創內容,主要目的也是為了操控搜尋排名。Google 將嚴格打擊這種行為。

      網站信譽濫用

      這種做法是指在發布第三方內容時幾乎沒有任何監督,目的是利用第一方網站的排名信號來操縱排名。Google 將視情況採取適當的處置措施。

      業界專家評論與建議

      對於這次更新,業界專家們也紛紛表示看法。Amsive Digital 公司 SEO 策略和研究副總裁 Lily Ray 表示:「這次更新的影響力是前所未有的,網站創作者必須更加重視內容的實用性和原創性。」 她建議網站創作者應該定期審視自己的內容策略,確保內容真正對使用者有價值。

      另一位 Google 的搜尋代表 John Mueller 則說:「Google 這次更新的目標很明確,就是要淘汰那些僅為賺廣告收入而製作的內容。」 他建議網站創作者應該專注於製作高品質、深入的內容,而不是追求流量。

      整體來說,這次 Google 核心更新對網站創作者來說是一個巨大的挑戰,但也是一個機會,讓他們能夠反思自己的內容策略,並專注於為使用者創造真正有價值的內容。

      OpenAI 推出 ChatGPT 新記憶功能

      OpenAI 推出 ChatGPT 記憶對話功能

      人工智慧助理 ChatGPT 推出了一項新功能,讓它能夠記住使用者的資訊並提供更個人化的體驗,但這項功能也引發了一些隱私疑慮。

      ChatGPT 新記憶功能詳解

      ChatGPT 記憶功能設定畫面

      根據 OpenAI 的說明, ChatGPT 的新記憶功能可以跨對話儲存使用者分享的個人細節,例如姓名、興趣和工作等資訊。即使使用者沒有明確要求 ChatGPT “記住”,它也會自動記錄對話中值得注意的細節。不同的 AI 模型將擁有獨立的記憶空間,不會共享使用者資料。

      使用者也可以主動要求 ChatGPT 記住特定的內容,讓對話更加貼近個人需求。 OpenAI 表示這項功能的目的是為了提高 AI 助理的個人化體驗,讓它能夠根據使用者的喜好和背景提供更加貼切的回應。

      舉例來說, 一個使用者向 ChatGPT 提供了三個不同的事實:她有一個即將五歲的女兒 Lina 、 Lina 喜歡水母、 Lina 喜歡粉紅色。在第四次對話中,使用者要求 ChatGPT 為她的女兒製作生日賀卡, ChatGPT 便運用這些記憶,使用 DALL-E 生成了一張畫有粉色水母的粉色賀卡。

      隱私和數據使用疑慮

      儘管記憶功能預設為開啟狀態,但使用者可以透過設定選項將其關閉或清除記憶。 OpenAI 聲稱會試圖避免主動儲存使用者的敏感資訊,例如密碼或證件號碼,而新功能的一個設計就是拒絕保存此類數據。

      然而,使用者對話中的記錄可能會被 OpenAI 用於進一步訓練和改進其 AI 模型,除非使用者選擇退出這項做法。此外,先前也曾發生過部分對話記錄外洩的事件,引發了人們對於儲存個人數據的隱私疑慮。

      結語

      ChatGPT 的新記憶功能無疑能夠提升 AI 助理的個人化體驗,但它也引發了人們對隱私權的疑慮。隨著 ChatGPT 的應用範圍越來越廣,社會對其合規性的呼聲也越來越高。 OpenAI 需要加強對 ChatGPT 的安全防護,避免其被利用從事違法犯罪活動。

      附註:筆者實測結果,這個功能比較像是用戶告訴 ChatGPT 他想要什麼,打算讓 ChatGPT 固定用什麼方式回答,如同一個介於 Custom instructions (自訂指令) 與 GPTs 之間的輔助功能,用來增強 Custom instructions 無法涵蓋的交互細節。所以在使用時”建議”在對話中明確告訴 ChatGPT 我們想要它固定做的事,例如”請你在後續的對話中固定使用禮貌的口吻”、”後續的對話只使用繁體中文,不要用簡體中文”。筆者認為它與一般用戶所想像記憶每個對話的細節加以調整後續的對話的方式不太一樣(或許它會在對話中自動記憶用戶的關鍵資訊,但因為筆者的測試時間較短,目前還沒看到它主動將一般對話紀錄到 Memory 中)。如下圖所示:

      ChatGPT會記憶使用者指定要記憶的行為內容

      而根據 GPT-4 Turbo 自己的說法,Custom Instructions 允許使用者向模型提供特定的指令,以指導生成內容的方向,這意味著使用者可以透過自定義指令來定制模型的行為,使其更符合特定任務或場景的需求;Memory 功能使模型能夠存儲和檢索資訊,從而在生成文本時能夠更好地保持上下文和一致性。通過將過去的資訊存儲在內部記憶中,模型可以更好地理解當前對話或文本的背景,並相應地調整其生成內容,以更好地滿足使用者的需求。

      Adobe 發布最新 Firefly Image 3 模型

      Adobe Firefly Image 3 成像範例1

      人工智能( AI )技術在近年來發展迅速,其中以文生圖( Text-to-Image )模型最為引人注目。作為這一領域的先驅者,Adobe 公司自 2022 年推出 Firefly 模型以來,便不斷在優化和更新。最新發布的 Firefly Image 3 模型,無疑將為創作者帶來全新的體驗和可能性。

      Firefly Image 3 模型的發布,標誌著 Adobe 在 AI 創作領域邁出了重要的一步。這款模型不僅在圖像質量和細節方面有了大幅提升,還能更好地理解和匹配文字提示,為用戶提供更加個性化和高效的創作體驗

      Firefly Image 3 模型介紹

      YouTube thumbnailYouTube icon
      影片來源:Adobe

      Firefly Image 3 是一種基於大規模數據訓練的文生圖模型,能夠根據用戶輸入的文字描述生成相應的圖像。與前代模型相比,Firefly Image 3 採用了更大的訓練數據集和更先進的訓練方法,從而顯著提高了生成圖像的質量和準確性。

      在訓練數據方面,Firefly Image 3 模型利用了包括藝術作品、自然景觀、人物肖像等多種類型的海量圖像數據。同時,Adobe 還採用了一種新的數據增強技術,通過對圖像進行旋轉、裁剪等操作,進一步擴充了訓練數據的多樣性。

      在訓練方法上,Firefly Image 3 模型採用了最新的深度學習算法,能夠更好地捕捉圖像中的細節和語義信息。此外,Adobe 還引入了一種新的注意力機制,使模型能夠更準確地理解和匹配文字提示,生成更加貼合用戶需求的圖像。

      為了避免生成侵犯版權或不當內容的圖像,Adobe 採取了多層審查機制。用戶生成的圖像將經過自動和人工審查,確保其合法合規。同時,Adobe 也明確表示,Firefly 生成的內容可用於商業用途,不會侵犯任何版權。

      Firefly Image 3 的主要特點

      提高圖像畫質和細節

      相比之前的版本,Firefly Image 3 模型生成的圖像在畫質和細節方面有了顯著提升。無論是人物肖像、風景還是物品,都能呈現出更加清晰、細膩的細節,讓圖像看起來更加真實和生動。

      改善文字理解和風格匹配

      Firefly Image 3 模型能夠更好地理解用戶輸入的文字提示,準確捕捉其中的關鍵資訊和語義。同時,模型還能自動分析提示中的風格描述,並將其應用到生成的圖像中,使圖像的風格更加符合用戶的期望。

      優化參考圖像利用

      在生成圖像時,用戶還可以提供參考圖像作為輔助。Firefly Image 3 模型能夠更好地利用參考圖像中的結構和風格信息,使生成的圖像在構圖和風格上更加接近參考圖像,同時還能根據文字提示進行創新和變化。

      提升文字生成質量

      除了生成高質量的圖像外,Firefly Image 3 模型還能夠生成清晰、準確的文字。無論是在圖像中插入文字,還是生成帶有文字的圖像,Firefly Image 3 都能確保文字的可讀性和一致性,為用戶提供更好的視覺體驗。

      Firefly Image 3 的應用場景

      作為一款強大的 AI 創作工具,Firefly Image 3 模型在多個領域都有廣泛的應用前景:

      創意設計和概念構思

      設計師可以利用 Firefly Image 3 快速生成各種概念圖像和視覺靈感,為設計項目提供豐富的創意來源。無論是產品設計、廣告設計還是插畫設計,都能從中獲益。

      廣告和行銷視覺內容

      行銷人員可以使用 Firefly Image 3 生成吸引眼球的廣告視覺內容,包括海報、Banner 和社交媒體圖像等。這不僅能夠提高行銷效率,還能為品牌帶來更加個性化和創新的視覺體驗。

      插畫和漫畫創作

      漫畫家和插畫師可以利用 Firefly Image 3 快速生成人物、場景和道具等元素,為他們的作品提供豐富的視覺素材。這不僅能夠節省時間,還能激發更多的創意靈感。

      教育和培訓資料製作

      教師和培訓師可以使用 Firefly Image 3 生成各種教學圖像和視覺輔助材料,為學生提供更加生動、形象的學習體驗。這對於抽象概念的解釋和理解尤其有幫助。

      如何使用 Firefly Image 3

      通過 Firefly 網站使用

      用戶可以直接訪問 Adobe 的 Firefly 網站,線上使用 Firefly Image 3 模型。只需輸入文字提示和參考圖像(可選),即可生成所需的圖像。

      整合至 Photoshop 和 InDesign

      Adobe 還將 Firefly Image 3 模型整合到了 Photoshop 和 InDesign 等創作軟體中。用戶可以在這些軟體內直接調用 AI 生成圖像的功能,無需切換到其他應用程式。

      文本提示和參考圖像輸入

      使用 Firefly Image 3 時,用戶需要輸入詳細的文字提示,描述所需生成的圖像內容、風格和細節。同時,也可以上傳參考圖像作為輔助,以獲得更加符合預期的結果。

      生成結果的調整和修改

      Firefly Image 3 生成的圖像並非一成不變,用戶可以對其進行進一步的調整和修改。例如調整圖像大小、顏色、對比度等參數,或者直接在圖像上繪畫和編輯,以獲得最終理想的作品。

      實際測試

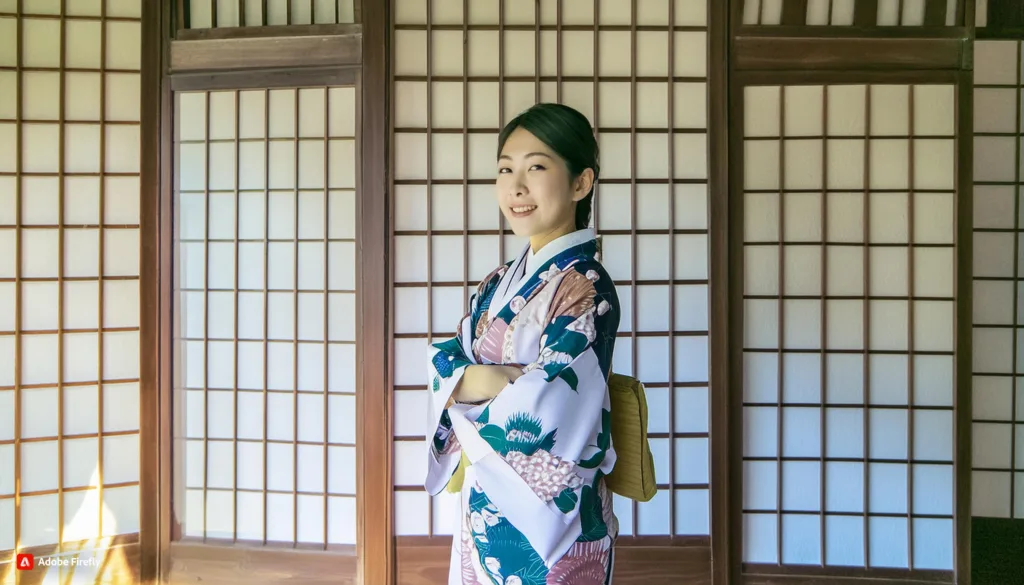
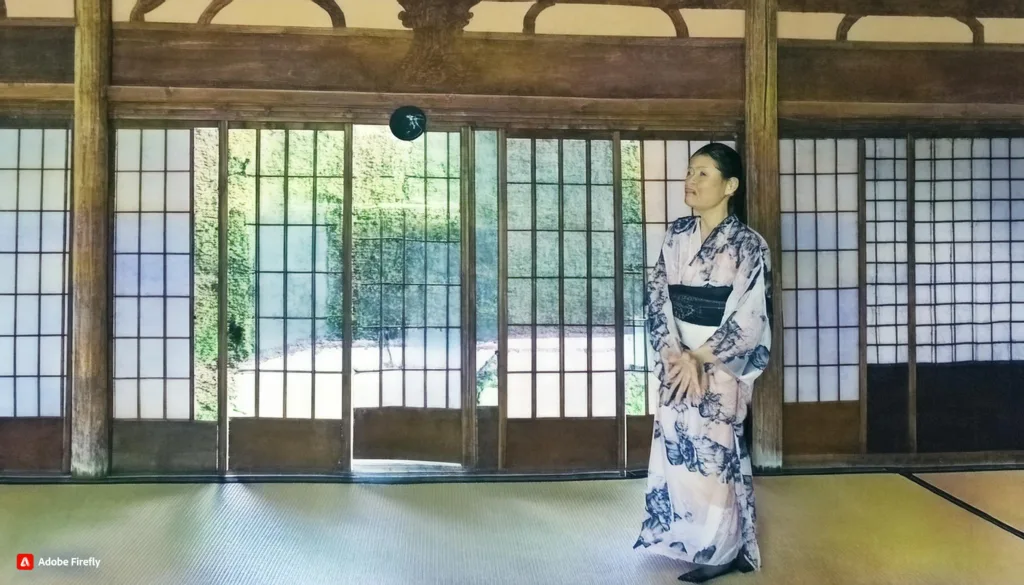
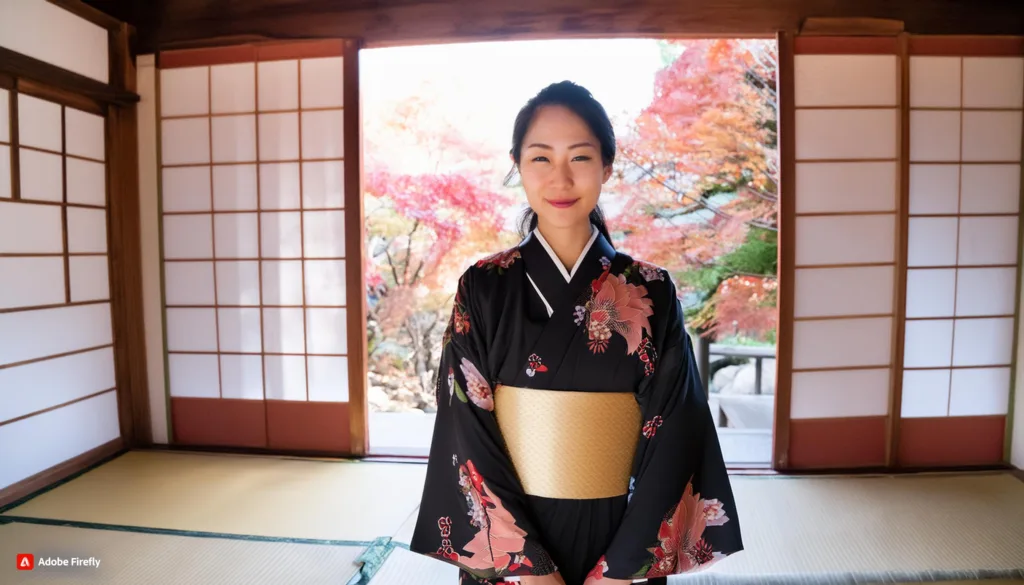
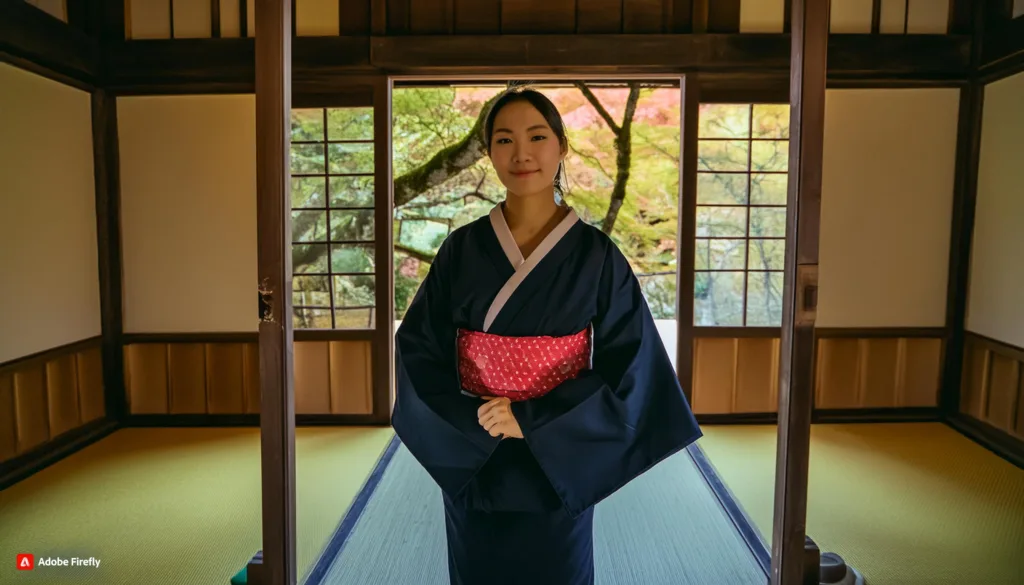
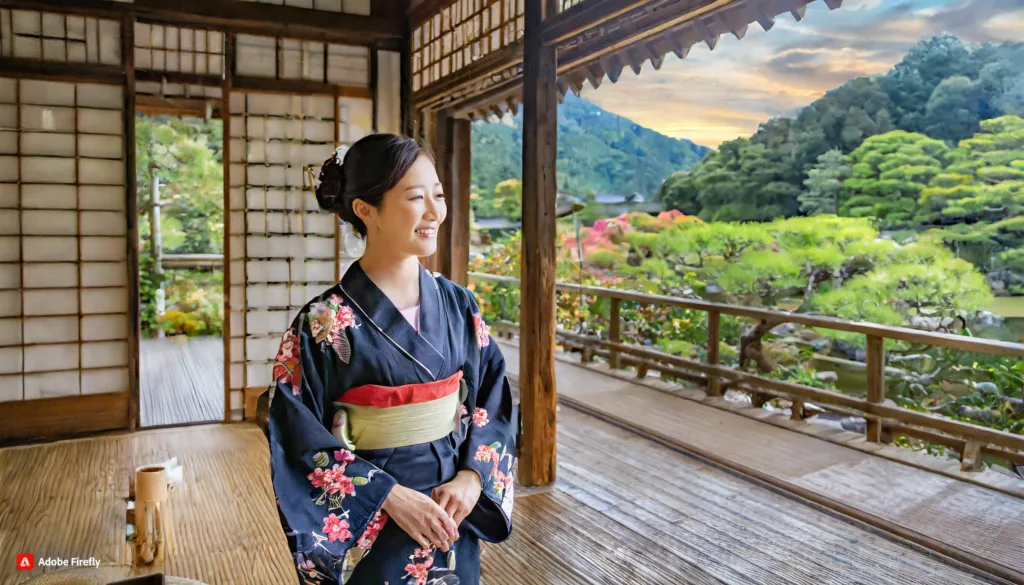
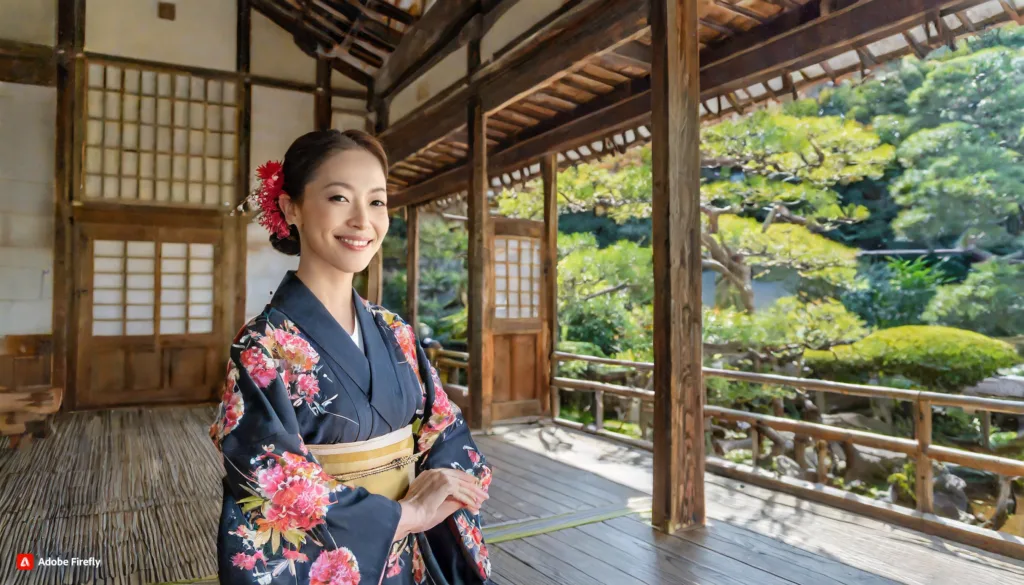
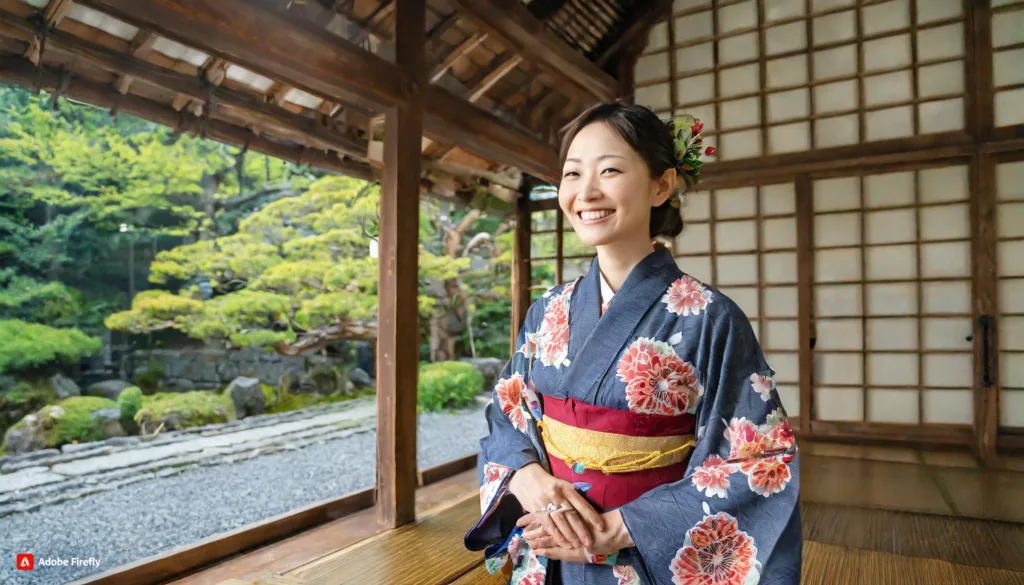
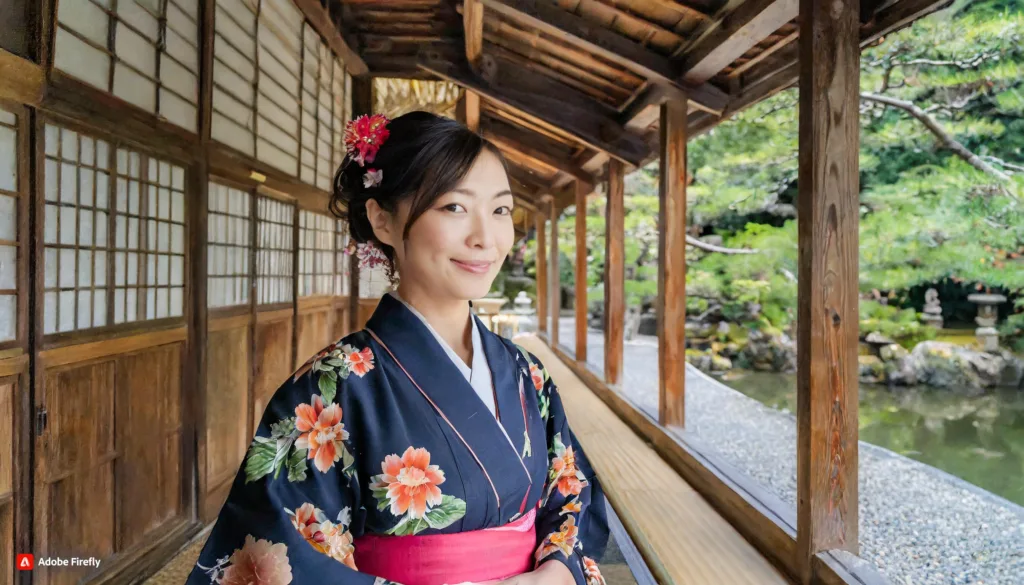
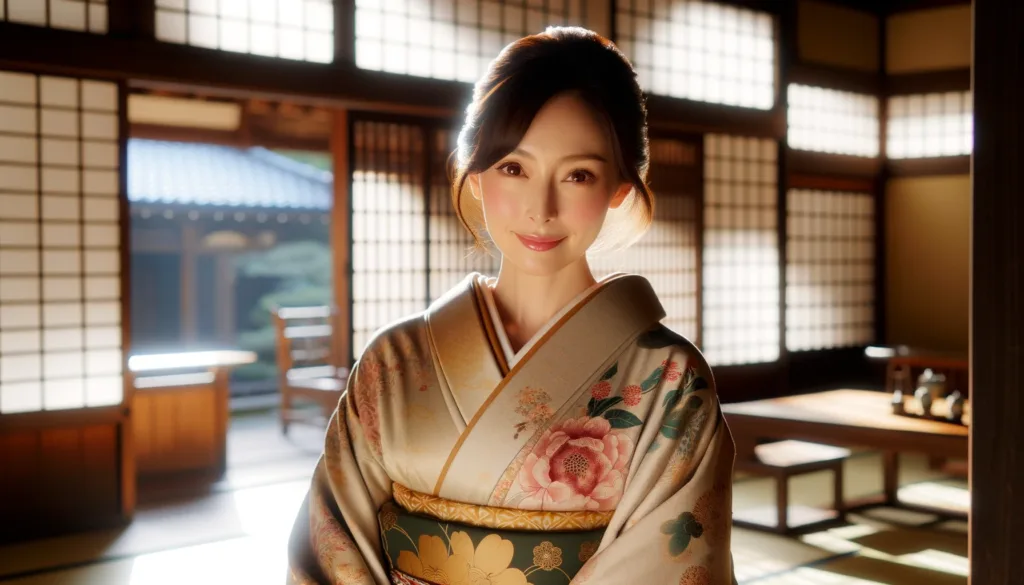
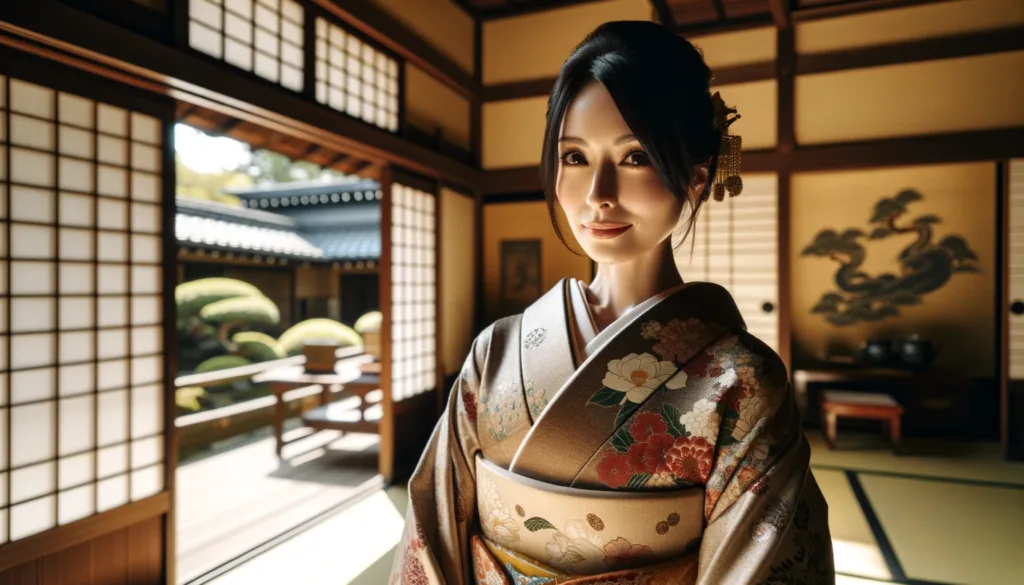
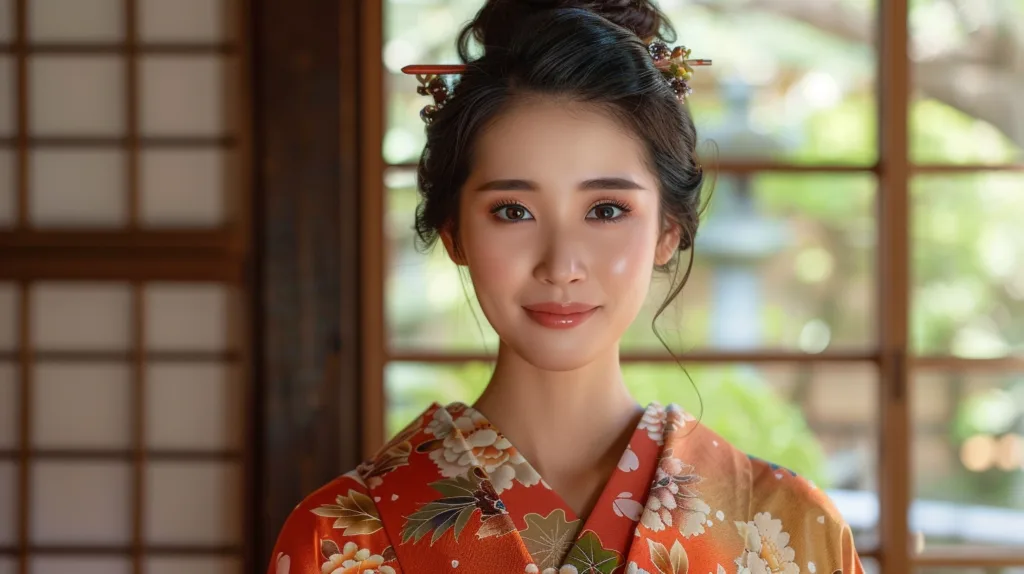
      讓我們用一個較為複雜的 Prompt 測試 Firefly Image 3 在處理複雜細節和紋理上的能力,同時檢視其對人物面部特徵和表情的呈現精度。這是一個極具挑戰性的測試,因為它包含了豐富的細節和多樣的視覺元素,這些都是目前 AI 繪圖模型在處理上可能會遇到的難點。同時與先前的 Firefly Image 2 及其他目前主流的 AI 繪圖模型如 DALL-E 3 、 Midjourney V6 、 Leonardo Lightning XL 做比較,讓讀者觀察成像品質的差異。

      Prompt: A beautiful 30-year-old Japanese woman is in a highly challenging environment – an ancient Japanese tea house. This woman is wearing a traditional gorgeous kimono, and the intricate floral patterns on the kimono require careful presentation. Her facial features should display subtle emotional expressions, such as a faint smile and a certain depth in her gaze. The background is the interior of the tea room, including sliding doors, wooden flooring, and a Japanese garden outside the window. This image should appear natural in the use of light and shadow, especially in the way natural light enters outside the window and reflects on various indoor objects. (一位美麗的30歲日本女性,她身處一個極具挑戰性的環境中——一個古老的日本茶室。這位女性穿著傳統的華麗和服,和服上繁複的花卉圖案需要細緻的呈現。她的臉部特徵應該顯示出微妙的情感表達,如淡淡的微笑和眼神中的某種深邃。背景是茶室內部,包括滑門、木質地板和一窗外的日本庭園。此畫面應該在光影運用上顯得自然,特別是窗外自然光線的進入方式和在室內各物件上的反射。)

      Adobe Firefly Image 3

      Adobe Firefly Image 3 成像範例1
      Adobe Firefly Image 3 成像範例2
      Adobe Firefly Image 3 成像範例3
      Adobe Firefly Image 3 成像範例4

      Adobe Firefly Image 2

      Adobe Firefly Image 2 成像範例1
      Adobe Firefly Image 2 成像範例2
      Adobe Firefly Image 2 成像範例3
      Adobe Firefly Image 2 成像範例4

      DALL-E 3

      DALL-E 3 成像範例1
      DALL-E 3 成像範例2

      Midjourney V6

      Midjourney V6 成像範例1
      Midjourney V6 成像範例2
      Midjourney V6 成像範例3
      Midjourney V6 成像範例3

      Leonardo Lightning XL

      Leonardo Lightning XL 成像範例1
      Leonardo Lightning XL 成像範例2
      Leonardo Lightning XL 成像範例3
      Leonardo Lightning XL 成像範例4

      從成像結果觀察,Adobe Firefly Image 3 在背景的畫質呈現較 Image 2 更為細緻而且在光影的處理上更為進步, Image 2 的背景在正常尺寸細看之下就會發現有些模糊並有明顯的塗抹感,但是在人物的精緻度、整體構圖方面,筆者反而覺得 Image 2 更為優異,更重要的是 Image 3 的第2張範例中,人物的臉部及手部很明顯處理失敗,而在 Image 2 中反而沒有出現這樣的情形。由於 Image 3 目前還處於預覽版階段,相信未來 Adobe 會持續優化這個版本的輸出降低成像的出錯率。

      至於其他主流 AI 繪圖模型, 筆者認為 Midjourney V6 對提示詞的理解及輸出品質表現最好,人物的美感也最為強烈; Leonardo Lightning XL 是基於 Stable Diffusion 調校而成的高速生成模型,成像品質最為平衡,雖說某些畫面例如第二張圖的人物臉部輸出有些微小瑕疵,但是輸出的畫面很自然比較接近真實的攝影照片;DALL-E 3 對於提示詞的理解很完整,但是其輸出的 AI 風格最為強烈。

      Midjourney 宣佈推出 「探索視覺功能潛在空間」 測試算法

      Midjourney Sref Random 範例

      2024年4月23日, Midjourney 在其官方 Discord 頻道宣佈推出 ” exploring the latent space of visual styles “(探索視覺功能潛在空間)測試演算法。這個新演算法旨在為每一個用戶提供一個簡單有趣的工具。 Midjourney 表示這是對其底層算法的測試,他們將在未來為這個功能創造更先進的工具。

      使用方法

      在 prompt 後增加 ––sref random 即可獲得完全隨機的樣式。

      實際測試

      讓我們用一個簡單的 prompt 來測試其隨機效果

      Candid photo of a beautiful Japanese woman in the Tokyo street. --ar 16:9 --s 200 --sref random --v 6.0

      我們一共下了四次相同的指令,輸出如下:

      結果一

      Midjourney Sref Random  範例

      結果二

      Midjourney Sref Random  範例

      結果三

      Midjourney Sref Random  範例

      結果四

      Midjourney Sref Random  範例

      從輸出結果可以看到,透過這個指令可以生成風格差異相當大的結果。如果生成的圖片中有令讀者滿意的風格,則可以接著使用 ––sref url 指令進行後續的圖像生成工作。

      進階用法

      sref random 參數也可以結合角色參考功能參數 cref 使用,在同樣人物樣貌的基礎上產生各種不同風格的變化,同時利用 sw 和 cw 控制風格強度。公式如下:

      Prompt + ––serf random + ––cref url + ––sw (0-100) + ––cw (0-100)

      我們利用首圖的女主角再進行風格變化,輸入以下指令:

      Candid photo of a beautiful Japanese woman in the Tokyo street. --ar 16:9 --s 200 --sref random --cref https://s.mj.run/zqGbpL1SeMg --sw 100 --cw 0 --v 6.0

      輸出結果如下:

      Midjourney sref random 進階指令呈現結果

      各位讀者也可以再試試不同的 sw 及 cw 參數組合觀察輸出效果的差異。

      快速複製特定風格創造新圖像

      2024年4月27日, Midjourney 官方宣佈推出針對 sref random 的新功能” sref code “,只要在 Prompt 後輸入由 sref random 產生圖像的唯一 seed 號碼,就可以延續該 seed 的風格。

      我們使用上方左上角的那張圖,到官網個人頁面中 copy 該圖的 seed 號碼,如下圖:

      到 Midjourney 官網 copy 特定圖像的 seed id 用來複製特定 sref random 產生的風格

      取得 Seed id 號碼1872264792,然後測試一個新的 prompt :

      Prompt:A Japanese office lady in the big office. ––sref 1872264792 ––ar 16:9 ––v 6.0 ––s 50

      輸出結果:

      Midjourney sref code 功能輸出結果

      我們可以看到輸出的結果與上方的參考圖像是一致的。這功能對於需要快速輸出相同風格的用戶來說是相當方便的。

      進一步閱讀
      1. Midjourney 推出模型個人化( Model Personalization )功能
      2. Midjourney 推出新的「角色參考」測試功能
      3. Midjourney 最新更新:引入「一致風格」功能,增強藝術生成體驗