擺脫 AI 大模型幻覺:提示詞工程實戰操作指南

提示詞工程實戰操作指南

大型語言模型( LLMs )已成為人工智能領域的強大工具,能夠針對各種任務生成如同人類撰寫般的文字。從撰寫郵件到產生程式碼,LLMs 的應用範圍持續擴展,展現出巨大的潛力。提示詞工程作為一個相對新興的領域,其核心在於開發和優化輸入提示,以更有效率地利用 LLMs 於廣泛的應用和研究主題之中 。這項技能有助於更深入地理解 LLMs 的能力和局限性,並提升模型在問答和算術推理等常見及複雜任務上的表現。開發人員也藉由提示詞工程設計出更穩健且有效的提示技巧,以與 LLMs 和其他工具進行互動。

然而,LLMs 的發展並非沒有挑戰。其中一個關鍵問題是所謂的「幻覺」,指的是 AI 模型產生看似真實但實際上是錯誤或誤導性的資訊,並將其視為事實呈現 。這種現象可能會嚴重損害人們對 LLMs 作為可靠資訊來源的信任,並可能導致錯誤資訊的傳播。儘管研究人員正積極尋找消除或減輕幻覺的最佳方法,但提示詞工程已成為一種日益重要的手段,透過引導模型產生更準確和有用的輸出,進而釋放LLMs的全部潛力。這篇文章我們希望提供對提示詞工程最新進展的結構化概述,並著重於實戰操作,幫助讀者現學現用。

深入剖析:大型語言模型為何產生幻覺?

大型語言模型產生幻覺的原因複雜多樣,主要可歸因於 AI 數據、模型訓練或回應生成過程中的缺陷。首先,訓練數據可能包含偏差、事實錯誤或不完整的資訊, LLM 在缺乏現實世界理解的情況下,可能會繼承並在輸出中延續這些缺陷。其次, LLMs 擅長根據機率預測序列中的下一個詞語,但它們本身無法辨別真假。一個看似合理的陳述可能符合模型學習到的模式,即使它完全是捏造的。

此外, LLMs 的回應往往基於有限的上下文,在缺乏更廣泛資訊的情況下,它們可能會誤解提示或產生在內部一致但與上下文無關的回應。過度擬合是另一個常見原因,指的是 LLMs 過於專注於記憶訓練數據中的模式,當遇到新的資訊時,可能會產生不相關或荒謬的輸出。 LLMs 也可能缺乏對因果關係或資訊邏輯流的理解,導致產生的文本在語法上正確但內容荒謬。含糊不清或誤導性的提示同樣會導致模型根據其理解填補空白,從而產生幻覺式回應。訓練數據中存在的演算法偏差也會反映在 LLM 的輸出中,導致產生帶有刻板印象或歧視性的幻覺。

大型模型在接受新的數據訓練時,可能會遇到「災難性遺忘」的問題,失去對原始數據集的識別能力,進而增加產生幻覺的可能性。某些 LLMs 的自回歸特性,即根據先前的輸出預測序列的未來元素,也可能導致不準確性的傳播。LLMs 的機率性質是導致幻覺的核心原因。它們生成最有可能的序列,但這並不總是事實上正確的。 LLMs 雖然擁有龐大的資訊量,但缺乏像人類一樣辨別真假的能力。它們可能會自信地生成錯誤資訊,因為它們並不知道那是錯誤的。這突顯了外部驗證機制和精煉提示策略的重要性。理解這些潛在的幻覺來源,有助於我們更有針對性地設計提示詞,從而提升模型的可靠性。

提示詞工程的核心技巧:提升模型準確性

要撰寫出色的 LLM 提示,需要具備多項技巧。以下將介紹一些核心技巧,並提供具體的操作方法和範例,幫助讀者提升模型的回應準確性。

具體明確

操作方法:在提示中清楚說明您希望模型返回什麼,避免使用模糊不清的詞語。使用明確的動詞指定期望的操作,並定義所需的輸出長度和格式 。

不良提示:

總結這篇文章。

良好提示:

請用三句話總結這篇關於氣候變遷對沿海社區影響的研究論文的主要發現。

目的:明確要求三句話的摘要,並指定了文章主題。

結構化提示

操作方法:使用項目符號、編號或標題等方式組織提示,使LLM更容易理解輸入的每個部分。可以先定義模型扮演的角色,然後提供上下文/輸入數據,最後再給出指令 。

提示:

你是一位資深行銷經理。請根據以下數據,為一款新的智慧手錶撰寫一份產品說明:

- 特色:防水、GPS、心率監測

- 目標受眾:健身愛好者

- 風格:簡潔有力

目的:清晰地設定了角色、提供了產品特色、目標受眾和風格要求。

提供上下文

操作方法:提供相關的背景資訊或解釋請求的目的,幫助模型產生符合期望的回應 。引用特定的來源或文件,讓模型基於這些資訊進行回答。

提示:

根據這份最新的財務報告([連結]),分析公司過去五年的盈利能力,並指出主要的成長驅動力。

目的:提供了具體的資訊來源,要求模型基於該報告進行分析。

提出開放式問題以尋求解釋

操作方法:提出鼓勵模型探索複雜主題並提供詳細且具體回應的問題,避免使用是或否的提問 。

不良提示:

人工智能重要嗎?

良好提示:

在未來十年,先進人工智能可能帶來哪些潛在的影響?

目的:引導模型深入思考並提供更全面的分析。

要求範例

操作方法:在提示中包含少量的輸入-輸出範例,引導模型並提高輸出品質 。

提示:

以下是一些將英文翻譯成法文的範例:

- 'Hello' -> 'Bonjour'

- 'Thank you' -> 'Merci'

- 'Goodbye' -> 'Au revoir'

現在請將 'Good morning' 翻譯成法文。

目的:透過提供的範例,模型可以學習翻譯的模式。

避免歧義

操作方法:使用精確的語言,避免使用可能有多種解釋的詞語或短語 。

不良提示:

寫一篇關於蘋果的文章。

(蘋果可以指水果或公司)

良好提示:

寫一篇關於蘋果公司最新產品發布的文章。

目的:明確指定了討論的主題是蘋果公司。

根據模型能力調整提示

操作方法:了解使用的 LLM 的優勢和限制,並根據其能力設計提示。

目的:如果某個模型擅長程式碼生成,可以提供更詳細的程式碼要求和範例。

保持簡潔和全面

操作方法:在提供足夠資訊的前提下,盡可能使提示簡潔明瞭 。避免過度冗長的提示,以免模型迷失重點。

提示:在要求模型總結長篇文章時,可以先提供文章的關鍵段落,而不是全文。

使用嚴格措辭

操作方法:使用如「你的任務是」、「你必須」等明確的指令,使模型更好地理解其任務和優先順序 。

提示:

你的任務是根據提供的數據,撰寫一份關於市場趨勢的報告,報告必須包含數據來源。

指定目標受眾

操作方法:在提示中說明目標受眾,有助於模型調整回應的風格和複雜程度 。

提示:

請用簡單的詞語解釋量子計算的概念,目標受眾為非技術人員。

分解複雜任務

操作方法:將複雜的任務分解為更簡單的提示,逐步引導模型完成任務 。

提示:要撰寫一篇研究報告,可以先要求模型撰寫大綱,然後再逐步完成每個部分。

定義輸出格式

操作方法:在提示中明確指定所需的輸出長度和格式,例如列表、段落、JSON等 。

提示:

請以項目符號列表的形式,列出五種減少AI模型幻覺的方法。

指示風格和語氣

操作方法:指示模型所需的風格和語氣,例如正式、幽默、專業等 。

提示:

請以聯合報的風格,撰寫一篇關於區塊鏈技術最新發展的報導。

專注於期望的操作

操作方法:專注於希望模型執行的操作,而不是希望避免的操作,通常會產生更好的結果 。

不良提示:

不要使用被動語態。

良好提示:

請使用主動語態撰寫這份報告。

使用清晰的提示語法

操作方法:使用清晰的標點符號、標題和章節標記,有助於傳達意圖並使輸出更易於解析。

提示:使用 ### 指示 ###、### 範例 ###、### 問題 ### 等標記來組織提示 。

迭代精煉

操作方法:不斷測試和調整您的提示。分析模型的回應,並根據結果修改提示,直到獲得滿意的輸出 。

聚焦關鍵:擺脫幻覺的進階提示詞策略

除了上述核心技巧外,還有一些更進階的提示詞策略可以顯著減少幻覺的產生 。

明確指示避免不實資訊

操作方法:在系統提示或主要提示中明確告知模型不要添加不真實或無法驗證的資訊 。

提示:在系統提示中加入:

如果資訊不在提供的文本中,請回答『我不知道』。

少量樣本提示

操作方法:在提示中提供少量的具體範例,展示期望的輸入和輸出格式,引導模型專注於特定主題並減少幻覺 。

提示:提供幾個問題和對應的正確答案範例,然後再提出希望模型回答的問題。

思維鏈

操作方法:引導模型逐步進行思考,並呈現中間的推理步驟,然後再得出最終答案。可以在提示中加入「逐步思考」等指令 。

提示:

問題:如果一個蘋果的價格是3元,三個蘋果的價格是多少?請逐步解釋你的計算過程。

驗證鏈

操作方法:提示模型先生成初步回應,然後要求它產生一系列驗證問題來檢查其工作,獨立回答這些問題,最後根據驗證結果產生修訂後的更準確輸出 。

提示:

問題:美國有哪些總統出生在紐約?請先列出你的答案,然後提出驗證每個總統出生地的問題,並回答這些問題,最後給出修正後的答案。

筆記鏈

操作方法:當使用檢索到的文檔時,提示模型評估這些文檔的相關性,強調關鍵和可靠的資訊,過濾掉不相關的內容,然後再生成答案。

提示:

根據以下檢索到的文章([連結1]、[連結2]),請先評估每篇文章與問題『全球暖化的主要原因是什麼?』的相關性,然後僅使用相關的文章來回答問題。

僅使用提供的文檔資訊

操作方法:明確指示模型僅使用您在提示中提供的文檔或資訊來回答問題,而不是依賴其一般知識 。

提示:

請根據以下文本回答問題:[提供的文本]。問題:文本中提到了哪些減少AI幻覺的方法?

要求提取逐字引號

操作方法:對於較長的文檔,要求模型在執行任務之前先提取相關的逐字引號,確保其回應基於實際文本 。

提示:

請閱讀以下文章,並提取所有關於提示詞工程技巧的逐字引號,然後用這些引號來支持你對『如何使用提示詞工程減少AI幻覺?』這個問題的回答。

自我一致性解碼

操作方法:讓模型針對同一個提示產生多個獨立的答案,然後選擇最一致的答案作為最終輸出 。這通常需要在模型設定中調整相關參數(如溫度)。

RAG技術:利用外部知識減少幻覺

檢索增強生成( Retrieval Augmented Generation, RAG )是一種強大的技術,可以透過搜尋組織的私有數據來源或可信賴的外部知識庫,獲取與使用者提示相關的資訊,從而確保事實準確性,有效解決 AI 幻覺的問題 。

  • 操作方法:
  1. 建立知識庫:首先,需要建立一個包含您希望模型使用的可靠資訊的知識庫。這可以是內部文件、資料庫、或經過篩選的外部網站內容。
  2. 建立索引:對知識庫進行索引,使其能夠被快速有效地搜尋。這通常涉及到將文本轉換為向量表示(embedding)。
  3. 使用者提問:當使用者提出問題時,將問題轉換為向量表示。
  4. 檢索相關資訊:使用問題的向量表示在知識庫中搜尋最相關的資訊片段。
  5. 增強提示:將檢索到的相關資訊片段添加到原始的使用者提示中,形成一個增強的提示。
  6. 生成回應:將增強的提示輸入到 LLM 中,模型將利用檢索到的資訊來生成更準確的回應。
  • 範例:假設有一個關於公司產品的知識庫。當使用者詢問「這款產品的保固期是多久?」時, RAG 系統會先在知識庫中找到相關的保固資訊,然後將這些資訊加入到提示中,再讓 LLM 生成包含具體保固期限的回應。 ServiceNow 公司就使用 RAG 在產生文本之前從外部知識庫中檢索相關的 JSON 物件,確保生成過程基於正確且相關的數據。

驗證提示詞工程的有效性

提示詞工程已成為與 ChatGPT 等語言驅動工具進行有效溝通和互動的必要技能 。研究表明,在提示中提供範例的順序、自動指令生成和選擇方法可以顯著影響 LLM 的效能 。 AI 科學家正試圖透過檢索增強生成、微調和事實檢查等技術來限制 LLM 的幻覺 。 Andrew Ng 和其他 AI 專家已提出多項關鍵策略,可以顯著提高提示的有效性 。 OpenAI 一直在升級 ChatGPT ,以提高準確性及其拒絕回答未知問題的能力。百度創辦人李彥宏表示「大模型基本消除了幻覺」,顯示該領域取得了顯著進展。史丹佛大學的 Christopher Manning 討論了 LLMs 的實用性與因幻覺導致錯誤的風險之間的平衡 。史丹佛大學的 Percy Liang 強調了基礎模型驅動的 AI 典範轉移以及評估這些模型的重要性 。他的研究也探索了激活工程作為一種對齊方法,以防止產生有害輸出,如幻覺 。一項研究發現, LLMs 在法律環境中至少有58%的時間會產生幻覺,突顯了在未經監督的情況下整合的風險。

不同 LLMs 和任務之間幻覺程度的差異表明,提示詞工程技術的有效性也可能因特定模型和任務的複雜性而異。這就需要仔細的實驗和評估,以確定適用於不同情境的最佳提示策略。 OpenAI 對「過程監督」的關注,獎勵正確的推理步驟而不是僅僅獎勵最終答案,與連鎖思考提示的原則一致。這表明 AI 研究社群越來越認識到,透過結構化提示引導模型的思考過程是提高 LLM 輸出準確性並減少幻覺的關鍵。

溫度與上下文:微調提示以控制幻覺

LLMs 中的溫度設定會影響輸出的隨機性。較低的溫度(接近0)使輸出更具確定性和焦點,而較高的溫度(接近1)則增加創造力但也增加了產生幻覺的風險 。對於準確性至關重要的用例,保持較低的溫度(約為0或0.1)會產生更可靠的輸出 。

  • 操作方法:在與 LLM 互動時,找到溫度設定的選項(通常在API參數或介面設定中)。對於需要事實準確性的任務,將溫度設定調低。對於需要創造性的任務,可以適度提高溫度。
  • 範例:如果您希望模型提供關於某個科學事實的準確答案,請將溫度設定為接近0。如果您希望模型創作一首詩,則可以將溫度設定為0.7或更高。

在提示中提供足夠的上下文對於引導 LLM 並減少產生不相關或不準確輸出的機會至關重要 。指示 LLM 僅在其具有高度信心時才回應,或者在不確定時說「我不知道」,可以防止其用不可靠的資訊填補空白 。

操作方法:在您的提示中,提供所有必要的背景資訊,確保模型理解您的意圖。如果模型不確定答案,明確指示它回答「我不知道」或類似的語句 。

提示:

根據你所知的資訊,誰贏得了2020年夏季奧運會男子跳高比賽?

改進提示:

請根據你所知的資訊,盡可能真實地回答問題。如果你不確定答案,請說『對不起,我不知道』。問題:誰贏得了2020年夏季奧運會男子跳高比賽?

僅當額外內容的資料集小到足以放入單個提示中時,才可以在提示中添加額外資訊。對於較大的資料集,RAG技術更適合。

結語

提示詞工程是一個充滿活力和創新的領域,為大型語言模型的應用開闢了廣闊的前景。透過不斷探索和優化提示詞的設計方法,我們可以最大限度地發揮模型的潛能,提高生成品質和任務適用性 。未來的提示詞工程很可能與其他AI技術相結合,以構建更智慧、高效和人性化的人機互動系統。幻覺是 LLMs 的一個關鍵挑戰,正受到廣泛的研究關注 。一些研究表明,由於其統計性質,幻覺可能是 LLMs 固有的特性。儘管可能無法完全消除,但透過提示詞工程等技術來減輕幻覺對於構建可信賴的 AI 非常重要。提示範本可以透過提供結構、減少歧義和提供一致的格式來幫助降低產生幻覺的機會 。

即使完全消除幻覺在理論上可能證明是不可能的,但提示詞工程的進步正在顯著提高 LLMs 的可靠性和可信賴性。重點應放在開發和完善能夠在實際應用中最大限度地減少幻覺的發生和影響的技術上。提示詞工程的未來在於多方面的方法,結合了複雜的提示技術、強大的外部知識整合(如 RAG )、對 LLM 輸出進行持續監控和評估,以及更深入地理解導致幻覺的底層機制。這將需要研究人員、開發人員和使用者之間的合作,以建立最佳實踐和倫理準則,用於在現實世界中部署 LLMs 。透過掌握這些實戰技巧,將能夠更有效地利用 AI 大模型,並降低因幻覺帶來的風險。

表格 1:減少幻覺的提示詞工程技巧比較

技術名稱描述如何減少幻覺主要優點潛在限制
具體明確的提示 ( Clear and Specific Prompts )使用清晰、精確的語言描述期望的輸出。避免模型產生模糊或不相關的回應。易於實施,效果直接。需要仔細思考和設計提示。
結構化提示 ( Structured Prompts )使用標題、列表等方式組織提示。幫助模型理解輸入的不同部分,產生結構化的輸出。提高模型理解能力。對於簡單的查詢可能不必要。
提供上下文 ( Providing Context )提供背景資訊和相關細節。幫助模型理解問題的背景,產生更相關的回應。提高回應的準確性。需要收集和整理相關資訊。
少量樣本提示 ( Few-Shot Prompting )在提示中提供幾個輸入-輸出範例。引導模型學習期望的輸出格式和風格。無需額外訓練模型。範例的品質至關重要。
連鎖思考提示 ( Chain of Thought Prompting )要求模型逐步解釋其思考過程。鼓勵模型進行更深入的推理,減少直接跳到錯誤結論的可能性。適用於複雜的推理任務。模型可能產生看似合理但不正確的推理步驟。
驗證鏈 ( Chain of Verification, CoVe )模型生成初步答案後,再自行提出並回答驗證問題。透過自我驗證機制,提高答案的準確性。顯著減少事實錯誤。無法完全消除幻覺,尤其是在推理步驟中。
檢索增強生成 ( Retrieval Augmented Generation, RAG )在生成答案之前,先從外部知識庫檢索相關資訊。使模型能夠基於最新的和可靠的資訊生成答案,減少對模型內在知識的依賴。顯著提高事實準確性,適用於需要最新資訊的場景。需要建立和維護高質量的知識庫。

表格 2:溫度設定對 LLM 輸出的影響

溫度範圍輸出特性產生幻覺的可能性建議使用情境
低 (0 – 0.4)較具確定性、焦點集中、重複性高較低需要高度準確性的應用,例如醫療或法律領域。
中 (0.4 – 0.8)平衡確定性和創造力,連貫且與上下文相關,但具有一定的變異性中等一般用途,在準確性和創造性之間尋求平衡。
高 (0.8 – 1.0+)更多樣化、更具創造力、更隨機較高需要高度創造性的應用,例如詩歌、故事生成。

Midjourney V7 Alpha 版本震撼發布

Midjourney V7 範例 照片

備受期待的 AI 圖像生成服務 Midjourney 近日推出了最新版本— V7 。這距離其上一個主要版本的發布已將近一年,在競爭激烈的 AI 領域中,此舉無疑引發了廣泛關注。 V7 版本的發布時間,恰好與 OpenAI 在其 ChatGPT 平台中推出全新圖像生成器 4o Image Generation 之後不久,這使得市場競爭更趨白熱化。 Midjourney 團隊表示, V7 是一個完全重新打造的模型,擁有其獨特的優勢,但也可能存在一些需要使用者探索和適應的特性,特別是在 prompt 的設計上。

Midjourney V7 已於2025年4月4日(星期五)美國東部時間午夜前後開始以 alpha 測試版本向用戶推出。值得注意的是,在一些社群媒體平台如 Reddit 上,曾有討論指出該版本的目標發布日期為3月31日,但實際發布時間似乎有所延遲。這種時間上的差異在軟體開發過程中並不少見,通常是由於最後階段的測試或調整所致。此次 V7 以 alpha 版本先行發布,也暗示了 Midjourney 可能希望在全面推廣之前收集用戶的反饋並進行進一步的完善。

V7 版本帶來了多項令人矚目的新功能。其中最引人注目的便是全新的 Omni-Reference 功能,據稱該功能可以更好地理解和應用使用者提供的參考圖像,無論是標誌、人類或非人類角色,還是各種物體,都能夠更精確地融入到生成的圖像中。此外, V7 預計將在理解使用者輸入的 prompt 方面有顯著的提升,並能生成更連貫的圖像。更快的處理速度也是 V7 的一大亮點,這意味著使用者可以更快地看到他們的創意成果。然而,在 V7 的 alpha 版本初期,部分功能如圖像放大(upscaling)和局部重繪(in-painting)將暫時使用 V6 的版本,而 V7 專屬的版本預計將在不久的將來推出。同樣,一些進階參數如 weird 、 quality 、 tile 和 multi-prompting 等,可能不會在第一時間提供,但開發團隊承諾將在發布後的幾週內逐步添加這些功能。值得關注的是, V7 預計將採用一套全新的風格參考系統,但目前尚不清楚 V6 版本的 SREF 代碼是否能與之兼容。此外 V7 還可能引入更為先進的 3D 建模功能,包括生成更複雜和細緻的 3D 模型,以及改進的紋理和照明選項,甚至可能與現有的 3D 軟體實現更好的整合。 Midjourney 團隊的目標是讓 V7 能夠生成具有高度細節的美學風格,並能準確地呈現圖像中的面部、角色、標誌和各種物體。

相較於其前身 V6 , Midjourney V7 在多個方面都展現出了顯著的改進潛力。據相關資訊顯示, V7 有望提供更快的處理速度,更精緻且直觀的使用者介面,以及更高品質的圖像,包括更豐富的細節、更生動的色彩和更逼真的效果。 V7 還引入了更先進的圖像合成技術,並提供了更多樣化的濾鏡供使用者選擇。在設計上, V7 也更加精簡且響應迅速,有助於提升使用者的整體體驗。 V7 在理解使用者 prompt 方面的能力也得到了提升,能夠更準確地將文字描述轉化為視覺圖像。此外, V7 可能還會提供更直觀的圖像編輯控制功能,使用者可以直接在平台內進行編輯,從而簡化整體的創作流程。在圖像的細節呈現、空間關係的理解以及色彩的準確性方面, V7 也預計將有所提升。 一個值得注意的改進是 V7 在生成連貫文本方面的能力也得到了增強,這對於需要在圖像中加入文字的使用者來說是一個重要的進步。

目前來看,沒有明確的證據顯示 Midjourney V7 的發布會帶來新的訂閱方案或價格變動。 Midjourney 目前提供四種主要的訂閱方案,分別是 Basic 、 Standard 、 Pro 和 Mega ,價格從每月10美元到120美元不等。其中 Basic 方案每月10美元,提供有限的快速 GPU 時間; Standard 方案每月30美元,提供更多的快速 GPU 時間和無限的 Relax GPU 時間; Pro 方案每月60美元,提供更長的快速 GPU 時間以及一些額外功能,如隱身模式; Mega 方案則是每月120美元,提供最長的快速 GPU 時間和最多的並行任務處理能力。這些方案旨在滿足不同用戶的需求和預算。

早期使用者和專業評測對於 Midjourney V7 的看法呈現出多種不同的聲音。一些參與了早期評分的使用者在提交了超過2000個評分後表示, V7 在圖像品質和細節方面表現非常出色,即使在一張圖像中有多個角色,也能夠保持良好的細節呈現。然而也有意見指出,V7在文本顯示方面仍然存在不足,與 Ideogram 和 OpenAI 的 GPT-4o Image Generation 相比仍有差距,並且其對於 prompt 的準確性還有待進一步觀察。在 Reddit 等社群平台上,一些使用者分享了 V7 與 V6 的比較結果,部分人認為 V7 在某些方面有所改進,例如人像的真實感有所提升,但在整體圖像品質上並未看到顯著的飛躍,甚至有時候更偏愛 V6 的輸出。更有評論認為,整個 AI 圖像生成技術可能已經發展到了一個相對成熟的階段,未來難以再看到像早期那樣巨大的品質提升。一些使用者表達了對於 V7 能夠帶來更好的 prompt 準確性、更強的文本渲染能力以及更易於新手使用的“簡單模式”的期望。值得肯定的是有評論指出 V7 在生成人像時的“粗糙感”有所減輕,這被認為是一個積極的改進。

作為最早的AI圖像生成服務之一, Midjourney 在該領域一直佔據著重要的地位。然而隨著技術的發展,市場競爭也日趨激烈。 Midjourney 的主要競爭對手包括 OpenAI(其 DALL-E 系列以及集成在 ChatGPT 中的圖像生成器)、 Stability AI 的 Stable Diffusion 、 Ideogram 以及 FLUX 等。 Midjourney 一直以來都以其獨特的藝術風格和卓越的創意生成能力而聞名,儘管在 prompt 的準確性方面可能不如某些競爭對手。 V7 的推出被廣泛認為是Midjourney在競爭日益激烈的市場中重新確立其領先地位的重要機會。

Midjourney V7 的發布預計將對整個 AI 圖像生成市場產生積極的影響。它的推出可能會刺激該領域的進一步創新,促使其他競爭對手也加快推出更先進的功能和模型。市場對於更高品質、更逼真圖像的需求持續增長,而 V7 的推出恰好迎合了這一趨勢。儘管 V7 可能尚未完全實現,但 Midjourney 對於影片生成領域的探索也預示著 AI 圖像生成技術未來將朝向多媒體內容發展。

實際測試

寫實照片

Prompt

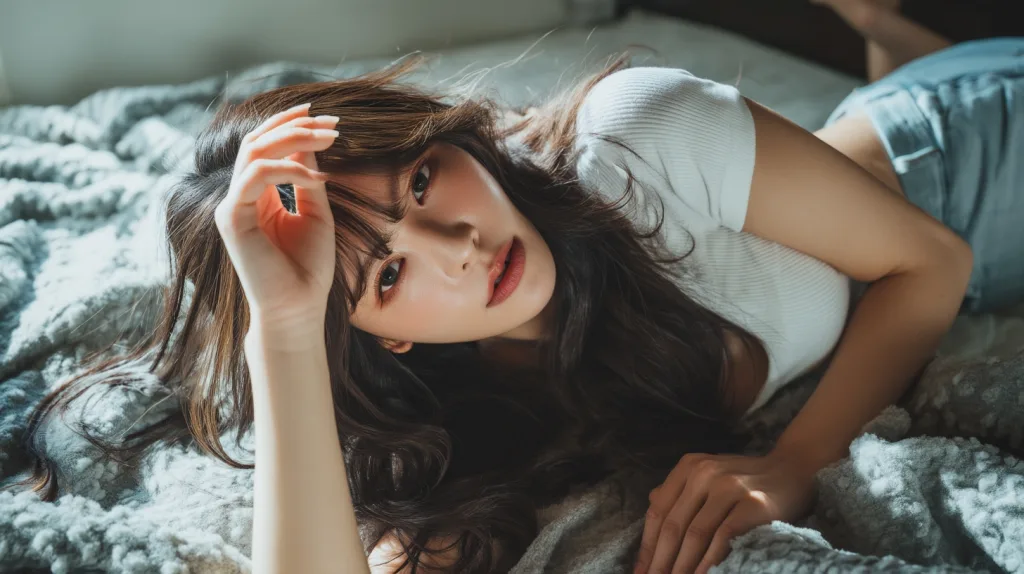
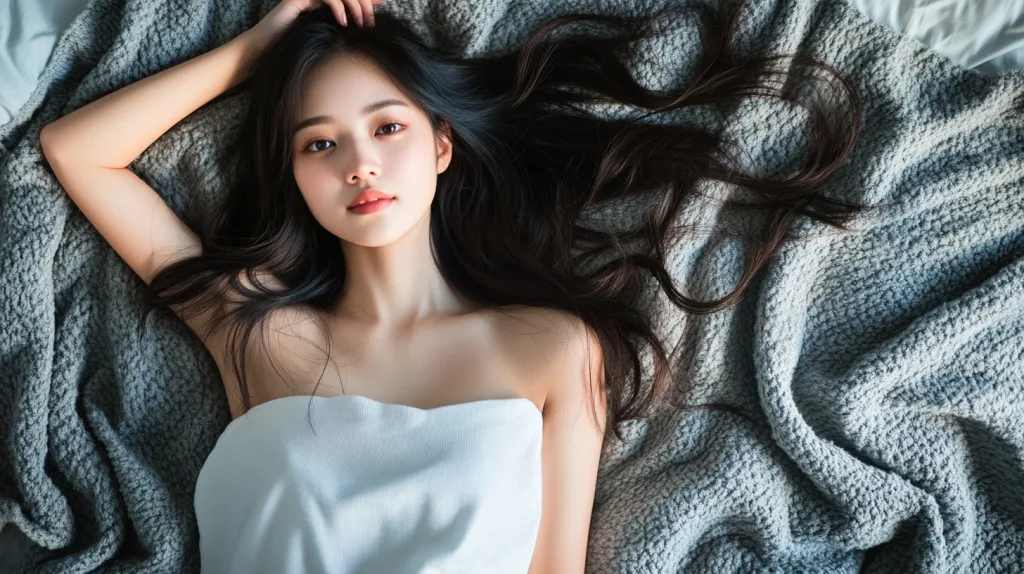
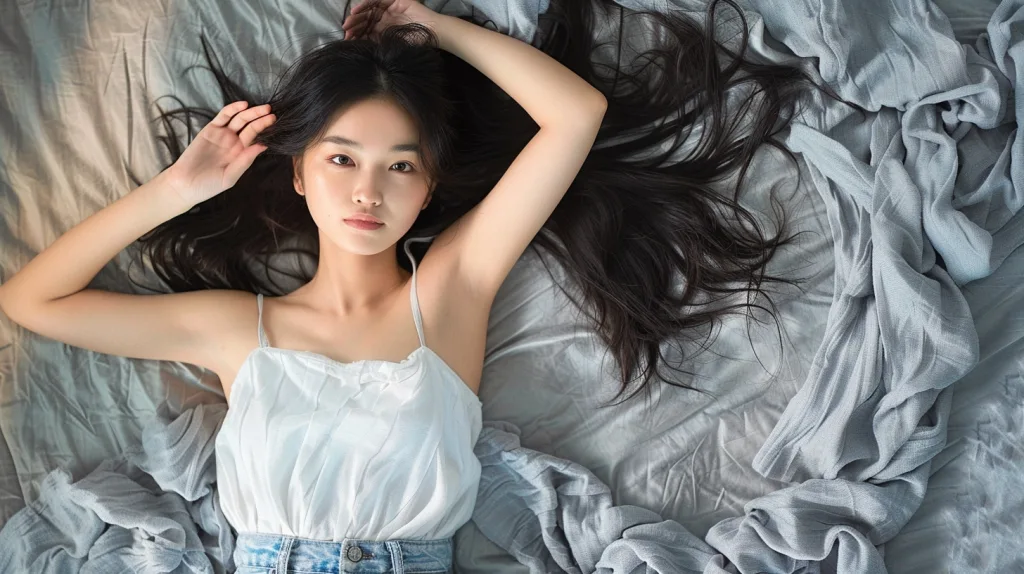
A young Taipei woman lies comfortably on a cozy, textured gray blanket spread over a bed, with soft natural light illuminating the scene. Her long, dark hair is styled in loose waves, framing her face and cascading over her shoulders. She wears a simple white top paired with light blue jeans, creating a casual yet stylish look. Her left hand is gently placed on her forehead, with her fingers slightly curled and relaxed, while her right hand rests naturally by her side. Her fingers are slender and well-defined, with neatly trimmed nails. The woman’s expression is serene and thoughtful, with her gaze directed towards the camera. The background is softly blurred, emphasizing the focus on her face and upper body. The lighting is diffused, casting subtle shadows that enhance the texture of the blanket and her clothing. The overall composition is intimate and inviting, capturing a moment of quiet reflection. SONY FX3, Sony FE 50mm F1.2 GM. –no extra fingers, missing fingers, mutated hands, deformed hands, mirrored hands, missing arms, missing legs, deformed hands, extra fingers, distorted fingers, broken hands, fused fingers, long fingers, misshapen hands, extra limbs, disfigured hands, flat chest, low pixels –s 50 –style raw

一位年輕的台北女子舒適地躺在一張床上舖著的有質感的灰色毛毯上。柔和的自然光照亮了整個場景。她烏黑的長髮呈現自然的波浪捲,勾勒出她的臉龐,垂落在她的肩膀上。她穿著一件簡單的白色上衣,搭配淺藍色牛仔褲,營造出休閒又時尚的造型。她的左手輕輕地放在額頭上,手指微微彎曲且放鬆,而右手自然地放在身邊。她的手指纖細修長,指甲修剪得整齊。女子的表情寧靜而若有所思,目光直視著鏡頭。背景微微模糊,強調了對她的臉部和上半身的聚焦。光線柔和散射,投下微妙的陰影,增強了毛毯和她衣服的質感。整體構圖親密而吸引人,捕捉了一個寧靜沉思的瞬間。

V7(指令理解、人物皮膚、影像細節及情境表現力最佳,真人還原度高)

Midjourney V7 範例 照片

註:筆者實際測試後,新版本雖然手指的問題降低許多,但是仍然還是沒有完全改善老毛病,即使增加負向提示詞仍然需要多次抽卡才能生成滿意的照片。希望官方在未來的版本能夠積極改善這個問題。此外, Midjourney V7 預設強制使用個人化風格,如果想要使用 V7 原生的圖像風格的話在提示詞後方加入 --p none 參數即可。

V6.1(指令理解一般,藝術表現最佳,皮膚紋理表現較弱)

Midjourney v6.1 範例 照片

V6(指令理解一般,偏向寫實及復古,皮膚細節介於6.1與7之間,藝術感較弱)

Midjourney V6 範例 照片

結論:在照片生成類別中,其實三個模型版本各有特色。端看使用者的用途而定。如果追求真實感及要求指令細節的使用者最佳選擇一定是 V7 。

藝術

Prompt

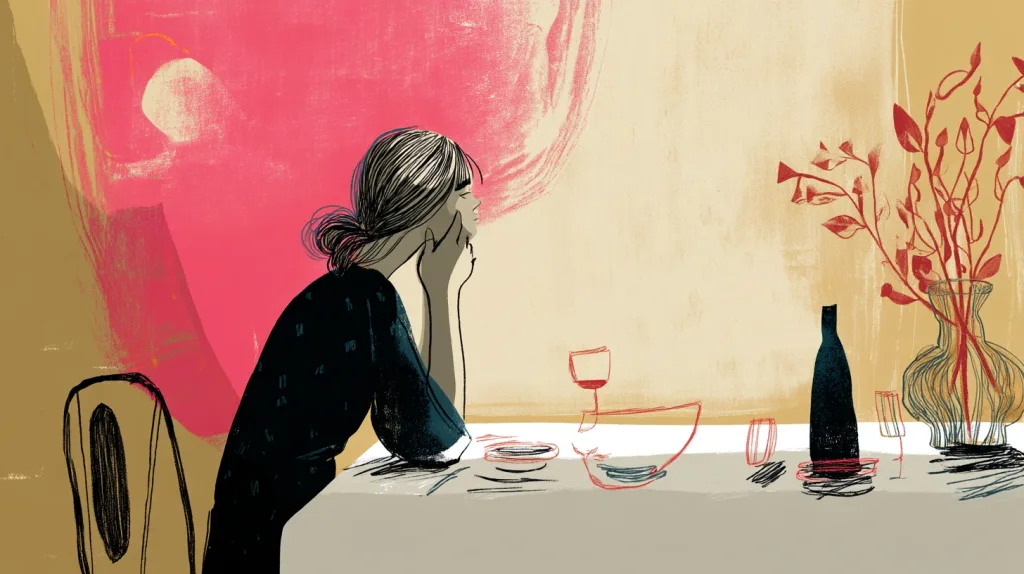
A woman sitting quietly at the table and lost in thought by Christoph Niemann. –s 50 –style raw

克利斯多福·尼曼(Christoph Niemann)所繪的一名女子靜靜地坐在桌前陷入沉思。

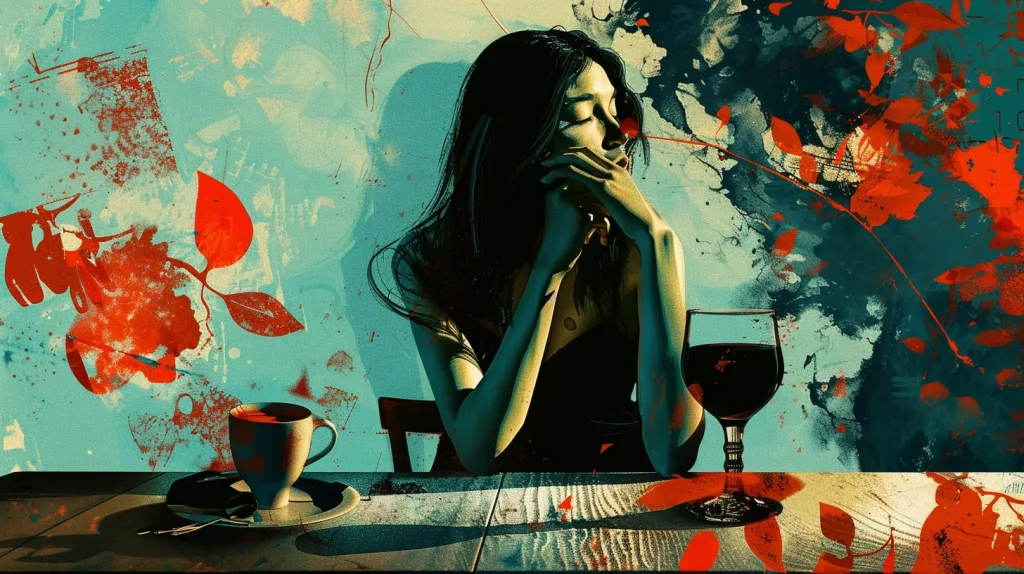
V7

Midjourney V7 範例 藝術

V6.1

Midjourney V6.1 範例 藝術

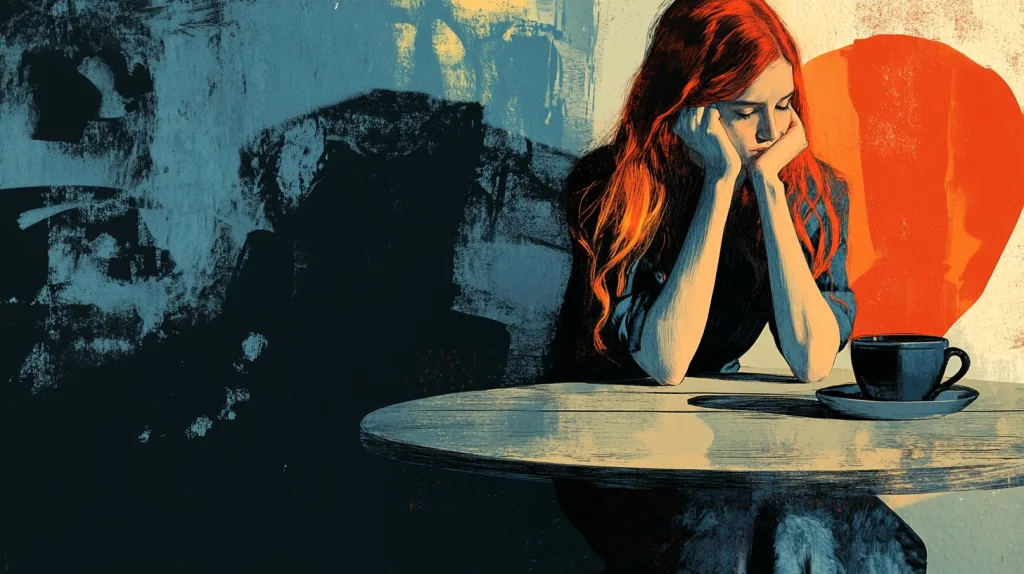
V6

Midjourney V6 範例 藝術

結論:在藝術風格上, V7 偏向靜謐的哀愁,流露出淡淡的回憶與孤單;V6.1 表現出現實中的壓抑與自我拉扯,顏色對比強化了內在掙扎;V6 情感張力最強,色彩和線條都充滿張力,暗示著難以平息的內心波動。三幅畫都以孤獨為核心,但 V7 偏向內斂,V6.1 著重現實的壓力, V6 則更加強烈地表達情感崩解。這些畫面透過色彩、構圖和畫風的變化,巧妙地傳達出孤獨的不同面向與層次。使用者可以根據自己比較偏好的藝術風格挑選適合的版本創作。

文字

Prompt

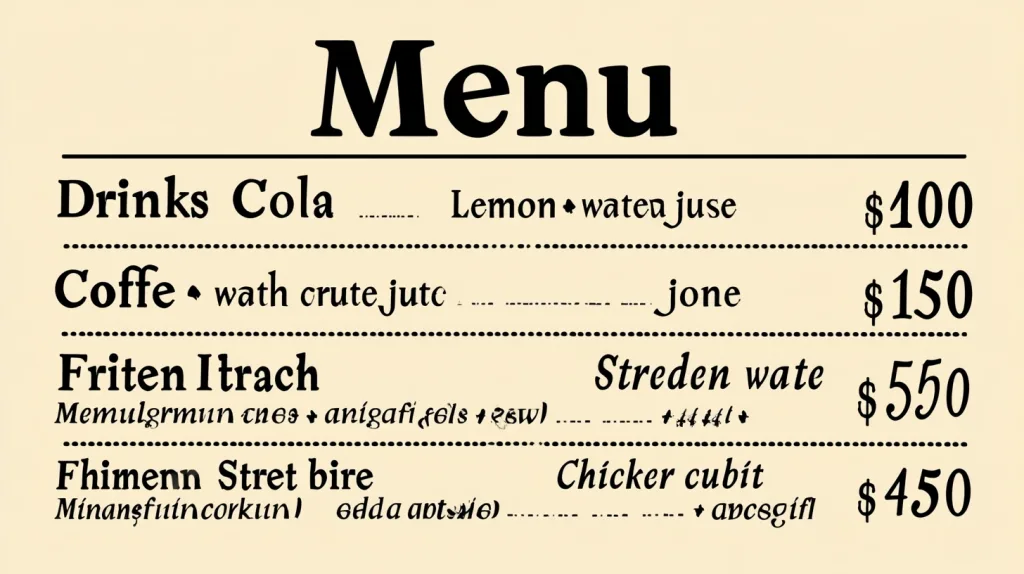
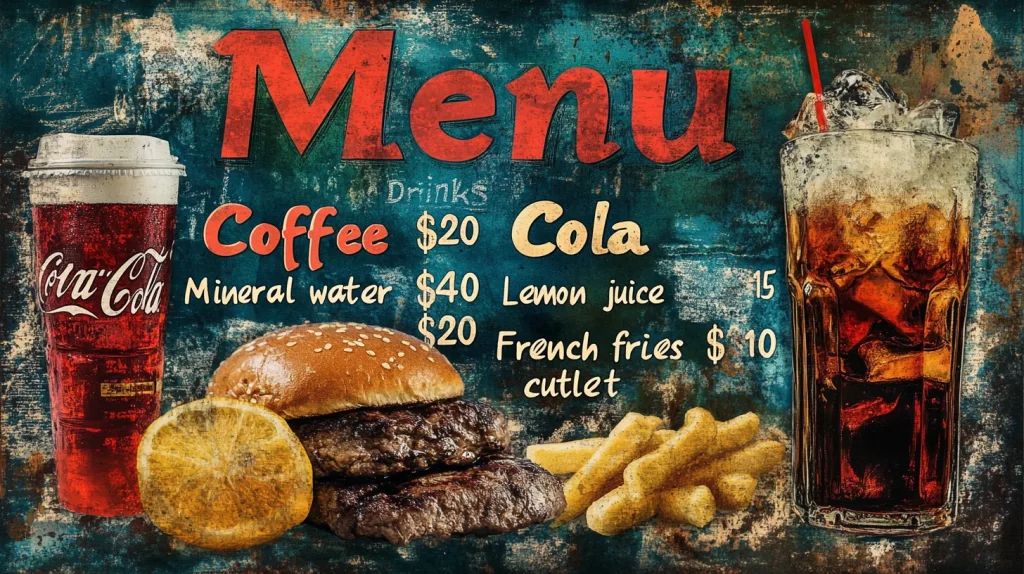
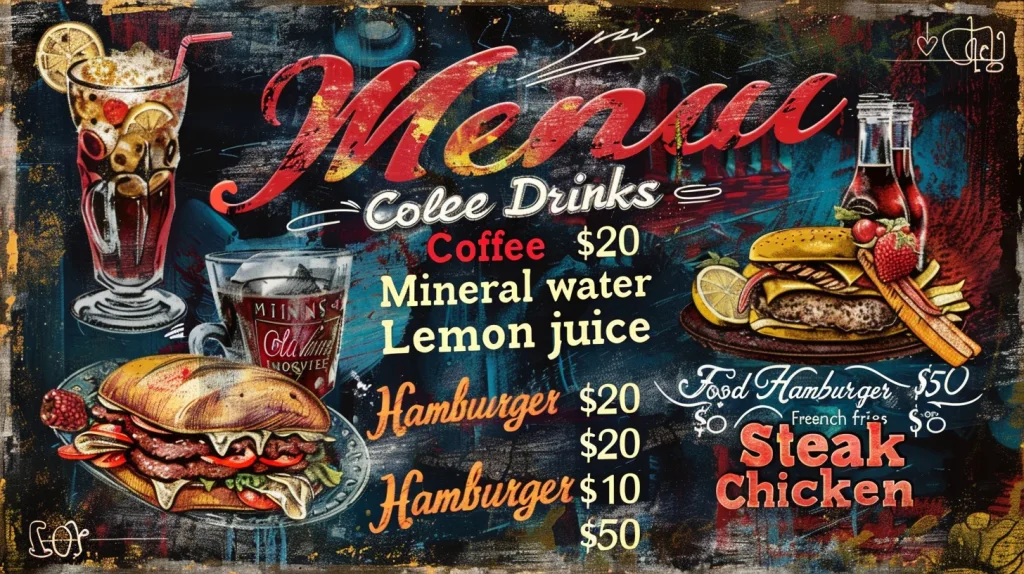
A restaurant menu in retro style. The words on the menu are as follows: At the top center, in bold large font, is the headline “Menu”. On the left side below are the words in sequence: “Drinks” (in bold font), “Cola $20”, “Coffee $40”, “Mineral water $15”, “Lemon juice $20”. On the right side below are the words in sequence: “Food” (in bold font), “Hamburger $50”, “Steak $80”, “French fries $10”, “Chicken cutlet $50”. –s 50 –style raw

一個復古風格的餐廳菜單,菜單上的文字分別是: 上方中央粗體字大標題 “菜單”,下方左排文字依序是”飲料”(粗體字),”可樂 $20″,”咖啡 $40″,”礦泉水 $15″,”檸檬汁 $20″,下方右排文字依序是”食物”(粗體字),”漢堡 $50″,”牛排 $80″,”薯條 $10″,”雞排 $50”

V7

Midjourney V7 範例 文字

V6.1

Midjourney V6.1 範例 文字

V6

Midjourney V6 範例 文字

結論:文字呈現一向 Midjourney 最大的弱點之一,即使到了 V7 官方仍然沒有解決這個問題。所以如果各位讀者有文字及排版的需求,筆者還是建議先透過 Midjourney 產生底圖之後再透過 PS 或 Canva 等工具進行二次處理。

進一步閱讀
  1. ​Midjourney 將 sref V7 設為預設
  2. Midjourney V7 大幅提速,生成成本腰斬,推出新實驗模式
  3. Midjourney V7 優化準確性及手部呈現,並推出 exp 實驗性參數
  4. Midjourney V7 推出全新編輯器與 Weird 參數
  5. Midjourney V7 持續升級:導入 V6 熱門功能、AI 輔助提示與用戶回饋加速進化

科技巨頭 Anthropic 在 AI 版權戰中首傳捷報,法院駁回環球音樂等公司禁令申請

科技巨頭 Anthropic 在 AI 版權戰中首傳捷報,法院駁回環球音樂等公司禁令申請

生成式人工智能(AI)的版權爭議持續升溫,科技公司與版權所有者之間的法律角力備受矚目。近日備受矚目的 AI 新創公司 Anthropic 在與環球音樂集團(Universal Music Group, UMG)、Concord Music Group 及 ABKCO Music & Records 等主要音樂出版商的訴訟中取得初步勝利。加州聯邦法院駁回了這些音樂出版商提出的初步禁令申請,該禁令旨在阻止 Anthropic 使用其擁有的歌詞來訓練其 AI 模型 Claude 。這項裁決被視為 AI 產業在應對版權挑戰方面的一個重要里程碑,也為未來 AI 的發展和版權法律的互動帶來了深遠的影響。

這起訴訟的核心在於音樂出版商指控 Anthropic 未經授權使用了數百首歌曲的歌詞來訓練其 AI 模型。根據訴訟文件,Anthropic 被指控使用了至少 500 首歌曲的歌詞,其中包括碧昂絲(Beyoncé)、滾石樂隊(The Rolling Stones)和海灘男孩(The Beach Boys)等知名藝人的作品。音樂出版商認為,Anthropic 的這種行為構成了版權侵權,並損害了他們未來授權其內容的能力 。他們強調,未經許可地使用受版權保護的材料來訓練 AI 模型,相當於對創作者的「盜竊」。

面對音樂出版商的強烈指控,Anthropic 則辯稱其使用歌詞進行 AI 模型訓練的行為屬於美國版權法中的「合理使用」(fair use)範疇。 Anthropic 認為,其 AI 模型 Claude 並非直接複製或儲存歌詞,而是對其進行分析,以理解和模仿人類語言的模式,從而產生原創的輸出。這種使用方式被 Anthropic 視為具有「轉化性」(transformative),為原始材料增加了新的表達或意義,因此應受到「合理使用」原則的保護。這場法律爭議不僅關乎 Anthropic 本身,也牽動著整個 AI 產業對於如何合法使用受版權保護資料的敏感神經。

在訴訟過程中,音樂出版商向法院申請初步禁令,要求在案件審理期間阻止 Anthropic 繼續使用其歌詞來訓練 AI 模型。然而,美國加州北區地方法院法官 Eumi K. Lee 在 2025 年 3 月 25 日駁回了這一請求。法官在裁決中列出了多項理由,解釋了為何拒絕頒布這項臨時禁令。

首先,法官認為音樂出版商未能充分證明 Anthropic 的行為對他們造成了「無法彌補的損害」(irreparable harm),這是獲得初步禁令的先決條件之一。法官指出,音樂出版商提供的證據顯示,AI 訓練授權市場正在成長,這意味著即使他們最終贏得訴訟,所遭受的任何損失都可以通過金錢賠償來彌補。換句話說,法院認為,如果 Anthropic 確實侵犯了版權,音樂出版商可以通過後續的損害賠償訴訟來獲得經濟上的補償,而無需在現階段阻止 Anthropic 的 AI 模型訓練。

其次,法官對音樂出版商提出的禁令範圍表示擔憂,認為其要求過於寬泛和模糊。音樂出版商的律師在聽證會上未能明確說明有多少歌曲將受到禁令的約束,並且沒有提供具體的方法讓 Anthropic 能夠確定禁令的範圍或遵守其條款 。法官強調,禁令請求中包含的作品範圍似乎不斷擴大,這引發了關於禁令的可執行性和可管理性的重大疑慮。

此外,法官還提及,本案的核心法律問題,即使用受版權保護的內容訓練 AI 是否構成「合理使用」,尚未有明確的法律判決。法官認為,音樂出版商實際上是要求法院在「合理使用」這個基本問題尚未解決的情況下,就定義 AI 訓練授權市場的輪廓。法院在這個階段不願界定一個新的授權市場,特別是在關於 AI 訓練是否屬於「合理使用」的法律界限尚不明確的情況下。

最後法官指出,音樂出版商並未請求法院頒布一個範圍更窄的禁令,例如僅針對訴訟中最初指出的 500 首歌曲。由於音樂出版商提出的禁令範圍過於廣泛,法院認為不適合自行頒布一個範圍更小的禁令。

值得注意的是,法院的這項裁決僅針對初步禁令的申請,並未對 Anthropic 是否構成版權侵權或其行為是否屬於「合理使用」做出最終判決。這些核心法律問題將在未來的訴訟程序中進一步審理。儘管如此,法院駁回禁令申請的決定,對於 Anthropic 而言,無疑是一次重要的初步勝利。

法院的這項裁決具有廣泛的意義和影響,不僅對 Anthropic 本身,也對整個 AI 產業和未來的版權法律產生了深遠的影響。

就 Anthropic 而言,短期內,他們可以繼續使用包括受版權保護歌詞在內的資料來訓練其 AI 模型 Claude,而不會受到立即的法律限制。這對於 Anthropic 繼續開發和改進其 AI 技術至關重要,讓他們能夠在無需立即重新訓練模型或限制訓練資料的情況下保持競爭力。然而,從長遠來看,這場版權侵權訴訟仍在進行中,Anthropic 仍然面臨被判侵權並支付巨額賠償金的風險。這次裁決突顯了 Anthropic 提出的「合理使用」辯護的重要性,他們很可能將繼續依賴這一原則來應對後續的法律挑戰。除此之外 Anthropic 已經實施了「防護措施」(guardrails),以防止 Claude 在其輸出中直接複製受版權保護的歌詞。這種積極主動的措施可能在一定程度上影響了法院對初步禁令的考量。 Anthropic 在積極捍衛其使用版權材料進行訓練的權利的同時,也願意採取措施防止直接的版權侵權,這反映了其在複雜的法律環境中採取的策略性做法。

對於整個 AI 產業而言,這項裁決可能被視為一個積極的信號。許多 AI 公司,包括 OpenAI、Meta 和微軟等,都面臨著類似的版權訴訟。法院駁回針對 Anthropic 的初步禁令,可能暗示著版權所有者在試圖通過初步禁令來阻止 AI 公司使用受版權保護資料進行訓練方面,可能會面臨挑戰,尤其是在他們無法證明「無法彌補的損害」的情況下。然而,這並不意味著 AI 公司可以完全免除版權責任。關於版權侵權和「合理使用」的基本法律問題仍然懸而未決。 AI 公司仍然需要謹慎對待使用受版權保護的資料進行訓練,並可能需要探索授權選項或開發替代的訓練資料集。此案也凸顯了迫切需要更清晰的法律框架,甚至可能需要新的立法來應對 AI 和版權法帶來的獨特挑戰。全球的監管機構可能會密切關注此案的進展。

在「合理使用」原則方面,儘管法官 Lee 並未明確就此做出裁決,但她拒絕頒布禁令的決定表明,在「合理使用」問題得到充分審理之前,法院對於基於版權考量來限制 AI 訓練活動可能會採取謹慎的態度。 Anthropic 的辯護很大程度上依賴於其使用受版權保護的歌詞進行 AI 訓練屬於「轉化性使用」,因此符合「合理使用」原則 。他們認為,其 AI 模型並非簡單地複製歌詞,而是對其進行分析以理解語言模式並生成原創的輸出。法院在裁決中提到 AI 訓練背景下「合理使用」原則的不確定性,表明這將是正在進行的訴訟以及未來涉及 AI 的版權糾紛中的一個核心問題。此案的結果可能會對「合理使用」原則在應用於 AI 技術時的解釋和適用方式產生重大影響。這凸顯了傳統版權法(為人類創作者和更直接的複製形式而設計)與 AI 的新現實(AI 從龐大的資料集中學習以創造新穎的輸出)之間的張力。在這種背景下對「合理使用」的解釋,對於平衡版權所有者的權利與 AI 創新的潛力也是很重要的。

環球音樂集團和其他音樂出版商對法院的裁決表示失望,但他們強調將繼續對 Anthropic 提起更廣泛的訴訟,並積極尋求貨幣賠償。他們在一份聲明中指出,法院駁回禁令申請是基於一個狹隘的理由,即他們所遭受的任何損失最終都可以通過金錢賠償來彌補,而他們打算「積極尋求」這些賠償。音樂出版商認為,此案對於保護創作者免受 Anthropic 和其他 AI 公司對其受版權保護作品的「大規模盜竊」至關重要。他們預計,隨著案件的進展和全面證據記錄的建立,他們的訴訟請求將得到驗證。法院也批准了音樂出版商提出的證據開示請求,允許他們獲取 Anthropic 的 Claude 模型在 2023 年 9 月至 2024 年 3 月期間的提示和輸出記錄的「具有統計學意義的樣本」。這項裁決將使音樂出版商能夠更深入地了解 Anthropic 如何使用其歌詞,並可能為他們的訴訟提供更有力的證據。音樂出版商的回應表明,他們至少在目前將戰略從試圖立即阻止 Anthropic 的訓練活動轉向建立一個強有力的財務賠償案例。法院批准證據開示表明,法官希望確保出版商有機會在訴訟的後期階段建立他們的索賠。出版商使用的強烈措辭「大規模盜竊」顯現他們對 AI 公司未經許可使用受版權保護材料的擔憂程度。

法律學者和業界人士普遍認為,Anthropic 案突顯了當前版權法在應用於 AI 訓練時所面臨的不確定性。關於 AI 訓練是否構成「合理使用」的爭論仍在繼續,一方認為這是一種具有轉化性的使用,通過促進創新來造福公眾,而另一方則認為這是一種侵犯版權的行為,損害了創作者的權利。這項裁決的法律啟示在於,它可能影響未來法院在類似案件中的判決,並可能促使立法機構修改版權法以應對 AI 帶來的挑戰。一些專家可能將此視為 AI 發展的勝利,而另一些專家則可能對其對創意產業的潛在影響表示擔憂。缺乏明確的法律先例意味著法院正在探索一個新的領域。專家們對於「合理使用」應如何應用於 AI 訓練可能持有不同意見,這反映了通過版權保護來激勵創造力與促進技術創新之間的根本衝突。此案可能成為一個試驗案例,有助於塑造 AI 和智慧財產權的法律格局。法律的不確定性可能導致持續的訴訟,並可能促使立法機構制定專門針對 AI 和版權的法律。這可能導致 AI 訓練資料的新授權模式的出現,或者重新定義數位時代的「合理使用」。法律專家在此領域的意見對於指導決策者和法院如何平衡智慧財產權保護與人工智慧領域的創新非常重要。

Anthropic 版權訴訟中的主要論點

音樂出版商要求禁令的論點Anthropic 反對禁令的論點法官 Lee 駁回禁令的原因
Anthropic 使用受版權保護的歌詞進行 AI 訓練構成版權侵權。他們使用受版權保護的歌詞進行 AI 訓練屬於「合理使用」,特別是轉化性使用。出版商未能證明其遭受了無法彌補的損害。
這種使用對他們現有的和未來的授權市場造成了無法彌補的損害。出版商未能證明其遭受了無法彌補的損害。AI 訓練授權市場正在成長,暗示潛在的貨幣賠償。
在訴訟進行期間,應阻止 Anthropic 繼續這種行為。禁令請求過於寬泛和模糊。禁令請求過於寬泛和定義不明確。
他們已經實施了「防護措施」以防止侵權輸出。「合理使用」這個核心問題尚未解決。
出版商沒有請求範圍更窄的禁令。

Anthropic 裁決的潛在影響

影響
對 Anthropic短期:可以繼續使用受版權保護的歌詞進行訓練。長期:在基礎訴訟中仍面臨貨幣賠償的風險;將繼續依賴「合理使用」的抗辯。
對 AI 產業可能暗示法院不願輕易頒布針對 AI 訓練的初步禁令。突顯了謹慎行事和潛在授權的必要性。強調了迫切需要更清晰的法律框架。
對版權所有者在 AI 版權案件中證明「無法彌補的損害」可能具有挑戰性。重點可能轉向尋求貨幣賠償和開發授權模式。可能推動版權法的立法變革。
對「合理使用」原則此案可能顯著影響在 AI 訓練背景下對「合理使用」的解釋。「轉化性使用」的論點將受到密切審查。

結語

法院駁回環球音樂等公司對 Anthropic 的禁令申請,是這場 AI 版權大戰中的一個重要轉折點,也是 Anthropic 的一次初步勝利。然而,這場法律戰遠未結束,關於 AI 使用受版權保護資料進行訓練是否構成侵權,以及是否屬於「合理使用」的根本性法律問題仍有待解決。此案的發展和最終判決,無疑將對 AI 產業的未來走向、版權法律的適用以及科技創新與智慧財產權保護之間的平衡產生深遠的影響。可以預見的是,圍繞 AI 和版權的法律爭議將在未來持續不斷,並可能催生新的法律解釋和行業規範。

Google 推出 Gemini 2.5 Pro :號稱「最聰明」 AI 模型

Google發布Gemini 2.5 Pro

Google 今日宣布推出最新的 AI 模型 Gemini 2.5 Pro,這款實驗性模型被公司內部譽為「最聰明」的 AI,並在多項業界標準的基準測試中取得了領先地位。 Gemini 2.5 Pro 的發布,標誌著 Google 在 AI 領域的持續創新和對更高性能模型的追求,處理日益複雜的問題並支援更強大的 AI 應用。

開發者與進階用戶搶先體驗

根據官方資訊, Gemini 2.5 Pro Experimental 於2025年3月25日正式發布。目前,開發者可以透過 Google AI Studio 體驗這款最新的模型。同時,訂閱 Gemini Advanced 的用戶也能在 Gemini 應用程式中選用 Gemini 2.5 Pro 。 Google 計劃在未來幾週內將 Gemini 2.5 Pro 整合到 Vertex AI 平台,進一步擴大其可用性。至於 Gemini 2.5 Pro 的具體定價策略, Google 則承諾將在未來幾週內正式對外公布。

強大的推理能力與多模態處理

Gemini 2.5 Pro 被描述為一款「思考模型」,其核心特性在於能夠在回應之前進行內部推理,從而顯著提升其性能和準確性。這種設計使其在需要複雜推理的基準測試中表現出色,例如在數學和科學領域的 GPQA 和 AIME 2025 測試中均處於領先地位。此外, Gemini 2.5 Pro 在程式碼能力方面也展現出強勁的實力,擅長創建視覺上引人注目的 Web 應用程式和代理程式碼應用程式,並能高效地進行程式碼轉換和編輯。在 SWE-Bench Verified 基準測試中, Gemini 2.5 Pro 在自訂代理設定下取得了63.8%的優異成績。

與先前的 Gemini 模型一樣,2.5 Pro 也具備原生多模態能力,能夠理解和處理來自文本、音訊、圖像、影片甚至整個程式碼儲存庫等多種來源的資訊。值得一提的是, Gemini 2.5 Pro 的上下文視窗初始版本支援100萬個 token , Google 並計劃很快將其擴展至200萬個 token ,這使其能夠處理龐大的資料集和複雜的問題。此外, Gemini 2.5 Pro 的輸出 token 限制也大幅提升至64,000,相較於先前版本的8,192有顯著的提升。

多項指標領先競爭對手

Gemini 2.5 Pro 在多項關鍵基準測試中展現了卓越的性能,直接挑戰了 OpenAI 的 GPT-4.5 和 Anthropic 的 Claude 3 等頂尖模型。以下表格總結了 Gemini 2.5 Pro 在部分基準測試中的表現,並與其他模型進行了比較:

基準測試 (Benchmark)Gemini 2.5 Pro Experimental (03-25)OpenAI o3-mini HighOpenAI GPT-4.5Claude 3.7 Sonnet 64k Extended thinkingGrok 3 Beta Extended thinking
Humanity’s Last Exam (無工具)18.8%14.0%6.4%8.9%–
GPQA Diamond (科學,單次嘗試)84.0%79.7%71.4%78.2%80.2%
AIME 2025 (數學,單次嘗試)86.7%86.5%–49.5%77.3%
SWE-Bench Verified (代理程式碼)63.8%49.3%38.0%70.3%–
MMMU (視覺推理,單次嘗試)81.7%無多模態支援74.4%75.0%76.0%
MRCR (長上下文,1M tokens)83.1%36.3% (128k)48.8% (128k)––
Global MMLU (Lite) (多語言效能)89.8%––––

數據顯示, Gemini 2.5 Pro 在多項關鍵基準測試中均取得了領先地位,尤其是在科學推理(GPQA Diamond)和數學(AIME 2025)方面表現突出。其在Humanity’s Last Exam(一項旨在測試AI模型高階推理能力的基準)中獲得的18.8%的成績,也顯著優於其他競爭模型。此外, Gemini 2.5 Pro 在長上下文理解和處理方面也展現出強大的能力(MRCR)。儘管在某些特定領域,例如代理程式碼(SWE-Bench Verified)方面, Claude 3.7 Sonnet 的表現略勝一籌,但在整體上, Gemini 2.5 Pro 的基準測試結果證明了其作為一款頂尖 AI 模型的實力。值得注意的是, Google 強調其基準測試結果是在沒有使用如多數投票等增加成本的測試時間技術下取得的。

與前代模型的比較

相較於 Google 之前的模型, Gemini 2.5 Pro 在多個方面都展現出顯著的進化。與 Gemini 2.0 Pro 相比, 2.5 Pro 的知識截止日期更新至2025年1月,而 2.0 Pro 的知識則停留在2024年8月。更重要的是, Gemini 2.5 Pro 被明確定位為一款「思考模型」,具備更強大的推理能力,這使其在處理複雜任務時更具優勢。在應用方面, Gemini 2.5 Pro 在創建 Web 應用程式和代理程式碼應用程式方面表現更為出色。

儘管 Gemini 2.5 Pro 的初始上下文視窗為100萬個 token ,略小於 Gemini 2.0 Pro 和 1.5 Pro 的200萬個 token,但其顯著提升的輸出 token 限制(64,000 vs. 8,192)使其在需要生成大量文本的場景中更具優勢。與 Gemini 1.5 Pro 相比, 2.5 Pro 的訓練數據更新至2025年3月,而 1.5 Pro 的數據則停留在2024年8月。此外,在視覺推理基準測試 MMMU 中, Gemini 2.5 Pro 的表現也優於1.5 Pro 。這些改進表明, Google 在不斷迭代 Gemini 系列模型,更側重於提升模型的核心能力,使其能夠更好地理解和解決複雜問題。

開發者與企業的強大助力

Gemini 2.5 Pro 的目標受眾主要包括 AI 開發者和需要處理複雜任務的企業用戶。其強大的編碼能力可以幫助開發者更有效率地生成程式碼、進行除錯,並在開發過程中提供即時協助。對於企業而言, Gemini 2.5 Pro 的多模態處理能力和長上下文視窗使其能夠應用於複雜的資料分析、內容創作和提升對話式AI的品質。例如,該模型可以分析大量的產品照片、總結冗長的會議記錄,並處理複雜的商業文件。此外,其在理解圖像和音訊方面的能力,也為更廣泛的應用場景打開了大門。

Google 優先向開發者和付費的 Gemini Advanced 用戶提供 Gemini 2.5 Pro ,這表明其希望首先獲得這些核心用戶群的回饋,並鼓勵在開發和進階應用場景中的使用。 Gemini 2.5 Pro 的多功能性使其能夠應用於軟體開發、資料分析、內容創作和對話式 AI 等多個領域,顯示其廣泛的潛在市場。

結語

Gemini 2.5 Pro 的推出無疑是 AI 領域的一個重要里程碑。其強大的效能和先進的功能,特別是在推理、編碼和多模態處理方面的卓越表現,有望推動各行各業的創新。開發者和企業可以利用 Gemini 2.5 Pro 打造更智能、更強大的應用程式和服務,從而提升生產力並創造新的價值。隨著 Google 持續投入 AI 研發, Gemini 2.5 Pro 的發布無疑將加劇 AI 領域的競爭,並推動整個行業向前發展。

OpenAI 的 ChatGPT 4o 大幅提升圖像生成能力,加劇與 Google 及其他公司的 AI 競賽

OpenAI 的 ChatGPT 4o 大幅提升圖像生成能力,加劇與 Google 及其他公司的 AI 競賽

OpenAI 於2025年3月25日宣布在其旗艦產品 ChatGPT 中推出原生圖像生成功能,這項技術由其最新的 GPT-4o 模型提供支持。此舉標誌著 OpenAI 在發展真正多模態 AI 的道路上邁出了重要一步,將文字、圖像以及未來可能出現的其他模態無縫整合。更重要的是,這項功能的推出直接挑戰了 Google 近期在其 Gemini 中整合圖像生成能力的舉措,預示著 AI 領域一場新的激烈競爭正在上演。

YouTube thumbnailYouTube icon
影片來源:OpenAI

GPT-4o 中的 “o” 代表 “omni”(全能),突顯了該模型處理多種數據類型的能力 。這體現了 OpenAI 創建一個能夠理解和生成跨不同模態內容的統一模型的雄心,有望帶來更直觀和強大的 AI 互動體驗。將這項功能原生整合到廣泛使用的 ChatGPT 平台中,可能會使先進的圖像生成能力普及到更廣泛的用戶群體。

這項發布的時間點,緊隨 Google 的 Gemini 更新之後,暗示了這是一場競爭性的回應,也是兩家公司爭奪多模態 AI 領域主導地位的競賽。Google 率先宣布了 Gemini 的圖像生成功能,而 OpenAI 則迅速跟進,在其核心產品中推出了類似但可能更深入整合的功能。這種快速連續的發布表明了兩者之間直接的競爭態勢。此外,OpenAI 強調其圖像生成是「有用的」,而不僅僅是「美麗的」,這表明他們的目標已超越了純粹的藝術或新奇應用,轉向在溝通、商業和教育領域的實際用途。OpenAI 明確提到了資訊圖表、圖表、標誌和社交媒體帖子等用例。這種對實用性的關注表明他們正在瞄準更廣泛的市場,而不僅僅是創意專業人士。

主要功能與特色:不僅僅是美麗的圖片

  1. 照片級真實感與風格:
    ChatGPT 4o 能夠創建照片級真實感的輸出,並轉換現有的圖像。這代表了相較於 OpenAI 先前的 DALL-E 3 等模型的一大進步,可能提供更高保真度和更逼真的圖像生成效果。照片級真實感的提升將應用範圍擴展到需要逼真視覺效果的領域,例如產品模型和模擬。此外,該模型展現了「令人驚訝的視覺流暢性」,並且能夠生成連貫且符合上下文的圖像。這表明該模型對視覺概念有更深入的理解,並且能夠在不同的提示和迭代中保持連貫性。對於角色設計或品牌資產創建等需要視覺元素保持一致性的應用來說這種連貫性至為重要。
  2. 精確的文字渲染:
    GPT-4o 在圖像中精確渲染文字方面表現出色。這解決了先前包括 DALL-E 3 在內的 AI 圖像生成器的一個常見弱點,它們經常難以生成清晰或正確的文字。改進的文字渲染為創建帶有嵌入式資訊的視覺效果開闢了新的可能性,例如資訊圖表、海報和社群媒體圖形。
  3. 多輪生成與上下文理解:
    由於是原生整合,ChatGPT 4o 允許通過自然的對話來完善圖像,並基於聊天上下文中的先前圖像和文字進行構建。這種對話式的圖像生成方法相較於獨立的圖像生成工具提供了更直觀和迭代的工作流程。用戶可以通過簡單的提示來微調他們的創作,從而獲得更精確和客製化的結果。
  4. 細緻的指令遵循:
    ChatGPT 4o 能夠細緻地遵循詳細的提示,並且能夠處理比先前系統(5-8 個)更多的物件(10-20 個)。這種增強的理解和執行複雜提示的能力使得創建更複雜和特定的視覺效果成為可能。這對於需要精確構圖和包含多個元素的任務尤其有價值。
  5. 上下文學習與世界知識:
    該模型可以分析和學習用戶上傳的圖像,並將其細節整合到生成過程中 。這允許風格轉換、物件複製以及將現有的視覺效果用作靈感。這項功能增強了模型的通用性,並使使用者能夠創建符合其特定視覺偏好或品牌指南的圖像。此外,原生圖像生成使 GPT-4o 能夠連結其在文字和圖像之間的知識,從而產生一個更智能和更高效的模型 。這種深度整合意味著圖像生成受益於底層語言模型的龐大知識庫,這可以帶來更符合上下文且更準確的圖像生成結果。

改進的文字渲染能力和處理更多物件的能力的結合,顯著提升了 ChatGPT 4o 在商業應用方面的潛力,例如創建行銷材料、簡報和視覺輔助工具。能夠準確地整合文字和複雜的佈局,使得該工具更適用於需要清晰溝通的專業使用場景。此外,通過對話進行迭代完善的方式模仿了一個協作的設計過程,可能使圖像生成對於那些在提示工程方面沒有深厚技術專業知識的用戶來說更易於使用。

發布日期與推廣:逐步向大眾開放

  1. 發布與初步推廣:
    ChatGPT 4o 圖像生成功能的正式發布和初步推廣於 2025 年 3 月 25 日進行。
  2. 分階段推廣:
    推廣將分階段進行,ChatGPT Plus 和 Pro 訂閱用戶將首先獲得存取權,然後是免費用戶。(筆者註:2025年4月1日起已對免費用戶全面開放)
  3. 企業與教育用戶及 API 存取:
    企業和教育用戶的存取權將很快提供,而開發人員的 API 存取預計將在未來幾週內推出。這表明 OpenAI 打算將這項技術整合到各種平台和工作流程中,以滿足不同的用戶需求。API 存取將使開發人員能夠構建利用 ChatGPT 4o 圖像生成能力的客製化應用程式。
  4. 初期推廣期間可能遇到的情況:
    在初步推廣期間,部分用戶可能仍然會遇到較舊的 DALL-E 3 模型。這突顯了部署的持續性以及在過渡期間用戶體驗可能存在的不一致性。

競爭分析:提升 AI 圖像生成領域的標準

  1. 與 DALL-E 3 的比較:
    ChatGPT 4o 被定位為相較於先前的 DALL-E 3 系列的重大升級,提供了改進的功能。DALL-E 3 雖然功能強大,但在文字渲染和處理複雜提示方面存在局限性。ChatGPT 4o 旨在克服這些限制,提供更通用且使用者友好的圖像生成體驗。此外,ChatGPT 4o 採用自迴歸系統,這與 DALL-E 使用的擴散模型不同。這種根本性的架構差異有助於提升 ChatGPT 4o 的文字渲染和其他增強功能。轉向自迴歸模型標誌著 OpenAI 在圖像生成方法上的技術演進。使用者也注意到 DALL-E 3(旋轉輪)和 GPT-4o(由上而下、由左而右的平面掃描式)之間圖像載入動畫的差異。這為使用者提供了一個視覺線索來識別正在使用的模型,有助於在推廣期間管理用戶期望。
  2. 與 Google 的 Gemini 的比較:
    OpenAI 的發布緊隨 Google 在其 AI Studio 中為 Gemini 添加原生圖像生成功能之後。這突顯了兩家 AI 巨頭在多模態領域的直接競爭。現在,使用者可以從這兩個領先的 AI 平台獲得引人注目的圖像生成選項。值得注意的是,ChatGPT 4o 在生成公眾人物圖像方面的政策比 DALL-E 更寬鬆,這可能是從 Gemini 早期在偏見問題上的失誤中吸取了教訓。這表明在處理敏感內容生成方面採取了更細緻的方法,可能允許更多具有教育、歷史、諷刺和政治意義的有用應用,同時仍然實施安全措施。
  3. 與 Midjourney 的比較:
    在 Sora 中,OpenAI 引入了一個新的圖像生成部分,類似於 Midjourney 的介面。這表明 OpenAI 有意直接與 Midjourney 等以其藝術能力而聞名的成熟圖像生成平台競爭。這可能會吸引那些偏好專用圖像創建介面的使用者。雖然 Midjourney 通常因其藝術性和逼真的圖像品質而受到讚譽,但 ChatGPT 4o 強調實用性和精確的指令遵循,包括文字渲染。這表明兩個平台各有優勢,並針對不同的目標受眾。使用者可能會選擇最符合其特定需求和創意目標的平台。
  4. 與 Stable Diffusion 的比較:
    Stable Diffusion 是一個開源模型,以其可客製化性而聞名,並且通常能產生美觀的圖像。Stable Diffusion 為具有技術專業知識的使用者提供了更多的控制和彈性。相較之下,ChatGPT 4o 憑藉其易用性和原生整合,可能會吸引更廣泛的尋求更簡化體驗的受眾。值得注意的是,相較於人們對 Stable Diffusion 3 的期望,即使在提示極少的情況下,ChatGPT 4o 在角色、文字和風格的一致性方面也表現得令人印象深刻。這突顯了 OpenAI 整合方法的潛在優勢。對於許多實際應用來說,一致性至關重要。

創新背後的技術:自迴歸的力量

  1. 從擴散模型轉向自迴歸模型:
    與使用擴散模型的 DALL-E 不同,ChatGPT 4o 圖像生成是一個原生嵌入在 ChatGPT 中的自迴歸模型。擴散模型通常通過從雜訊開始並迭代地完善它們來生成圖像,而自迴歸模型則按順序生成內容。這種根本性的架構變化使得新的功能得以實現,尤其是在文字渲染和圖像操作方面。
  2. 圖像到圖像的轉換:
    ChatGPT 4o 可以將圖像作為輸入,並生成相關或修改後的圖像。這允許進行風格轉換、圖像編輯以及創建現有視覺效果的變體等任務。這將創作的可能性擴展到純粹的文字轉圖像生成之外。
  3. 訓練數據:
    OpenAI 使用線上圖像和文字的聯合分佈以及來自 Shutterstock 等合作夥伴的授權數據來訓練 GPT-4o。這種龐大且多樣化的訓練數據集對於模型理解和生成各種視覺效果的能力至關重要。訓練數據的品質和多樣性直接影響模型的性能和潛在的偏見。此外,OpenAI 使用了來自人類回饋的強化學習 (RLHF) 來進一步提升模型的輸出品質。RLHF 涉及使用人類專家的反饋來改進模型的性能並使其更符合人類的偏好。這有助於確保生成的圖像不僅在技術上準確,而且在美學上令人愉悅且相關。

ChatGPT 4o 圖像生成的自迴歸特性,即按順序生成圖像,被認為是提高文字渲染準確性和視覺元素一致性的原因。這種順序生成過程可能使模型能夠更好地保持連貫性和細節,尤其是在涉及文字的複雜構圖中。

安全措施與限制:負責任的創新

  1. 安全基礎設施與經驗:
    ChatGPT 4o 圖像生成受益於 OpenAI 現有的安全基礎設施以及從部署 DALL-E 和 Sora 中吸取的經驗。OpenAI 在降低與圖像生成相關的風險方面擁有豐富的經驗。這表明其對新模型潛在的安全問題採取了積極主動的態度。
  2. 具體的安全措施:
    安全措施包括聊天模型拒絕、提示封鎖以及使用多模態推理模型和 CSAM 分類器進行輸出封鎖。這些分層防禦目的在防止生成有害或不當的內容。OpenAI 正在採取措施確保該技術的負責任使用。此外,OpenAI 致力於解決兒童安全風險,包括對 CSAM 進行嚴格的掃描。這突顯了負責任的 AI 開發的一個關鍵重點領域。已採取強有力的措施來防止該技術被濫用於兒童性剝削。ChatGPT 4o 生成的圖像將包含 C2PA 元數據,以表明其 AI 來源 2。這提高了透明度,並有助於用戶區分 AI 生成的內容和人類創建的內容。這是負責任的 AI 部署的重要一步。
  3. 已識別的限制:
    該模型存在一些限制,包括可能難以處理大量物件(描繪超過 10-20 個概念)、多語文字、始終如一地編輯特定的圖像部分、保持上傳圖像中的人臉一致性以及顯示小尺寸的詳細資訊。這承認該技術仍在不斷發展,並且有需要改進的地方。用戶在使用圖像生成功能時應注意這些限制。此外,圖像生成可能比先前的迭代慢,但 OpenAI 認為品質的提升是值得等待的 。與 DALL-E 3 相比,用戶可能會遇到更長的生成時間。OpenAI 預計將隨著時間的推移提高速度。

結語

ChatGPT 4o 在圖像生成方面提供了顯著的進步,包括改進的照片級真實感、文字渲染、指令遵循以及通過原生整合實現的上下文理解。這項技術在行銷、教育、設計和個人溝通等各個行業都具有變革性的潛力。它也加劇了 AI 領域的競爭。