Midjourney V7 優化準確性及手部呈現,並推出 exp 實驗性參數

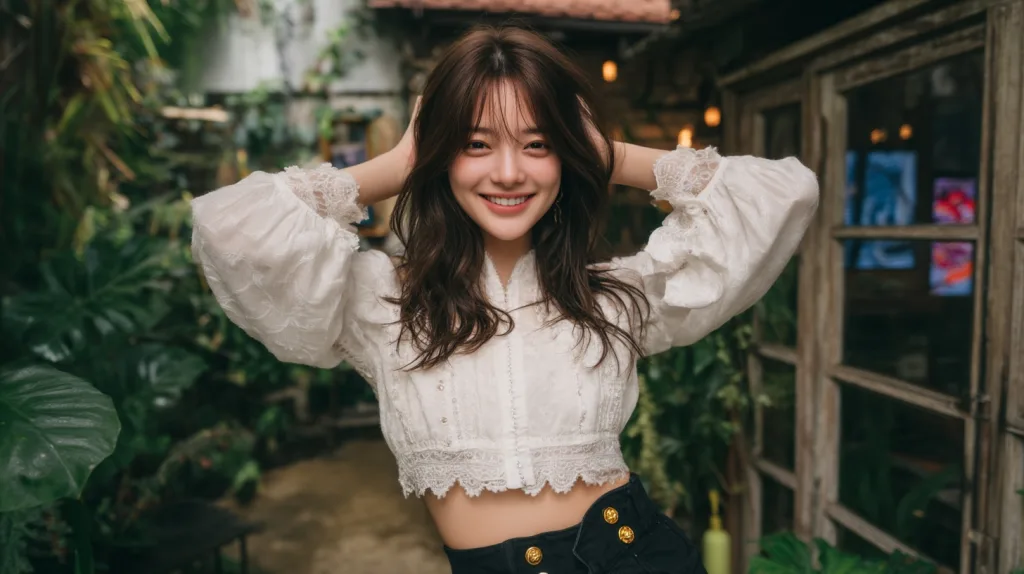
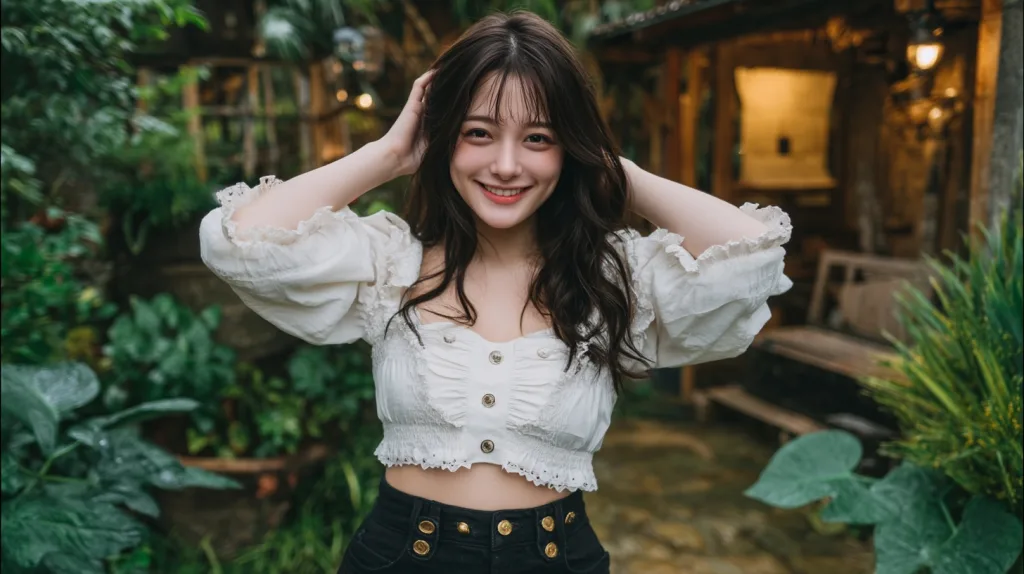
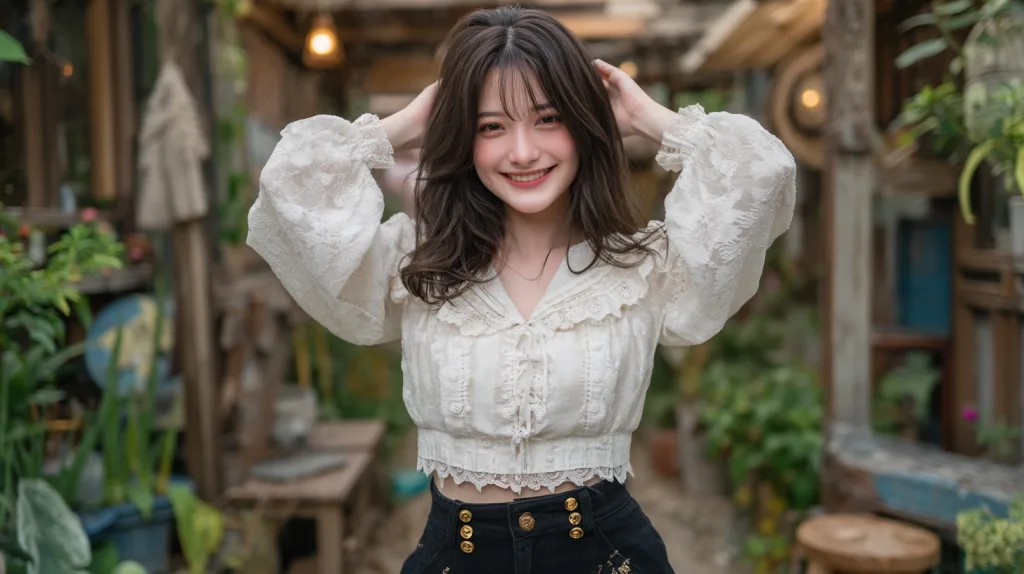
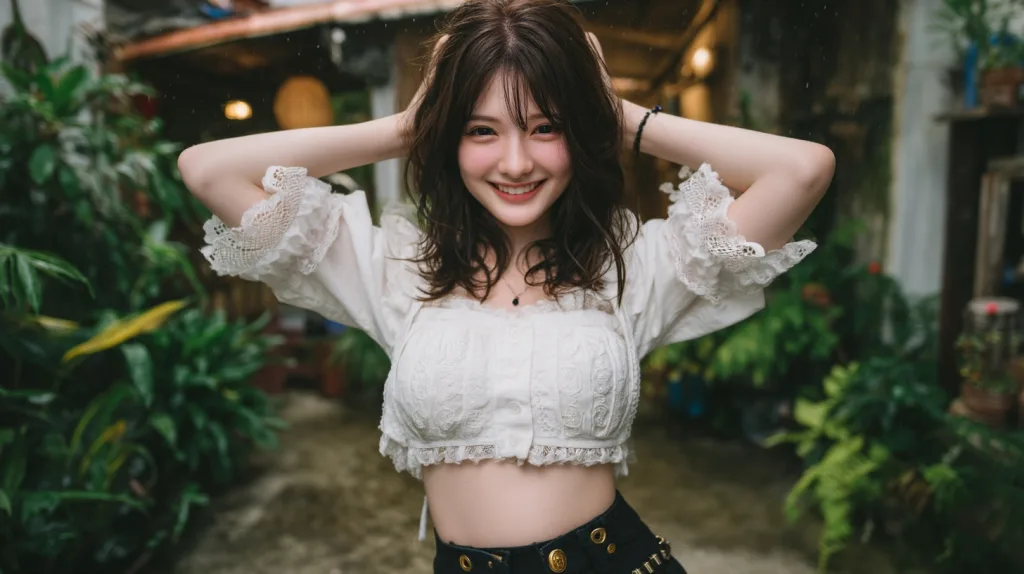
Midjourney V7 Exp50 範例2

Midjourney 再度升級,最新釋出的 V7 模型不僅進一步提高了圖像品質,更在準確性、人體與手部的呈現上進行了顯著優化。

此次升級用戶無須做任何額外調整,系統將自動應用於所有使用 V7 的圖像生成操作,甚至可重新生成過去的圖像種子,獲得更佳且一致的效果。

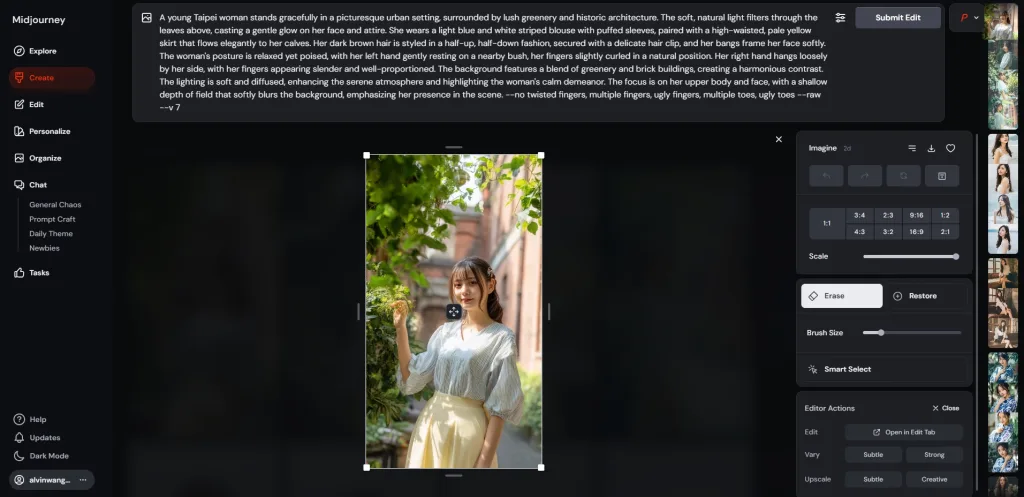
Midjourney 亦回應社群意見,推出了全新優化的 Lightbox 編輯界面。新界面不僅恢復了廣受歡迎的圖像側邊預覽功能,還加入了智慧分割工具,並簡化了用戶對各項功能的操作流程。

Midjourney推出新的編輯器介面

在新界面中,用戶現在可以直接使用「變化」(Vary)與「高解析」(Upscale)按鈕,更直覺地實現圖像的快速編輯與調整,大幅提高創作效率。

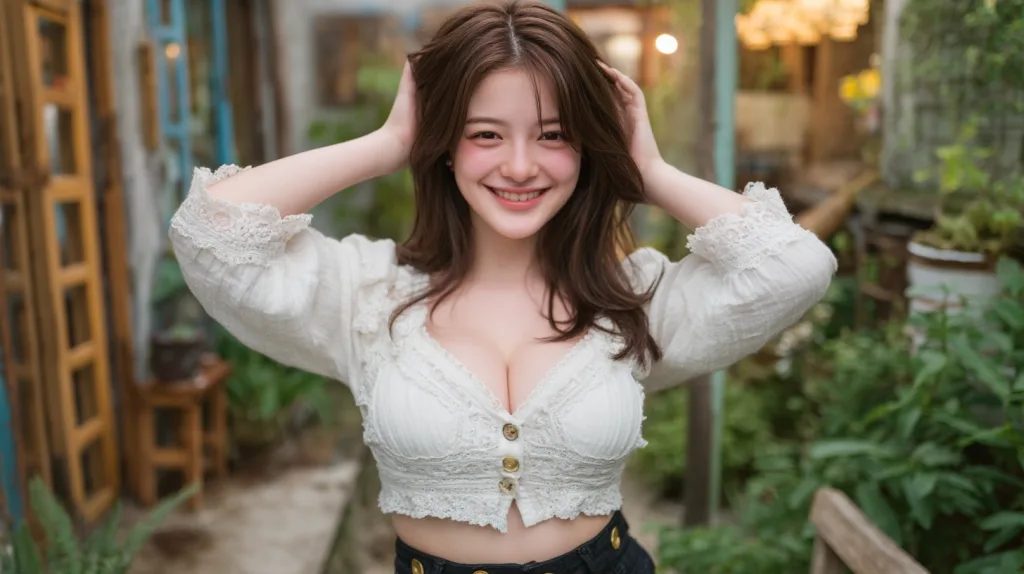
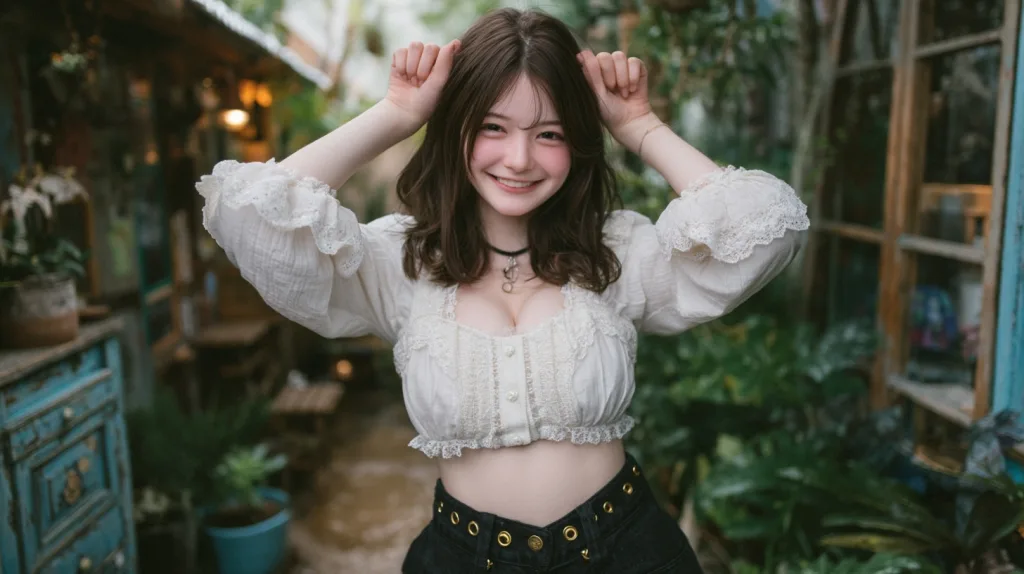
值得注意的是,本次更新同時推出了一個名為「–exp」的實驗性參數。此參數的數值範圍從 0 到 100,預設值為 0。該參數類似於原有的「–stylize」,但能讓圖像呈現更豐富的細節、更具動感和創意,並且色調映射效果更加明顯。

官方建議用戶主要嘗試使用 5、10、25、50、100 等幾個特定數值區段。在數值範圍 5 到 50 之間,圖像變化較為明顯,而 50 到 100 則差異相對較小。不過官方也提醒,用戶設定較高的數值(超過 25 至 50)可能會降低 prompt 準確性與圖像多樣性,並可能覆蓋原有的其他參數效果,因此在與其他參數混用時建議使用較低數值。

Midjourney 團隊表示,原定即將推出的「Omni-reference」以及「快速模式(fast-mode)」功能,因部署過程中遇到小型技術問題,或將稍晚上線。

此次更新凸顯出 Midjourney 持續在 AI 圖像生成領域的創新腳步,展現其穩居產業領先地位的決心。

Exp 參數實際測試

提示詞(使用 V7 原始風格)

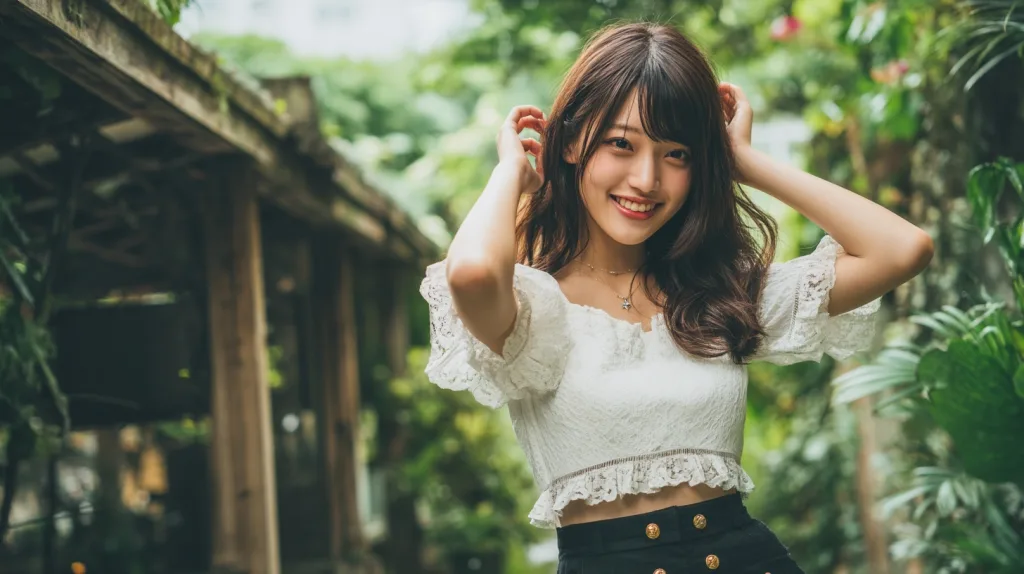
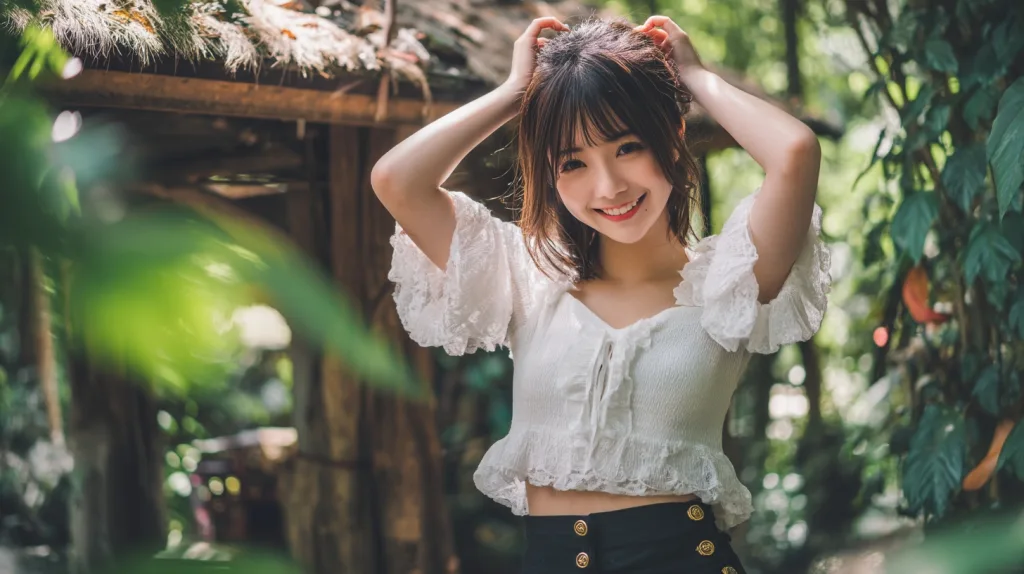
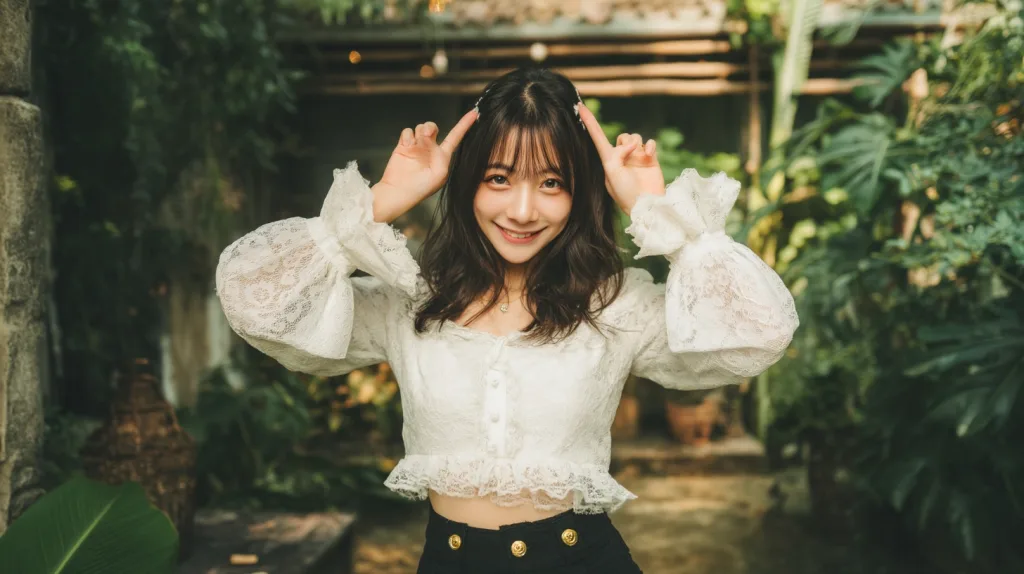
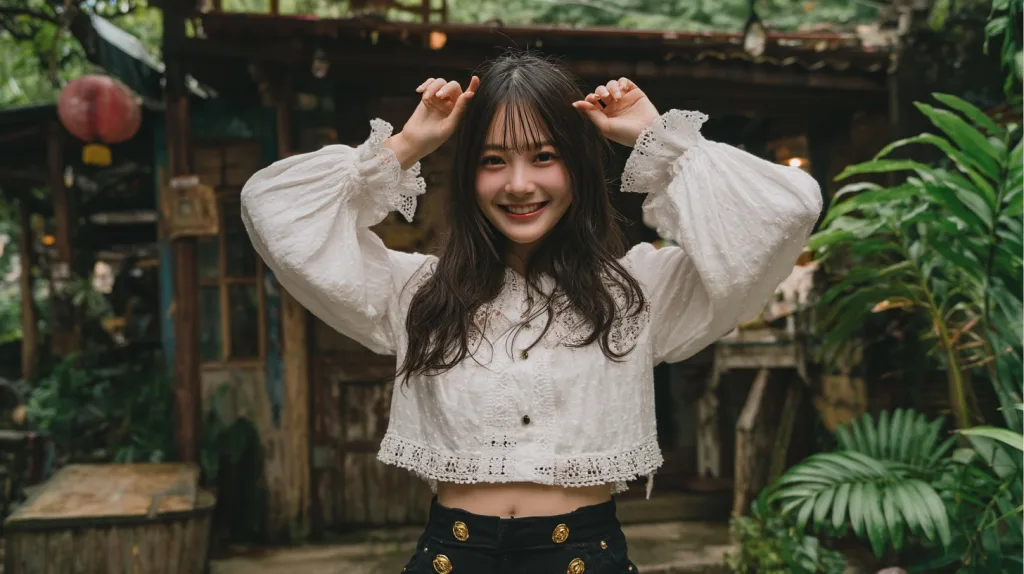
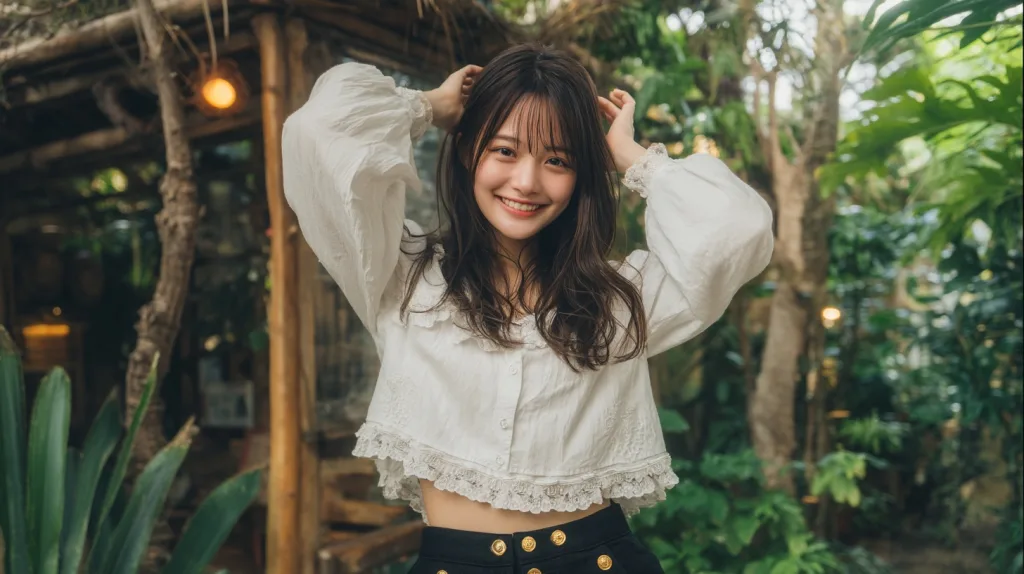
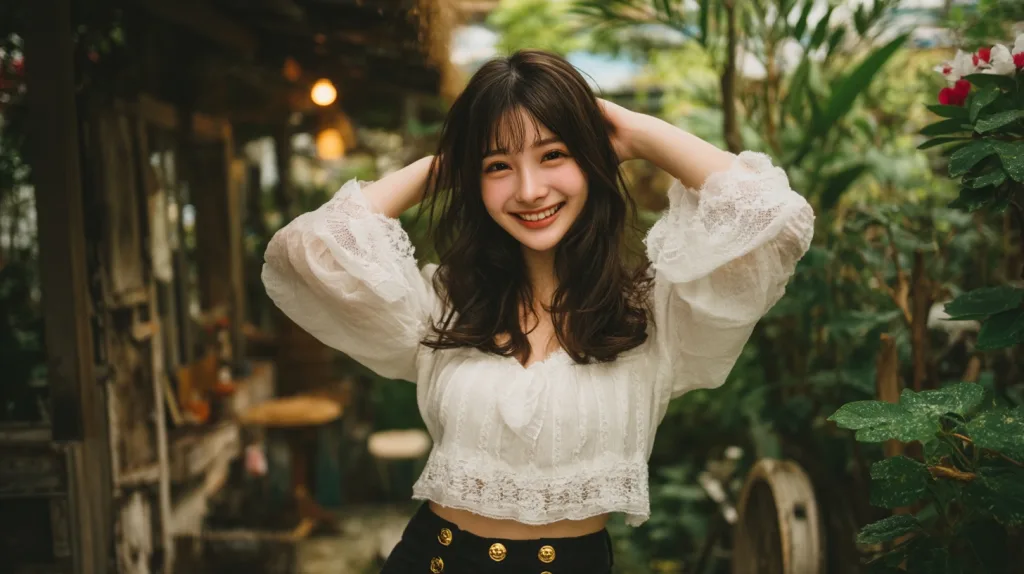
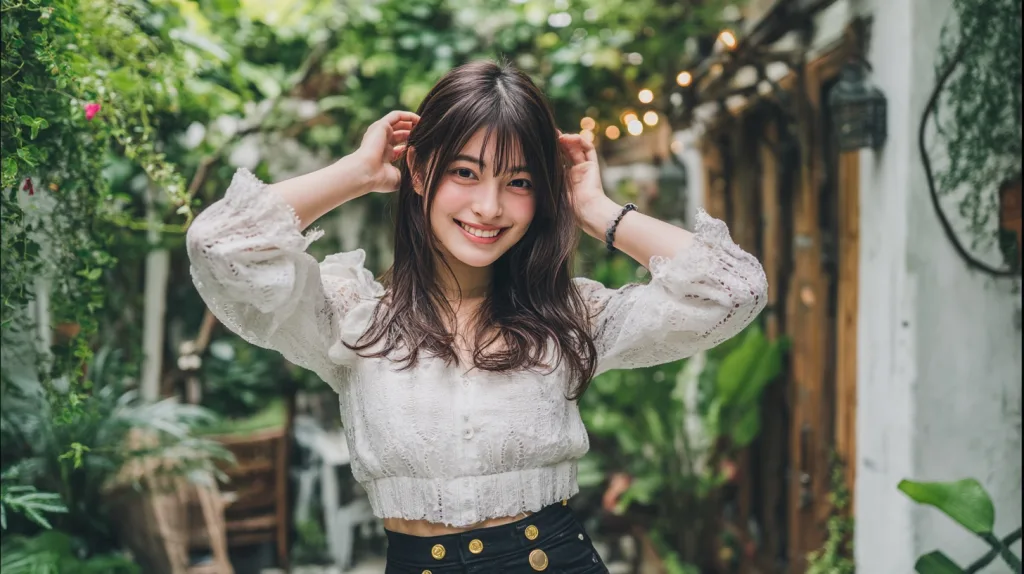
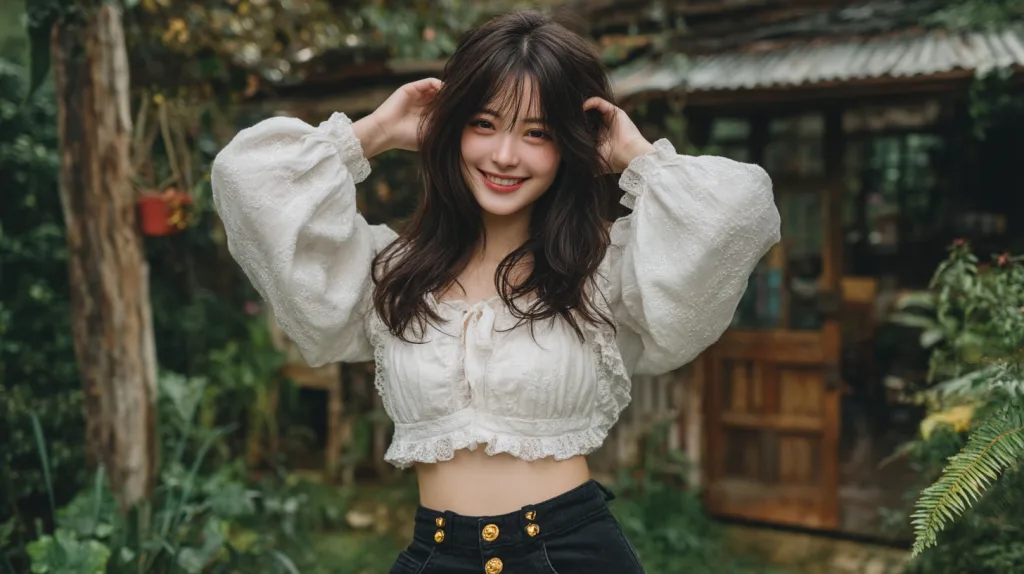
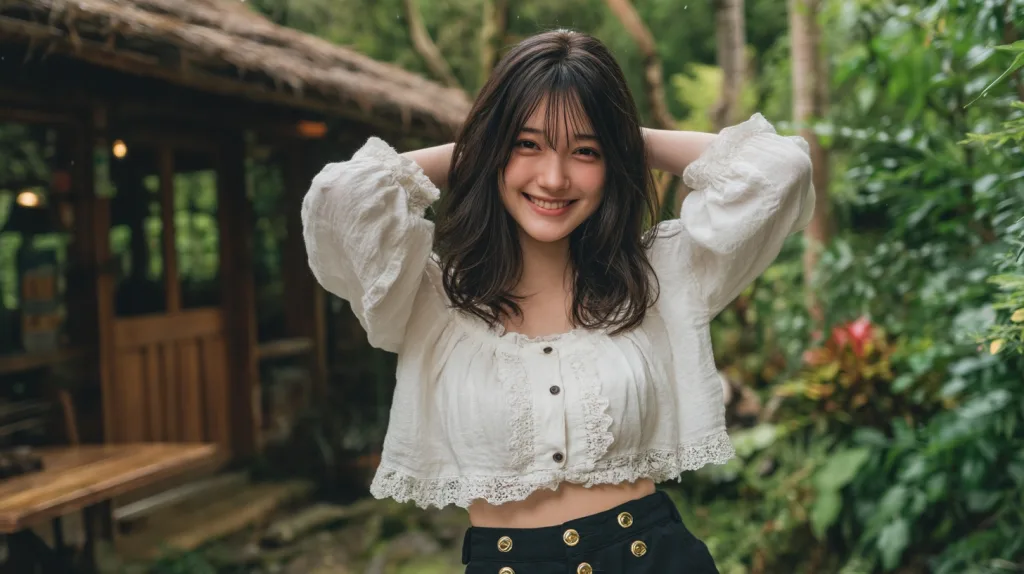
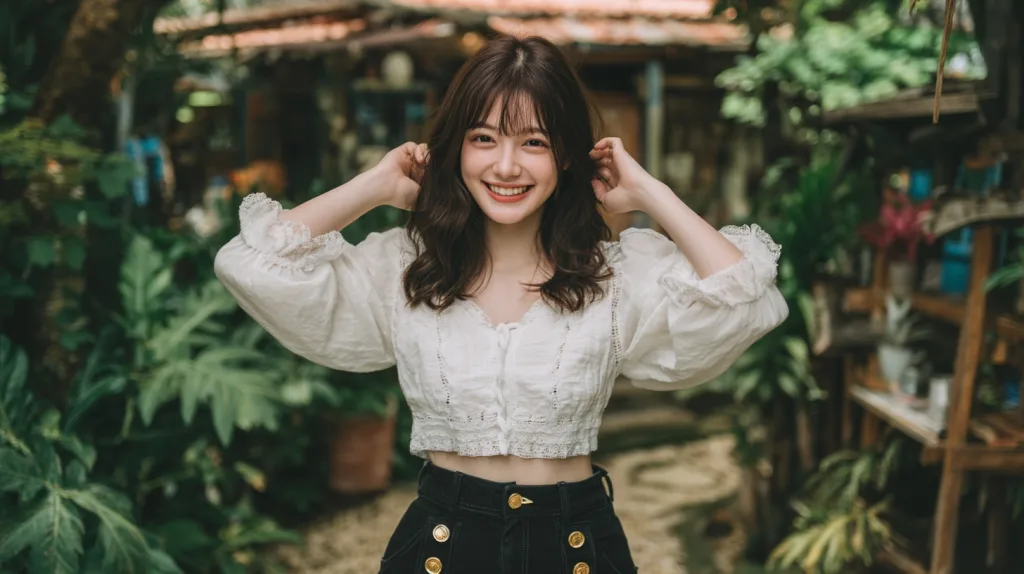
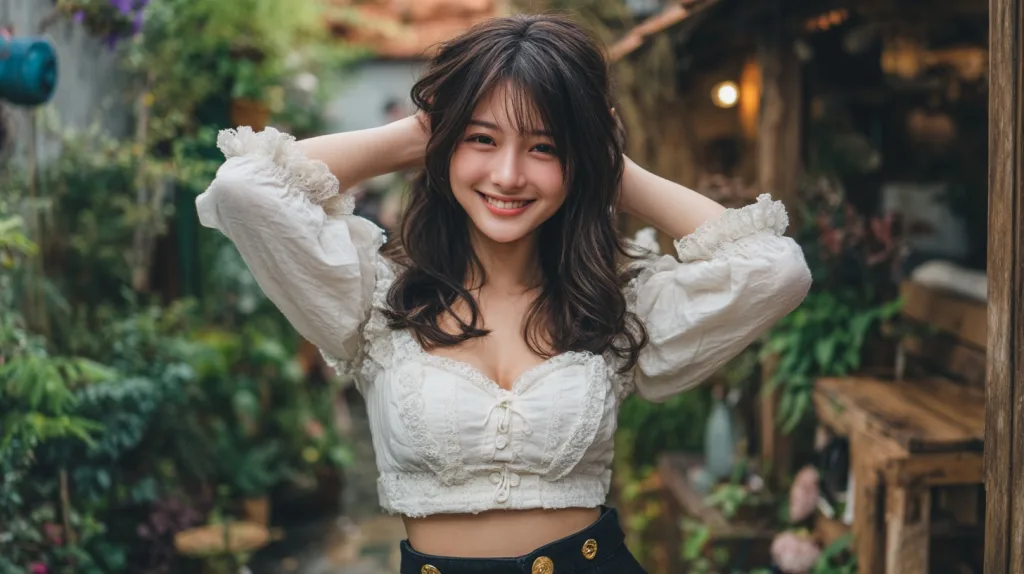
A young Taipei woman stands in a lush, green outdoor setting, surrounded by vibrant foliage and a rustic wooden structure in the background. The soft, natural light gently illuminates her face and attire, creating a warm and inviting atmosphere. She wears a delicate white blouse with lace detailing and ruffled sleeves, paired with black high-waisted pants adorned with gold buttons. Her dark brown hair is styled in loose waves, with bangs framing her face, adding to her youthful and cheerful appearance. She poses with her hands near her head, fingers slightly spread and relaxed, showcasing her well-manicured nails and graceful gestures. The focus is on her upper body and face, with a shallow depth of field that softly blurs the background, emphasizing her joyful expression and the intricate details of her outfit. The lighting is natural and diffused, casting soft shadows and highlighting the textures of her clothing and surroundings. --ar 16:9 --style raw --s 100 --p none

Exp 0

Midjourney V7 Exp 範例1
Midjourney V7 Exp 範例2
Midjourney V7 Exp 範例3
Midjourney V7 Exp 範例4

Exp 5

Midjourney V7 Exp5 範例1
Midjourney V7 Exp5 範例2
Midjourney V7 Exp5 範例3
Midjourney V7 Exp5 範例4

Exp 10

Midjourney V7 Exp10 範例1
Midjourney V7 Exp10 範例2
Midjourney V7 Exp10 範例3
Midjourney V7 Exp10 範例4

Exp 25

Midjourney V7 Exp25 範例1
Midjourney V7 Exp25 範例2
Midjourney V7 Exp25 範例3
Midjourney V7 Exp25 範例4

Exp 50

Midjourney V7 Exp50 範例1
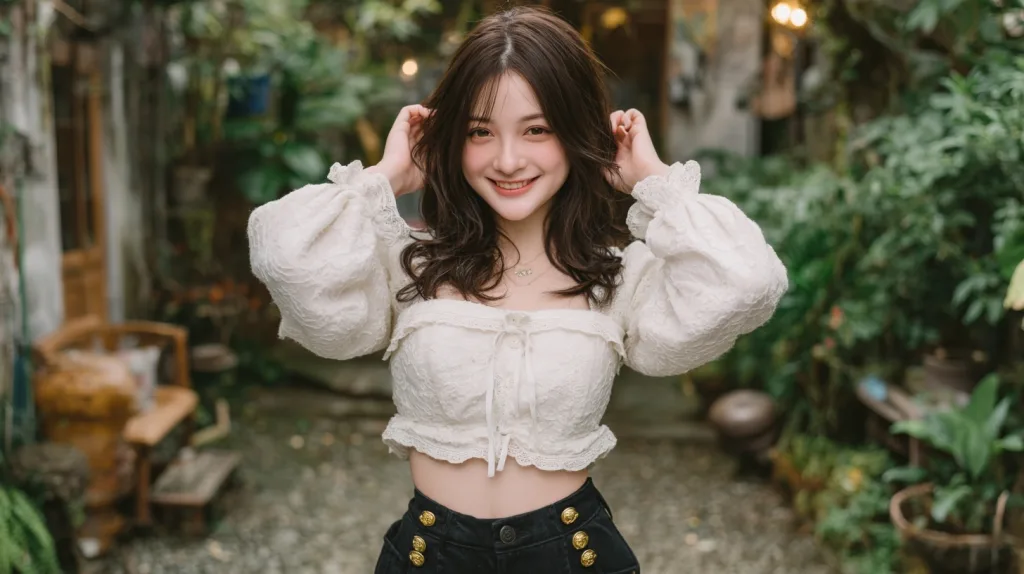
Midjourney V7 Exp50 範例2
Midjourney V7 Exp50 範例3
Midjourney V7 Exp50 範例4

Exp 100

Midjourney V7 Exp100 範例1
Midjourney V7 Exp100 範例2
Midjourney V7 Exp100 範例3
Midjourney V7 Exp100 範例4

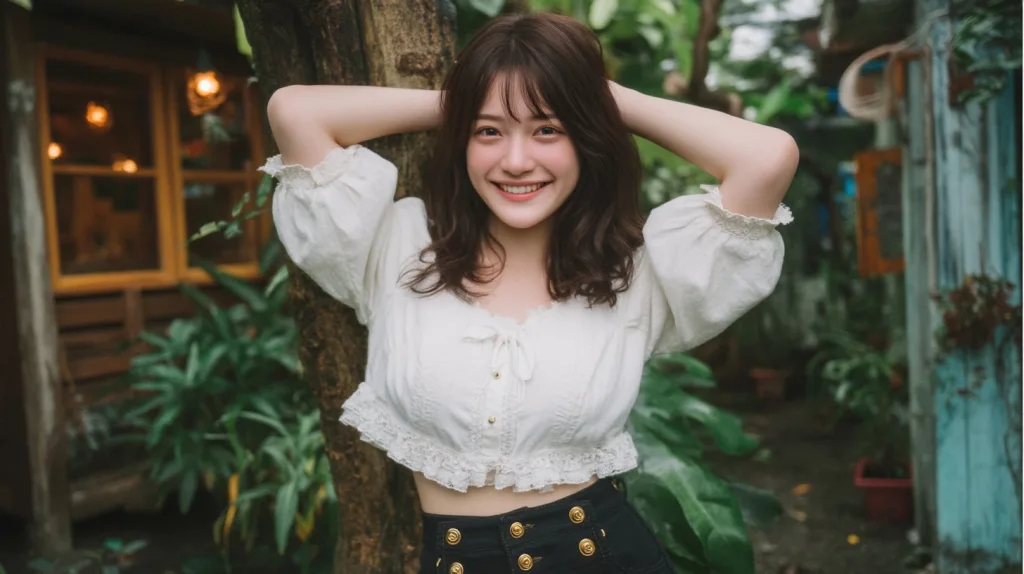
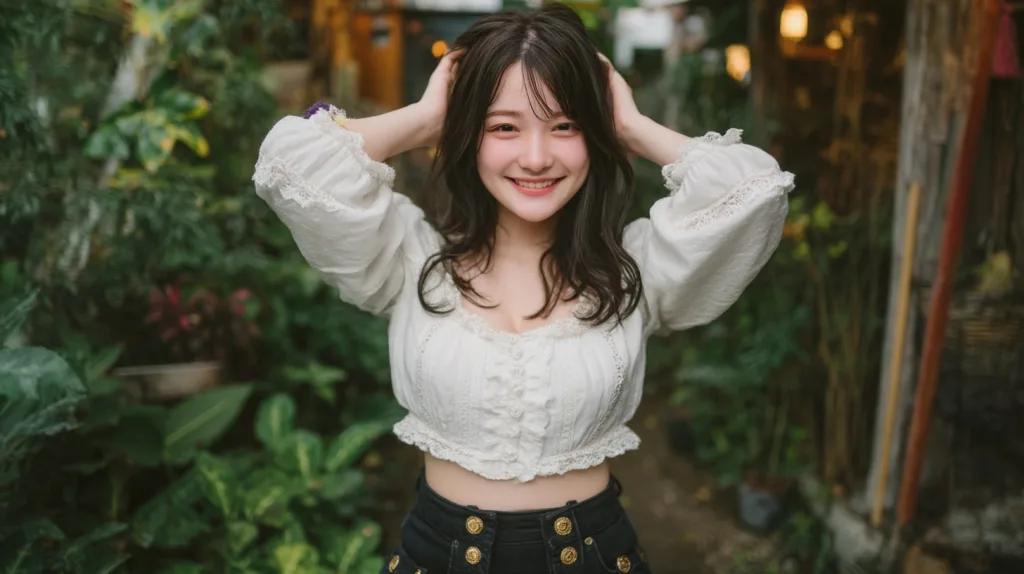
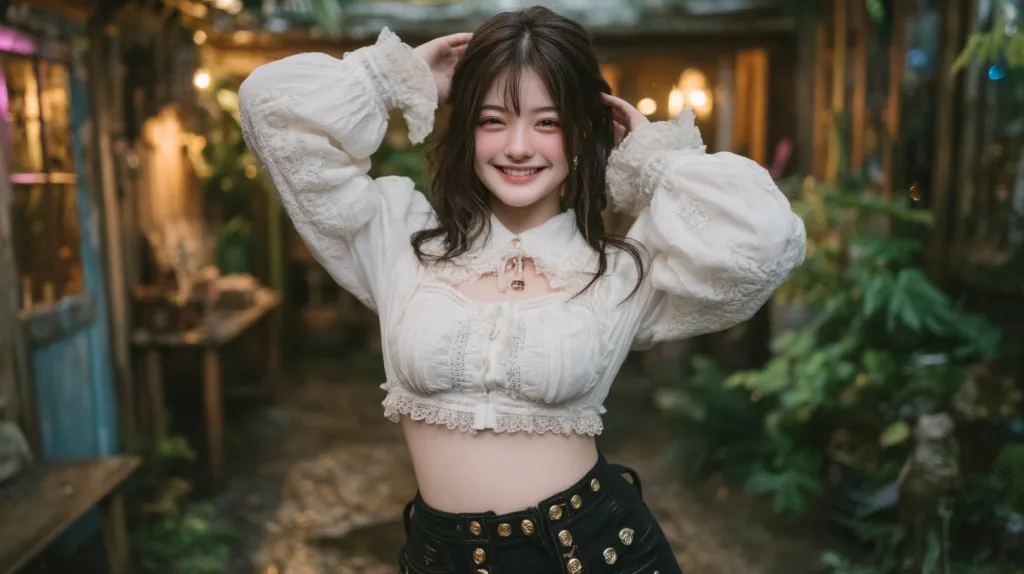
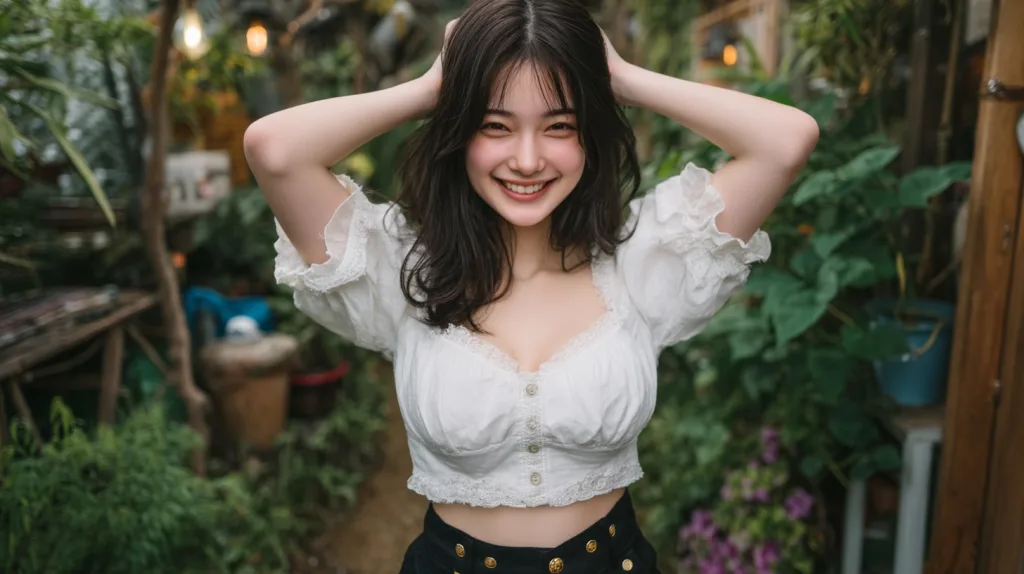
以上是筆者實測的結果:4張輸出照片直接上傳,沒有經過任何挑選。從輸出的照片質量觀察,V7 這次的更新基本上已經解決 Midjourney 過去很長時間一直被用戶吐槽的手部瑕疵問題(但是偶而還是會出現多手或多手指的問題)。而這次推出的 Exp 參數如同官方說明呈現更豐富的細節、更具動感和創意,並且色調映射效果更加明顯。筆者自己覺得 Exp 0-25的人物細節差異很明顯,25以上的差異就相當微小。各位可以根據自己喜好挑選符合自己需求的 Exp 值來使用。

此外,經過筆者多次測試的結果,用於生成女性照片 Exp 值越高時,女性的“性魅力”更強烈,通常顯現在胸部及衣服多寡。提供給有這樣需求的讀者參考。

進一步閱讀
  1. ​Midjourney 將 sref V7 設為預設
  2. Midjourney V7 大幅提速,生成成本腰斬,推出新實驗模式
  3. Midjourney V7 推出全新編輯器與 Weird 參數
  4. Midjourney V7 持續升級:導入 V6 熱門功能、AI 輔助提示與用戶回饋加速進化
  5. Midjourney V7 Alpha 版本震撼發布

Google NotebookLM 擴展 AI 播客功能,支援包括中文的 50 種以上語言

Google NotebookLM 擴展 AI 播客功能,支援包括中文的 50 種以上語言

Google 於2025年4月29日宣布 AI 筆記應用 NotebookLM 的「Audio Overviews」功能現已支援超過50種語言,包括中文、法語、西班牙語、葡萄牙語、韓語、土耳其語和印地語等。​此舉讓全球更多用戶能夠將筆記內容轉換為類似播客的音頻對話,提升學習與資訊吸收的效率。

NotebookLM 是 Google Labs 開發的 AI 筆記與研究助手,利用 Gemini 語言模型,協助用戶從上傳的文件中生成摘要、解釋和創意內容。​「Audio Overviews」功能則能將這些內容轉換為由兩位 AI 主持人進行的音頻對話,模擬播客形式,讓用戶以更輕鬆的方式理解複雜資訊。​

此次語言支援的擴展,使得來自不同語言背景的用戶也能享受這項功能。​用戶只需在 NotebookLM 的設定中選擇「輸出語言」,即可生成對應語言的音頻摘要。​此外,Google 也將「Audio Overviews」功能整合至 Gemini AI 聊天機器人和 Google Docs,進一步擴大其應用範圍。​

Google 表示,這次更新是對「Audio Overviews」功能的早期探索,未來將根據用戶反饋持續改進,並計劃加入更多語言支援和功能強化。​目前,該功能已在超過 200 個國家和地區推出,並逐步向更多用戶開放。

設定方式

影片來源:Google

測試範例(中文對話)

Google Gemini Deep Research 最佳提示詞指南 (原始文章)

OpenAI 向免費用戶釋出 Deep Research Light

OpenAI 向免費用戶釋出 Deep Research Light

OpenAI 本週開始將 Deep Research Light 分批開放至 ChatGPT 免費帳戶,每位用戶每月可執行 5 次完整研究任務。此配額將於未來數週陸續到位,無須申請候補。Light 版採用 o4-mini 推論引擎與分層計算架構,官方目標是在降低約 60 % GPU 使用率的前提下,把產出時間控制在 2-5 分鐘。 Plus 與 Pro 層級維持現有高階配額,同時額外贈送 Light 版任務數,藉此提升免費用戶轉訂的機會。Google Gemini 與 Anthropic Claude 已經將類似研究代理功能下放至免費層,OpenAI 此次策略被業界視為「跟進同業的必要步驟」。OpenAI 表示,Light 版沿用完整版的 Source-Tracing Pipeline,所有輸出都會附上可點擊來源,並在檢測到潛在不實資訊時顯示黃標警示。

Deep Research 最初於 2025 年 2 月在 Pro 層級率先上線,訂價 200 美元/月,鎖定金融、科技與顧問產業。工具能自動檢索網頁、PDF 與數據庫,並生成引文完備的長篇報告;許多媒體先前報導均將其形容為「可在十分鐘內完成研究分析師工作量」的代理人功能。​

產品定位

方案每月 Deep Research 配額引擎平均完成時間目標族群
FreeLight 5o4-mini2-5 分鐘學生、內容創作者
PlusFull 10 + Light 15o4、o4-mini1-3 分鐘中小企業、專業人士
ProFull 125o430 秒-2 分鐘顧問公司、金融機構

數據來自 OpenAI Help Center ,實際速度因任務複雜度與即時流量而異。​

Deep Research Light 透過「Adaptive Layered Compute」管線先以 o4-mini 快速構建知識圖,對高權重節點再行呼叫 o4 提升精度。此流程在內部測試中將單次研究任務的平均成本降至完整版的約三分之一。

OpenAI 尚未公布 o5 時程表,但業內人士普遍預期下一代模型將在 2025 年底前進入封閉測試。Deep Research Light 的推出,象徵 OpenAI 正加快「免費體驗-高階付費」的產品節奏;在多家競爭者同場較勁的環境下,誰能率先完成高效、低成本的代理人商業化,將決定 2026 年 AI 服務格局。

進一步閱讀

​Midjourney V7 推出全新編輯器與 Weird 參數

​Midjourney V7 推出全新編輯器與 Weird 參數

2025年4月18日 Midjourney 宣布推出 V7 版本,帶來全新編輯器功能與「Weird」參數,進一步提升用戶的創作自由度。​

全新編輯器功能

Midjourney 的全新編輯器現已對所有會員等級開放,提供以下功能:​

  1. 多圖層編輯:​允許用戶在單一畫布上進行多層次的圖像編輯,提升創作靈活性。​
  2. 智慧選取工具:​透過 AI 技術,精確選取圖像中的特定區域,進行局部修改或替換。​
  3. 智慧 AI 審核:​加強的內容審核機制,確保創作內容符合社群準則。​

此外,編輯器現已整合 Midjourney 生成圖像與外部上傳圖像的編輯體驗,用戶可透過左側的「編輯」按鈕或燈箱中的「編輯」按鈕進入編輯器。​

Midjourney 多圖層的應用方法(感謝 X 網友 Tatiana Tsiguleva 的分享)

「Weird」參數回歸

Midjourney 在 V7 版本中重新引入了「Weird」參數,允許用戶在生成圖像時加入更多創意與實驗性。​

  • 參數範圍:​0 至 1000,最高可達 3000。​
  • 搭配建議:​與高值的「Stylize」參數結合使用,可創造出更具藝術感與獨特風格的圖像。​

此功能旨在讓用戶突破傳統美學框架,探索更多元的視覺表現。​

結語

Midjourney 鼓勵用戶在 Discord #ideas-and-features 頻道分享對新功能的看法,並在 #v7-showcase 頻道展示創作成果。​

隨著 V7 版本的推出,Midjourney 持續致力於提供更強大且直觀的創作工具,滿足用戶日益多元的創作需求。

進一步閱讀
  1. Midjourney 將 sref V7 設為預設
  2. Midjourney V7 大幅提速,生成成本腰斬,推出新實驗模式
  3. Midjourney V7 優化準確性及手部呈現,並推出 exp 實驗性參數
  4. Midjourney V7 持續升級:導入 V6 熱門功能、AI 輔助提示與用戶回饋加速進化
  5. Midjourney V7 Alpha 版本震撼發布

OpenAI 推出 O3/O4-mini/O4-mini-high

OpenAI 推出 O3/O4-mini/O4-mini-high

OpenAI 於2025年4月16日宣布推出其 O3 與 O4-mini 模型,這是其專為增強推理能力而設計的「o 系列」模型的最新進展 。此次發布緊隨2025年1月31日推出的 O3-mini 模型之後 。這些模型的推出標誌著 OpenAI 在開發能夠進行更長時間「思考」以解決複雜問題的 AI 方面邁出了重要一步。

YouTube thumbnailYouTube icon
影片來源:OpenAI

此次發布的一個關鍵進步在於,O3 與 O4-mini 被定位為 OpenAI 迄今為止發布的「最智能模型」,並且首次能夠在其 ChatGPT 平台內自主地使用和組合所有可用工具,包括網路搜尋、使用 Python 分析上傳文件和數據、對視覺輸入進行深度推理,甚至生成圖像 。這種整合工具使用的能力,代表了 AI 發展的一個重要方向。過去的模型或許也能接入工具,但 O3 和 O4-mini 被強調能夠自主地決定何時及如何結合所有工具,這顯示了更高層次的自主性和整合度。這與解決需要多方面分析的複雜查詢的目標相符。透過強化學習教會模型不僅是如何使用工具,更是何時使用它們,這是超越簡單工具執行的關鍵能力飛躍,意味著 AI 在處理涉及多種數據類型 (文本、代碼、圖像) 的複雜多步驟工作流程時,可能需要更少的明確指令。

從 O3-mini (2025年1月底) 到 O3 和 O4-mini (2025年4月16日) 的快速迭代 ,僅約兩個半月的間隔,突顯了 OpenAI 在推理模型領域的積極開發和發布節奏。這可能部分是為了應對日益激烈的市場競爭 (例如 O3-mini 的推出是為了應對 DeepSeek 的崛起 ),也反映了市場對於超越通用模型的專業化推理能力的需求日益增長。這表明 o 系列模型是 OpenAI 的一個關鍵戰略領域,需要快速迭代以在高級推理任務上保持領先地位。

O3:複雜推理的新旗艦

OpenAI 將 O3 定位為其「最強大的推理模型」,旨在推動編碼、數學、科學和視覺感知等領域的技術前沿。它特別適用於處理那些答案不甚明顯、需要深入分析的複雜查詢。  

根據 OpenAI 發布的基準測試數據,O3 在多個關鍵領域達到了新的「技術水平」( State-of-the-Art, SOTA ),顯示其在特定任務上超越了現有模型:

  • 編碼能力: 在 Codeforces 競賽編程平台上,使用終端工具時達到2706的 ELO 等級分;在衡量解決真實世界軟體工程問題能力的 SWE-bench 測試中,達到了69.1%的準確率(未使用客製化模型支架)。在 Aider 多語言代碼編輯基準測試中也表現強勁,整體( whole )準確率為81.3%,差異 ( diff )準確率為79.6%。  
  • 數學推理:在美國數學邀請賽( AIME )2024 年試題上達到91.6%的準確率,在2025年試題上達到88.9%(均未使用外部工具)。  
  • 科學理解:在 GPQA Diamond (博士級別科學問題) 測試中達到83.3%的準確率(未使用外部工具) 。
  • 視覺與多模態:在 MMMU(大學水平視覺問題解決)基準上達到82.9%的準確率;在 MathVista (視覺數學推理)上達到86.8%;在 CharXiv-Reasoning(科學圖表推理)上達到78.6%。官方資料特別指出 O3 在分析圖像、圖表和圖形等視覺任務上表現尤為出色 。  
  • 指令遵循:在 Scale MultiChallenge (多輪指令遵循) 測試中達到 56.51% 的準確率。  
  • 工具使用與自主任務:在 SWE-Lancer(模擬自由職業編碼任務)中賺取了 $65,250;在 BrowseComp (使用 Python 和瀏覽工具進行深度研究) 中達到49.7%的準確率;在 Tau-bench (函數調用) 測試中,Airline 場景準確率為52.0%,Retail 場景為70.4%。  

除了量化的基準測試結果,外部專家評估也顯示,相較於其前代模型 O1,O3 在處理困難的真實世界任務時,嚴重錯誤減少了20%,尤其在程式設計、商業/諮詢和創意構思等領域表現突出。早期測試人員也強調了 O3 作為「思想夥伴」的分析嚴謹性,以及其在生物學、數學和工程等領域生成和批判性評估新穎假設的能力。這種對減少錯誤和提升真實世界任務表現的強調,以及在 SWE-bench 和 SWE-Lancer 等實用基準上的表現,表明 OpenAI 不僅關注原始能力,也致力於提高模型的可靠性和實用性,以應對大型語言模型常見的一致性問題。  

技術層面上,O3 的能力提升得益於大規模強化學習 (RL) 的應用。OpenAI 觀察到,應用於推理的 RL 展現出與 GPT 系列預訓練相似的趨勢,即「投入更多計算資源等於更好的性能」。通過在 RL 階段投入更多訓練計算資源和允許更長的推理時間 (即「思考更長時間」),O3 的性能持續提升 。這一發現意義重大,它驗證了除了預訓練階段,在推理/RL 階段投入更多計算資源同樣能帶來顯著的能力增益,可能開闢了超越僅擴展預訓練數據/計算的新性能提升途徑。此外,RL 也被用於訓練 O3 的工具使用能力,重點不僅在於如何使用工具,更在於何時部署它們 。

O4-mini:平衡速度、成本與性能

與 O3 並行發布的 O4-mini 是一款體積更小、效率更高的模型,專為實現快速、低成本的推理而優化。儘管規模較小,但其性能表現,尤其在特定領域,依然十分出色。  

O4-mini 在多項基準測試中取得了引人注目的成績:

  • 數學推理:在 AIME 2024和2025年試題上分別達到93.4%和92.7%的準確率 (未使用外部工具),這兩項成績均超過了 O3,使其成為這兩項 AIME 基準測試中表現最佳的模型 。
  • 編碼能力: 在 Codeforces 平台上,使用終端工具時的 ELO 等級分達到2719,略高於 O3 。在 SWE-bench 測試中準確率為68.1%。在 Aider 測試中,整體準確率 68.9%,差異準確率 58.2% 。
  • 科學理解: 在 GPQA Diamond 測試中達到81.4%的準確率 (未使用外部工具),略低於 O3 但仍屬非常高的水平。
  • 視覺與多模態:在 MMMU 上達到81.6%,MathVista 上達到84.3%,CharXiv-Reasoning 上達到72.0%,性能接近 O3。  
  • 指令遵循: 在 Scale MultiChallenge 測試中達到42.99%的準確率 。  
  • 工具使用與自主任務: 在 SWE-Lancer 中賺取了$56,375;在 BrowseComp 測試中,根據設置不同,準確率分別為28.3%或51.5%;在 Tau-bench (函數調用) 測試中,Airline 場景準確率為49.2%,Retail 場景為65.6%。

根據外部專家的評估,O4-mini 在非 STEM 任務以及數據科學等領域的表現優於其直接前代模型 O3-mini 。專家們也認為,與前代模型相比,O4-mini 在遵循指令和提供更有用、可驗證的回應方面有所改進 。O4-mini 的一個關鍵優勢在於其效率。由於其高效的設計,O4-mini 支持比 O3「顯著更高的使用限制」,使其成為需要高吞吐量、處理大量受益於推理的問題的有力選擇 。  

O4-mini 在 AIME 數學基準測試中表現優於體積更大、價格更高的 O3 ,這一點尤其值得注意。這強烈暗示了 OpenAI 採取了高度針對性的優化策略。與其追求所有領域的均衡發展,不如在數學推理等高需求領域進行了重點優化,從而在這些特定領域創造出極具成本效益的卓越性能。這使得 O4-mini 能夠在保持較低成本的同時,在關鍵應用場景提供極具競爭力的表現。  

同時,O4-mini 在多個基準測試 (如 MMMU、GPQA、SWE-bench) 上的性能顯著縮小了與旗艦 O3 模型之間的差距 ,而其定價則更接近之前的 mini 系列模型 。這意味著先進的推理能力正以更低的價格點變得觸手可及,有望推動那些以前需要更昂貴模型的任務實現更廣泛的應用。

對於 ChatGPT 付費訂閱用戶,o4-mini 還提供了一個「o4-mini-high」模式 。這並非一個獨立的 API 模型,而是 o4-mini 在 ChatGPT 介面中的一個高推理強度選項,允許模型投入更多計算資源來處理請求,為更複雜的任務提供更強的性能,類似於先前 o3-mini 所擁有的 o3-mini-high 模式 。

API 定價

OpenAI 為其 API 模型提供了分層的定價結構,根據模型的能力進行區分。費用通常按每百萬 token (代幣) 計算,分別針對輸入 ( Input )、輸出 ( Output ) 以及適用的緩存輸入 ( Cached Input ) 收費 。  

以下是 O3、O4-mini 和 O3-mini (作為比較基準) 的詳細 API 定價 (美元/每百萬 tokens):

模型 (版本)輸入 (Input)緩存輸入 (Cached Input)輸出 (Output)
o3 (o3-2025-04-16)$10.00$2.50$40.00
o4-mini (o4-mini-2025-04-16)$1.10$0.275$4.40
o3-mini (o3-mini-2025-01-31)$1.10$0.55$4.40

主要模型 API 定價比較 (美元 / 每百萬 Tokens)

模型 (Model)輸入 (Input)緩存輸入 (Cached Input)輸出 (Output)
o3$10.00$2.50$40.00
o4-mini$1.10$0.275$4.40
o1$15.00 $7.50 $60.00
o3-mini$1.10 $0.55 $4.40
GPT-4o$2.50$1.25$10.00
GPT-4o mini$0.15$0.075$0.60
GPT-4.1$2.00$0.50$8.00
GPT-4.1 mini$0.40$0.10$1.60
GPT-4.1 nano$0.10$0.025$0.40

緩存輸入 ( Cached Input ) 定價適用於那些在 API 調用之間重複使用部分輸入內容的應用場景 (例如,重複的系統提示或上下文資訊)。使用緩存輸入可以顯著降低成本。值得注意的是,O3 和 O4-mini 的緩存輸入價格相較於其標準輸入價格有 75% 的折扣,而 O3-mini 的折扣為50%。對於 O4-mini 而言,其緩存輸入價格($0.275)僅為 O3-mini ($0.55) 的一半 ,這進一步增強了其在涉及重複上下文的應用中的成本效益,表明 OpenAI 可能在積極鼓勵開發者將其用於注重效率的場景。  

此外,對於可以接受非同步處理的任務,使用 OpenAI 的 Batch API 可能會獲得額外的成本節省。官方資料顯示,使用 Batch API 處理 O3 和 O4-mini 任務可節省 50% 的輸入和輸出費用。

將 O3 和 O4-mini 的價格與之前的推理模型進行比較,可以更清晰地看到其市場定位。例如,之前的旗艦推理模型 O1 定價為$15(輸入)/$60(輸出) ,而更強大的 O1-pro 定價高達$150(輸入)/$600(輸出) 。相比之下,O3 的價格 ($10/$40) 低於 O1,而 O4-mini ($1.10/$4.40) 則提供了極具吸引力的成本效益,其輸入/輸出價格與 O3-mini 相同,但緩存輸入價格更低。這種顯著的價格差異清晰地劃分了 O3 和 O4-mini 的目標市場:O3 面向需要頂級性能的用戶,而 O4-mini 則面向追求高性價比和效率的廣大開發者。

技術規格

o4-mini 與 o3 保持一致

  • 上下文窗口 ( Context Window ): 200,000 tokens
  • 最大輸出 Token 數( Max Output Tokens ): 100,000 tokens
  • 知識截止日期( Knowledge Cutoff ): 2024年5月31日

使用限制(Plus 用戶)

  • o3:每週100次對話
  • o4-mini:每天300次對話
  • o4-mini-high:每天100次對話

選擇合適的模型

在 O3 和 O4-mini 之間進行選擇,本質上是在最高推理能力(O3)與速度/成本效益(O4-mini)之間做出權衡。

  • 選擇 O3 的場景:當任務需要最高水平的複雜推理、多方面分析、在編碼/科學/視覺方面追求最前沿的性能,且成本是次要考慮因素時,O3 是理想的選擇 。例如,深度科學研究分析、複雜的軟體工程挑戰、高級創意生成等。  
  • 選擇 O4-mini 的場景:當應用需要強大的推理能力 (尤其是在數學和編碼方面),但同時優先考慮速度、低延遲、高吞吐量和顯著降低的成本時,O4-mini 更為合適 。例如,大規模數據分析、應用程序中的實時推理支持、成本敏感的教育工具、數學/編碼輔導機器人等。  
  • O4-mini vs. O3-mini:對於目前使用 O3-mini 的用戶而言,O4-mini 提供了一個極具吸引力的升級路徑。它在多個方面 (尤其是在非 STEM 領域和數據科學方面 ) 提供了相當或更優的性能,擁有特別出色的數學能力 ,並且具有更低的緩存輸入成本 ,適用於大多數追求效率的用例。    

O4-mini 的出現,以其強大的性能 (在某些領域接近甚至超越 O3) 和極低的成本,代表著先進 AI 推理能力向更廣泛用戶普及的重要一步。過去,頂級的推理能力往往伴隨著高昂的價格。O4-mini 以接近先前 mini 系列的價格點提供了高水平的推理能力,降低了開發者和企業實驗和部署推理模型的門檻。這種可及性的提高,有望在教育、小型企業工具以及其他受成本限制的領域激發新的創新應用。

進一步閱讀
  1. OpenAI 推出全新 ChatGPT 模型 o3-mini 與 o3-mini-high,強勢迎戰 DeepSeek