【職場外掛】告別加班!如何利用 NotebookLM + PARTS 架構秒產「設計師級」簡報草稿

如何利用 NotebookLM + PARTS 架構秒產「設計師級」簡報草稿

身為忙碌的上班族,你一定經歷過這種時刻:手上有一堆 PDF 報告、會議記錄或市場分析,老闆卻要求你「明天早上生出一份精美的簡報」。

你面對空白的 PowerPoint 發呆,心想:「我要怎麼把這 50 頁文字變成 10 張有重點、有邏輯,還要看起來很專業的投影片?」

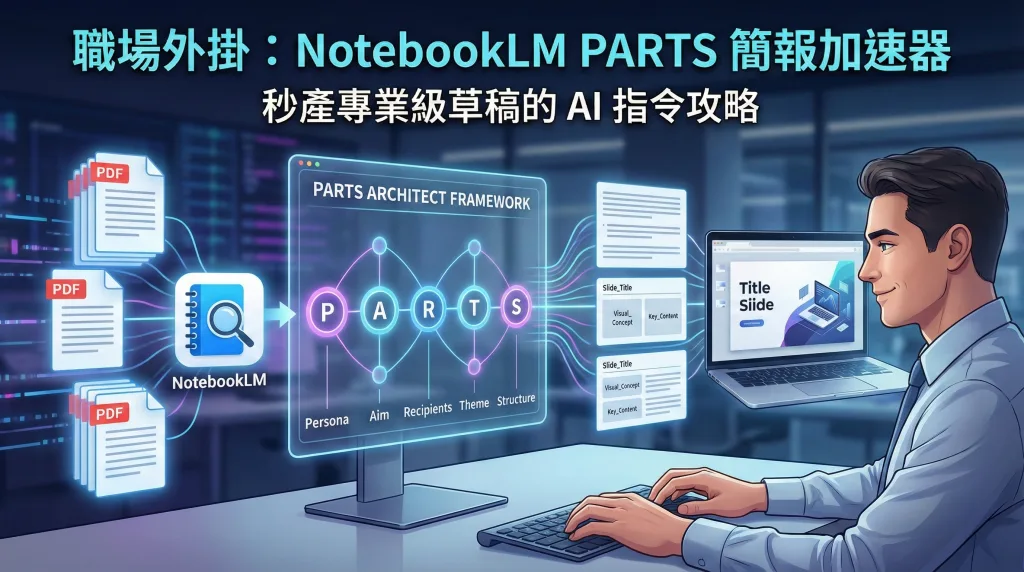
這就是這個 GEM — NotebookLM PARTS Presentation Architect 存在的意義。今天這篇文章將教你如何利用 Google 的 NotebookLM 搭配 PARTS 架構,在幾分鐘內將雜亂的資料轉化為結構嚴謹、風格統一,且可以直接複製貼上的簡報內容。

核心概念:什麼是 PARTS 架構?

為了讓 NotebookLM 聽懂你的需求,我們不能只說「幫我做簡報」。我們需要一個精準的指令系統,這就是 PARTS:

  • P (Persona) – 角色設定:你是誰?(是嚴謹的財務長?還是充滿熱情的創業家?)
  • A (Aim) – 目標意圖:這場簡報的目的是什麼?(是要「說服」投資?還是單純「回報」進度?)
  • R (Recipients) – 受眾分析:誰在聽?(是喜歡看大數據的老闆?還是喜歡聽故事的客戶?)
  • T (Theme) – 視覺主題:簡報看起來要像什麼?(極簡 Apple 風?還是沉穩的麥肯錫風?)
  • S (Structure) – 輸出結構:這是最關鍵的一點。 我們要求 AI 輸出「乾淨的純文字」,不要有討厭的 Markdown 符號(如 ** 或 ##),方便你直接複製到 PPT。

適用場景:你何時需要這個「外掛」?

場景痛點PARTS 架構解決方案
季度業務匯報數據繁雜,容易變成「念稿大會」。設定 Aim 為「凸顯成長亮點」,並要求 Structure 專注於數據視覺化描述。
新產品提案 (Pitch)只有文字概念,缺乏感染力。設定 Theme 為「充滿未來感」,並要求 Persona 為「激勵人心的演說家」。
教育訓練 / Onboarding內容枯燥,新員工想睡覺。設定 Recipients 為「職場新手」,並要求 Visual_Concept 採用生動的插畫風格。
風格模仿老闆說:「我要這張圖的感覺!」利用 Vision Mode,上傳參考圖,讓 GEM 直接提取配色與氛圍注入指令。

實戰教學:三步驟快速生成專業簡報

步驟一:餵食資料 (NotebookLM 端)

打開 NotebookLM,建立一個新筆記本,把你手邊的 PDF、Google Doc 或網頁連結丟進去。這是你的「知識庫」。

步驟二:獲取「指令 YAML」(與 GEM 互動)

這一步是魔法發生的關鍵。你不需要自己去 NotebookLM 慢慢下指令,而是先使用 GEM 。

請對 GEM 說出你的需求(範例):

「我有一份關於 2024 電動車趨勢的報告。我要做一份給潛在投資人看的簡報,希望能展現科技感和緊迫感,風格想要像 Cyberpunk(賽博龐克)。請幫我生成 NotebookLM 的指令。」

若是你有參考圖:

(上傳一張極簡風格的圖片)「請分析這張圖的風格,並幫我生成指令,我要用這種風格來介紹公司的年度財報,主題是「這裡輸入簡報主題」,對象是全體員工。」

GEM 會回應給你什麼? 它會給你一段 slide_generation_profile (YAML 代碼)。這段代碼包含了嚴格的控制參數,確保輸出的文字乾淨、結構分明。

參考輸出 YAML 代碼範例:

# Master Directive for NotebookLM (PARTS Framework)
slide_generation_profile:
  # 1. P - Persona & A - Aim
  strategic_core:
    role_definition: "You are a visionary Tech Investment Strategist and Futurist."
    aim_intent: "Create a sense of FOMO (Fear Of Missing Out) and urgency. Frame the 2024 EV trends not just as data, but as a rapid, unstoppable technological revolution that investors must join immediately."
    presentation_goal: "Pitch the 2024 Electric Vehicle Trends report to investors with high energy."
    slide_count_target: 10

  # 2. R - Recipients (The Audience)
  audience_profile:
    target_group: "Potential Investors (VCs, Angel Investors)"
    knowledge_level: "Financially Sophisticated, Tech-Aware"
    language_style: "Persuasive, High-Energy, Professional, Visionary (Traditional Chinese Output)"

  # 3. S - Structure (Output Logic & Constraints)
  # [CRITICAL] Enforcing Clean Text Mode
  output_structure:
    format_constraint: "STRICT PLAIN TEXT ONLY. Do NOT use Markdown symbols (such as **, ##, *, -) inside the content fields. Output raw text."
    required_elements_per_slide:
      - "Slide_Title: A powerful, short headline conveying urgency (Plain text, no bolding)."
      - "Visual_Concept: [CRITICAL] A highly detailed prompt for image generation: Cyberpunk aesthetic, neon cyan and magenta lighting, dark futuristic cityscapes, glowing EV circuitry, motion blur to show speed."
      - "Key_Content: 3 concise, data-driven points focusing on growth and ROI (Plain text only, no bullets like '*' or '-')."
      - "Speaker_Script: A compelling narrative script for the presenter. It should sound like a high-stakes tech reveal (Plain text, Traditional Chinese)."

  # 4. T - Theme (Visual & Atmospheric Style)
  theme_directives:
    style_source: "Text Inference (User Request: Cyberpunk/Urgency)"
    visual_atmosphere: "Cyberpunk / High-Tech / Aggressive Innovation"
    color_logic: "Dark Background (Deep Black/Midnight Blue), Neon Accents (Cyan, Magenta, Electric Green)"
    layout_vibe: "High Contrast, Digital Glitch effects, Futuristic HUD elements"

  # 5. Logic Trace
  _generation_log: 
    input_type: "Text Request"
    parts_analysis_note: "User requested 'Cyberpunk' style and 'Urgency'. Adjusted Visual_Concept to include neon/dark aesthetics and Script tone to be persuasive for investors."

輸出風格簡報範例:


關於YAML的補充說明

什麼是 YAML

YAML(全稱是 YAML Ain’t Markup Language)是一種專門用來撰寫設定檔(Configuration Files)的資料格式。

簡單來說,它是開發者用來「給電腦下指令」或「定義系統規則」的一種語言,但它的語法非常接近人類的自然語言,讀起來非常直覺。

為什麼要用 YAML

在 YAML 流行之前,大家常用 XML 或 JSON。相比之下,YAML 有以下特點:

  • 極簡主義:不使用大量的括號({}、[])或標籤(<tag>),畫面乾淨。
  • 縮排排版:它強迫使用「空格」縮排來表示層級關係,這讓結構一目了然。
  • 高可讀性:即使是非技術人員,通常也能一眼看出設定檔在寫什麼。

YAML 的核心語法規則

要寫好一個 YAML 設計檔,主要只需記住這三點:

1. 鍵值對 (Key-Value)

使用冒號加上一個空格來區隔名稱與數值。

app_name: 我的應用程式
version: 1.2.0
2. 層級關係 (Indentation)

使用相同數量的空格來表示子項目(通常是 2 個空格)。

server:
  port: 8080
  timeout: 30s
3. 清單 (Lists)

使用短橫線 - 開頭。

features:
  - 登入功能
  - 購物車
  - 支付介面

雖然 NotebookLM 的官方介面中沒有一個名為「YAML」的按鈕,但透過在「自訂指令(Custom Instructions)」中貼入 YAML 格式的指令碼,確實可以比單純使用白話文更精準地控制簡報的視覺風格。

這在目前的 AI 簡報圈(特別是日本與台灣的設計社群)中是一種進階的技巧。

為什麼要用 YAML 控制

NotebookLM 生成簡報時通常比較「隨機」。如果你只說「幫我做一個科技感簡報」,它可能會給你傳統的深藍色背景。但如果你使用 YAML,你可以精確定義:

  • 視覺主色調(使用 Hex Code 色碼)。
  • 版面排版規則(如:留白比例、網格系統)。
  • 字體與層級(如:標題用粗體、內文用細體)。
  • 元素風格(如:扁平化、普普風、極簡主義)。

步驟三:執行指令 (回到 NotebookLM)

  1. 複製 GEM 給你的那段 YAML 代碼。
  2. 貼上 到 NotebookLM 的對話框中。
  3. 按下 Enter。

結語:讓 AI 成為你的簡報策略長

你不再是單純的「做 PPT 的人」,你是內容的策展人。

  1. 你提供素材 (Source)
  2. GEM 提供策略 (PARTS YAML)
  3. NotebookLM 提供內容 (Content)

下次當老闆在下班前丟給你一份報告時,別慌。打開 NotebookLM,呼叫 PARTS 架構師,然後優雅地在 30 分鐘內完成草稿,準時下班。

準備好試試看了嗎?快告訴它你的簡報主題和對象,立刻為你生成專屬指令!

附錄:如何移除 NotebookLM 浮水印

很多時候我們並不想要上司、同事或簡報讀者知道我們是用 NotebookLM 製作簡報,但是討人厭的浮水印總是如影隨形怎麼辦? 筆者推薦一個可以快速移除浮水印的免費網站工具: SlideSweep 。只要將 NotebookLM 生成的 pdf 檔案上傳到這個網站,就可以刪除 NotebookLM 浮水印。不過由於 NotebookLM 生成的 pdf 本身是圖檔,所以這個工具處理過後的 pdf 檔案圖片及文字的內容會有不同程度失真的情形,讀者可以自行斟酌要不要運用這個工具。

浮水印移除結果:
進一步閱讀
  1. 從 PTCF 到 PARTS:解碼 Google Gemini 時代的 GEM 指令進化論

OpenAI 發布 GPT-5.2:以「代理人思維」重塑 AI 戰場,正面迎擊 Google Gemini 3

OpenAI 發布 GPT-5.2

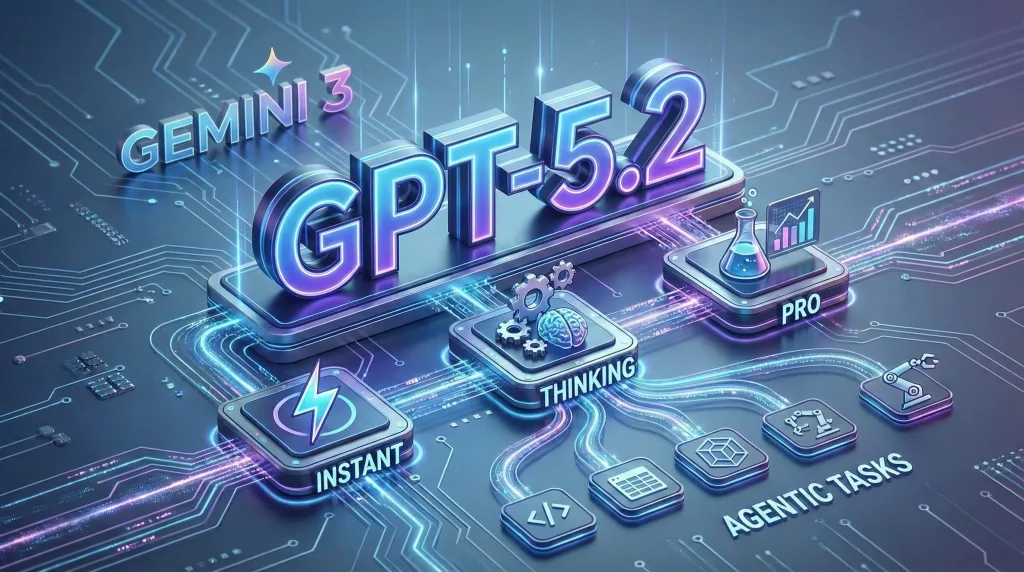
在 Google 發布 Gemini 3 僅數週後,OpenAI 於2025年12月11正式推出了其最新旗艦模型 GPT-5.2。這不僅是一次版本號的迭代,更是 OpenAI 執行長 Sam Altman 所謂「紅色代碼 (Code Red)」策略的最終成果。GPT-5.2 引入了分層模型架構(Instant, Thinking, Pro),並宣稱在複雜的「代理人任務 (Agentic Tasks)」上達到了前所未有的精確度,試圖在 2025 年底重新奪回 AI 霸主的地位。

核心發布:三種模型,一種野心

根據 OpenAI 官方發布的技術文件,GPT-5.2 不再是一個單一模型,而是針對不同場景優化的模型家族。此舉旨在平衡企業對「速度」與「深度推理」的雙重需求。

1. GPT-5.2 Thinking (深度推理版)

這是本次發布的皇冠明珠。OpenAI 聲稱,該模型在 GDPval(衡量 44 種職業知識工作任務的評測)中創下了新的 SOTA (State-of-the-Art) 分數,並且是首個在該測試中表現優於人類專家的模型。

  • 特點: 能夠處理長達數十萬 token 的上下文,並在電子表格創建、簡報製作及複雜編碼任務中展現出「自主修正」的能力。
  • 數據: 在 SWE-Bench Pro(真實軟體工程測試)中,準確率達到 55.6%,遠超前代模型。

2. GPT-5.2 Instant (即時版)

針對日常高頻使用場景設計,強調低延遲與流暢的對話體驗。

  • 定位: 這是 ChatGPT 免費版與 Plus 用戶的預設模型,能自動處理資訊檢索、技術寫作與翻譯,同時保留了更具「人味」的對話語氣。

3. GPT-5.2 Pro (專業版)

僅面向企業 (Enterprise) 與教育 (Edu) 用戶開放。該模型擁有最高的算力配額,專為科學研究與高難度數學問題設計。

  • 科學突破: 在 GPQA Diamond(研究生級別的科學問答)測試中,Pro 版得分高達 93.2%,被定位為科學家的「AI 合作夥伴」。

企業級戰場:從「聊天」轉向「行動」

如果說 2024 年是「生成式 AI」的元年,2025 年則是「代理人 AI (Agentic AI)」的戰場。GPT-5.2 的核心賣點在於其執行能力。

根據 Microsoft 的官方公告,GPT-5.2 已同步登陸 Microsoft Foundry。這意味著企業開發者不再需要手動編寫繁瑣的提示詞來引導模型,GPT-5.2 能夠自主規劃多步工作流。

  • 實例: 模型可以直接生成可運行的單元測試代碼、部署腳本,甚至在不需要人類頻繁介入的情況下完成前端 UI 的設計與 3D 元素構建。

此外,數據平台 Databricks 也宣布整合 GPT-5.2,利用其強大的邏輯推理能力來處理企業內部受監管的敏感數據,這顯示了 OpenAI 在企業端應用上的深入滲透。

市場觀察:回應 Google 的強力反擊

GPT-5.2 的發布時機耐人尋味。市場分析師普遍認為,這是 OpenAI 對 Google Gemini 3 的直接回應。

在 Gemini 3 於 11 月發布並在多項基準測試中超越 GPT-5.1 後,OpenAI 內部啟動了緊急優先級調整。OpenAI 高層將此視為「生存之戰」,並將所有資源集中於 GPT-5.2 的推理能力優化。

Engadget 的資深編輯 Igor Bonifacic 評論道:「OpenAI 必須證明他們不僅僅是先發優勢者。GPT-5.2 承載著證明該公司仍擁有技術護城河的重任,特別是在 Google 與 Anthropic 步步進逼的當下。」

結語:AI 的「思考」時代

GPT-5.2 的問世標誌著 LLM (大型語言模型) 正式進入「System 2 Thinking(慢思考)」時代。透過在回答前進行深度的邏輯推演(Chain of Thought),AI 不再只是概率性的文字接龍,而是具備了解決真實世界複雜問題的潛力。

對於投資者與企業而言,接下來的觀察重點將是:這些昂貴的「推理型模型」能否真正轉化為生產力的倍增,而不僅僅是演示影片中的噱頭。

進一步閱讀
  1. GPT-5.3 正式上線!OpenAI 最新模型聚焦實用性,舊版將於 6 月淘汰

迪士尼 (Disney) 震撼佈局:注資 OpenAI 10 億美元,米奇與漫威宇宙將進駐 Sora

迪士尼 (Disney) 震撼佈局:注資 OpenAI 10 億美元,米奇與漫威宇宙將進駐 Sora

在好萊塢與矽谷的博弈歷史中,這或許是最具分水嶺意義的一刻。向來以「IP 堡壘」著稱、對版權保護極度嚴苛的迪士尼 (The Walt Disney Company),於2025年12月11日宣佈與 OpenAI 達成一項為期三年的歷史性戰略協議。這項交易不僅包含迪士尼對 OpenAI 進行約 10 億美元 (約 1,500 億日圓) 的股權投資,更將開放其最珍貴的資產—包括米奇、漫威 (Marvel) 超級英雄與星際大戰 (Star Wars) 角色—供 OpenAI 的影片生成模型 Sora 使用。

這一舉動標誌著娛樂巨頭從「防禦 AI」轉向「全面擁抱 AI」,並試圖重新定義內容創作的未來。

協議核心:IP 解鎖與資本綁定

根據雙方聯合聲明及外媒披露的細節,這項合作的規模與深度遠超業界預期。這不僅僅是一個授權合約,更是一場資本與技術的深度聯姻。

1. 10 億美元的戰略賭注

迪士尼同意向 OpenAI 注資 10 億美元,並獲得購買額外股權的認股權證 (Warrants)。這顯示迪士尼不只想做客戶,更希望從 OpenAI 的估值增長中獲利,將其視為長期戰略資產(新聞來源: CBS News )。

2. 200+ 經典角色的「AI 化」

這是協議中最具爆炸性的部分。OpenAI 的影片生成模型 Sora 將獲得官方授權,使用超過 200 個 迪士尼旗下的經典角色。

  • 範圍: 涵蓋迪士尼動畫 (Disney Animation)、皮克斯 (Pixar)、漫威 (Marvel) 以及星際大戰 (Star Wars) 宇宙。
  • 應用: 用戶可以透過文字指令 (Prompt),合法地生成包含鋼鐵人、尤達大師或愛莎女王 (Elsa) 的短影音。
  • ChatGPT 整合: 除了影片,ChatGPT 的圖像生成功能也將同步解鎖這些 IP 的創作權限(新聞來源: AP News )。

3. Disney+ 的 UGC 新戰場

這項合作最激進的實驗在於發行通路。迪士尼計畫挑選由 Sora 用戶創作的高品質「粉絲二創」影片,並將其上架至 Disney+ 串流平台。這意味著 Disney+ 將從純粹的專業影視平台 (PGC),部分轉型為擁抱用戶生成內容 (UGC) 的混合平台,試圖以此黏住更年輕的世代(新聞來源: Mint )。

策略轉向:一手握手,一手揮刀

迪士尼執行長 Bob Iger 在接受採訪時表示:「這次合作讓我們能負責任地擴展故事的邊界。」然而,這項交易的時機點極具戲劇性張力,揭示了迪士尼精明的「雙軌策略」。

區隔「合作者」與「侵權者」

就在宣佈與 OpenAI 合作的同時,迪士尼對 Google 發出了嚴厲的停止終止信 (Cease and Desist),指控 Google 的 AI 模型非法使用迪士尼內容進行訓練。

  • 對 OpenAI: 透過付費授權與股權綁定,建立「合規」的 AI 開發模式。
  • 對 Google: 透過法律行動,畫出「未經授權即侵權」的紅線。

這種策略清晰地向矽谷傳達了一個訊息:迪士尼不反對 AI,但反對「免費」的 AI。只有支付足夠代價的科技巨頭,才能獲得米奇老鼠的入場券(新聞來源:  AP News )。

產業衝擊與安全護欄

對於好萊塢創意社群而言,這項消息喜憂參半。為了平息創作者的焦慮,雙方在協議中設下了明確的「護欄 (Guardrails)」:

  • 僅限虛擬角色: 協議涵蓋動畫與虛擬角色,但不包含真人演員的肖像或聲音。這意味著你可以生成「胡迪 (Woody)」,但不能複製湯姆·漢克斯 (Tom Hanks) 的聲音;可以生成「鋼鐵人」的盔甲,但不能生成小勞伯·道尼 (Robert Downey J) 的臉(新聞來源: NDTV Profit )。
  • 兒童安全: 鑑於迪士尼的家庭品牌形象,雙方強調將建立嚴格的過濾機制,確保生成的內容符合安全標準,避免 IP 被用於不當或成人向的創作。

分析師觀點:雙贏的豪賭

這筆交易對雙方都至關重要:

  • 對 OpenAI 而言: 獲得了全球最有價值的 IP 庫,這是對抗 Google Veo 與其他 AI 影片模型的最大護城河,同時也證明了其技術能符合好萊塢嚴苛的版權標準。
  • 對迪士尼而言: 透過 10 億美元投資,不僅鎖定了未來的技術紅利,更主動掌握了 AI 二創的話語權,避免在生成式 AI 浪潮中被邊緣化。

隨著 2026 年初這些功能預計正式上線,我們即將見證「官方授權同人創作」時代的來臨。

Google 推出2025年12月核心演算法更新(12/11發布,12/29完成推出)

Google推出2025年12月核心演算法更新

Google 在 2025 年尾聲再次調整搜尋演算法。根據 Google搜尋狀態儀表板 (Google Search Status Dashboard) 的最新事件紀錄(Incident ID:  Dsir  qJ1gpPRgVQeccPRv ),該公司已確認於 太平洋標準時間 (PST) 12 月 11 日上午 09:25 正式啟動 2025年 12 月核心更新 (December 2025 core update)。

這項消息對於正處於 Q4 銷售衝刺期的電子商務網站與數位行銷人員來說,意味著必須在未來幾週密切監控流量變化。

官方數據:更新剛起步,預計持續至跨年

與過去部分僅需一週完成的更新不同,Google 這次在儀表板上的備註中明確指出:

「已釋出 2025 年 12 月核心更新。部署作業可能需要長達 3 週才能完成。」(Released the December 2025 core update. The rollout may take up to 3 weeks to complete.)

這意味著搜尋結果頁 (SERP) 的排名波動 (Volatility) 可能會一路持續至聖誕節甚至跨年期間。

這次更新為何關鍵?

雖然 Google 尚未針對此次更新發布詳細的部落格文章,但核心更新 (Core Updates) 傳統上旨在廣泛地重新評估網站內容的品質。

根據 Google Search Central 的官方說明文件,核心更新並非針對單一違規行為(如垃圾內容),而是提升整體系統對內容「實用性」與「權威性」的理解。對於在之前更新(如 8 月或 10 月)中排名受影響的網站來說,這通常是獲得「平反」或面臨進一步下修的關鍵時刻。

站長現在該做什麼?

由於更新才剛推出不到 24 小時,SEO 專家建議目前應採取「靜觀其變」的策略:

  1. 監控而非行動:在更新標示為「已完成 (Completed)」之前,排名的劇烈跳動是正常現象,此時進行大幅度修改可能導致誤判。
  1. 關注儀表板狀態:請持續追蹤官方連結提供的即時進度。
  1. 對照官方指南:若發現流量顯著下滑,應回歸 Google 的 核心更新說明文件 ,檢視網站內容是否符合 E-E-A-T(經驗、專業、權威、信任)標準。

從 PTCF 到 PARTS:解碼 Google Gemini 時代的 GEM 指令進化論

從 PTCF 到 PARTS:解碼 Google Gemini 時代的指令進化論

「語言是人類思想的邊界,而在人工智能時代,指令(Prompt)則是我們拓展這條邊界的唯一工具。」

中文語音摘要

第一章:人機對話的簡史—從精確命令到模糊語義

在計算機科學的發展長河中,人類與機器的溝通方式經歷了三次巨大的典範轉移。

第一次是打孔卡與組合語言的時代。那時,我們必須像操作精密鐘錶一樣,精確地撥動每一個暫存器。錯一個位元,整台機器便會停擺。那是「人遷就機器」的時代,溝通的成本極高,但歧義性為零。

第二次是高階程式語言與圖形介面(GUI)的時代。我們開始用接近人類邏輯的 if-then 語句或滑鼠點擊來指揮電腦。雖然門檻降低了,但我們依然是在一個預設好的框架內,進行有限的選擇。

而現在,我們正處於第三次浪潮—自然語言交互(NLI)的生成式 AI 時代。這是人類歷史上第一次,機器試圖理解我們的「意圖」,而非僅僅執行我們的「命令」。

在這個時代初期,為了讓那還不夠聰明的 AI 聽懂人話,研究者總結出了 PTCF 架構。它像是一座橋樑,連接了人類模糊的需求與 AI 統計學的預測。然而,隨著 Google Gemini 等多模態模型(Multimodal Models)的崛起,這座橋樑似乎顯得不夠寬闊了。於是,PARTS 架構應運而生。

這不僅僅是一個縮寫詞的更替,它反映了 Google 對於「人機協作」理解的本質深化。

第二章:古典時代的王者—PTCF 架構的回顧

2.1 PTCF 的誕生背景

在 ChatGPT 剛橫空出世,以及 Google Bard(Gemini 的前身)尚在襁褓之時,大眾對於如何與 AI 對話感到迷茫。許多人只會輸入「寫一篇文章」或「翻譯這段話」,然後對產出的平庸內容感到失望。

這時,PTCF 作為一種結構化的提示工程方法論,迅速成為了業界標準。它簡潔有力,涵蓋了指令的四個核心維度:

  1. Persona (角色):你希望 AI 扮演誰?
  2. Task (任務):你希望 AI 做什麼?
  3. Context (背景):AI 需要知道哪些前置資訊?
  4. Format (格式):你希望產出是什麼樣子?

2.2 PTCF 的運作邏輯

PTCF 的美學在於它的「功能主義」。它像是一份標準的工廠訂單:

  • Persona: 你是一位資深程式設計師。
  • Task: 請解釋 Python 中的遞迴函數。
  • Context: 對像是剛入門的大學生,請用生活化的比喻。
  • Format: 輸出為一篇 500 字的短文,包含一段代碼範例。

在單一文本生成(Text-to-Text)的時代,PTCF 完美地解決了「指令不清晰」的問題。它強迫使用者在發問前進行思考,從而大幅提升了 AI 的回應品質。

然而,隨著 AI 模型參數量的爆炸性增長,以及 Gemini 這種原生多模態模型的出現,我們發現 PTCF 開始顯得有些「粗顆粒」。

第三章:分水嶺—為何 Google 轉向 PARTS?

這是一個值得深思的問題:為什麼 Google 在其最新的 AI Essentials 課程與教育推廣中,開始全面轉向 PARTS 架構?

這並非是為了創造新詞彙的行銷手段,而是基於以下三個技術演進的必然:

3.1 從「執行者」到「創作者」的轉變

PTCF 中的 Task (任務) 隱含了一種「執行」的意味—我下令,你執行。但在 Gemini 3 Pro 甚至 Think 模型中,AI 展現出了驚人的推理與創造能力。我們需要的不再僅僅是執行一個動作,而是達成一個目標 (Aim)。

3.2 「背景」的解構與重組

在 PTCF 中,Context (背景) 是一個巨大的垃圾桶。使用者往往將「受眾是誰」、「語氣如何」、「限制條件」通通丟進 Context 裡。這導致 AI 在處理長上下文(Long-context window)時,容易混淆權重。

PARTS 敏銳地將 Context 拆解為 Recipients (受眾) 和 Theme (主題/風格)。這一步拆解至關重要。因為在大型語言模型(LLM)的注意力機制(Attention Mechanism)中,「對誰說」(受眾)和「怎麼說」(風格)往往比「說什麼」(內容)更能決定輸出的品質。

3.3 對「結構」的重新定義

PTCF 的 Format 通常被理解為「形式」(如:表格、清單、PDF)。而 PARTS 中的 Structure 則更進一步,它暗示了內容的邏輯結構(如:先總後分、英雄之旅的敘事結構、或是特定的思考鏈 CoT)。

因此,從 PTCF 到 PARTS,實際上是從「指令式編程」思維向「聲明式目標」思維的跨越。

第四章:深度解碼 PARTS 模型—Gemini 的原生語言

現在,讓我們像拆解精密儀器一樣,逐一剖析 PARTS 的五個組件。這不僅是 Google 推薦的架構,更是目前驅動 Gemini 進行複雜推理的最佳實踐。

4.1 P – Persona (角色:確立身分)

這點與 PTCF 相同,但在 PARTS 中,角色的定義需要更具「具身性」(Embodiment)。

  • 舊式寫法:「你是一個行銷專家。」
  • PARTS 寫法:「你是一位擁有 15 年經驗的 B2B SaaS 產品行銷總監,擅長以數據驅動的敘事方式打動企業決策者。」

筆者點評:給予 AI 角色,本質上是在高維向量空間中,限定了它的檢索範圍。你定義得越精細,它的「聯想」就越專業。

4.2 A – Aim (目標:明確意圖)

這是對 Task 的升級。Task 是「寫一封信」,Aim 是「寫一封能讓客戶點擊連結的信」。Aim 聚焦於結果與目的,而非僅僅是動作。

  • 核心心法:使用強動詞(Strong Verbs),並附帶「為了…」(In order to…)的意圖說明。

4.3 R – Recipients (受眾:定義聽眾)

這是 PARTS 最具戰略意義的新增維度。Gemini 具有極強的語義適配能力,同樣的內容,解釋給「五歲小孩」、「大學教授」或「投資人」聽,其用詞的複雜度(Perplexity)與句式結構截然不同。

  • 關鍵操作:不僅要說出受眾是誰,最好描述他們的痛點或知識水準。
    • 例:「受眾是對 AI 有恐懼感的傳統製造業老闆。」

4.4 T – Theme (主題/風格:設定調性)

Theme 涵蓋了 Tone (語氣)、Style (風格) 以及 Context (背景) 中關於內容氛圍的部分。

  • 為什麼獨立出來? 在多模態時代,Theme 還可能包含對圖片風格、色彩情緒的描述。對於文字,它決定了是「嚴肅學術」還是「幽默詼諧」。
  • 進階技巧:可以指定模仿特定作家的風格(例如:海明威的極簡主義)。

4.5 S – Structure (結構:規範輸出)

這超越了簡單的 Format。你可以在這裡要求 AI 使用特定的思維框架。

  • 例:「請使用『現狀-問題-解決方案』(S-P-S) 的結構進行論述,並最後以表格呈現關鍵數據。」

第五章:PTCF vs PARTS — 實例對決

為了讓讀者更直觀地理解兩者的差異,我們來進行一場「實戰演練」。假設我們的任務是:推廣一款新的降噪耳機。

回合一:使用 PTCF 架構

Prompt:

  • Persona: 你是文案寫手。
  • Task: 寫一篇關於我們新款降噪耳機 X-1000 的 Instagram 貼文。
  • Context: 這款耳機降噪效果很好,電池續航 30 小時,適合通勤族。
  • Format: 貼文形式,包含 Hashtags。

AI 產出預測 (PTCF): 這會是一篇中規中矩的貼文,列出功能,加上幾個標籤。它合格,但缺乏靈魂,因為它不知道是寫給誰看的,也不知道要用什麼語氣(是激動的?還是冷靜專業的?)。

回合二:使用 PARTS 架構

Prompt:

  • Persona: 你是一位生活風格部落客,專注於都會通勤與極簡主義生活,擁有敏銳的審美與挑剔的品味。
  • Aim (目標):撰寫一篇引人入勝的 Instagram 貼文,目的是激發讀者對「寧靜私人空間」的渴望,進而對 X-1000 耳機產生興趣。
  • Recipients (受眾):在喧囂城市中工作,渴望在捷運上擁有片刻安寧的 25-35 歲年輕專業人士。
  • Theme (風格):感性、沉浸式、帶有一點詩意,避免過度推銷的商業口吻。
  • Structure (結構):先描述一段城市噪音的場景(痛點),再引入戴上耳機後的「切換感」(解決方案),最後以一個引發共鳴的問題結尾。

AI 產出預測 (PARTS):

「台北的早晨,捷運的廣播聲、人群的嘈雜聲… 這是我們每天不得不面對的戰場。🚇

但你知道嗎?世界上有一個開關,能讓這一切瞬間靜音。當我戴上 X-1000,世界彷彿被按下了暫停鍵。不再是為了隔絕聲音,而是為了留住心裡的那份平靜。30 小時的續航,足夠你從週一的焦慮,聽見週五的自由。

如果可以選擇,你最想在這個城市裡關掉哪種聲音?👇

#城市隱士 #X1000 #降噪耳機 #通勤日常 #極簡生活」

筆者點評: 看出了嗎?PTCF 產出的是說明書,而 PARTS 產出的是共鳴。在 PARTS 架構中,我們通過 Recipients 和 Theme 的精確定義,激發了 Gemini 在語義空間中更深層次的連接能力。這就是為什麼 Google 堅持推動 PARTS 的原因—為了讓 AI 從「工具人」進化為「懂你的夥伴」。

第六章:迭代的藝術—從 PARTS 到「完美指令」的距離

「沒有完美的演算法,只有最適合當下數據分佈的演算法。同理,也沒有一步到位的 Prompt,只有在不斷迭代中趨於完美的對話。」

許多人在學習了 PARTS 架構後,往往會陷入一個誤區:認為只要填滿了 P-A-R-T-S 這五個空格,Gemini 就會吐出諾貝爾獎等級的內容。然而,真實的 AI 互動並非線性的一錘子買賣,而是一個遞迴(Recursive)的優化過程。

在 Google 的工程文化中,我們講究「快速失敗,快速迭代」。這一點在 Prompt Engineering 中同樣適用。

6.1 指令除錯(Prompt Debugging)

當 Gemini 的輸出不符合預期時,我們不應僅僅是再次點擊「Regenerate」,而應該像檢查程式碼一樣,回頭審視 PARTS 的各個環節。以下是一套基於 PARTS 的除錯清單:

  • 如果內容太過空泛、缺乏深度:
    • 檢查 P (Persona):你的角色設定是否太過通用?將「工程師」改為「擁有 10 年分散式系統架構經驗的後端工程師」,你會發現 AI 調用的詞彙庫瞬間升級。
    • 檢查 S (Structure):你是否給予了具體的思考框架?嘗試要求它使用「第一原理思考」或「SWOT 分析」來展開論述。
  • 如果語氣不對,讀起來像機器人:
    • 檢查 T (Theme):你是否只寫了「專業」?嘗試加入更細膩的形容詞,如「帶有同理心的」、「嚴謹但不枯燥的」、「如同 TED 演講般的」。
    • 檢查 R (Recipients):AI 可能誤判了受眾的理解能力。明確指出受眾的背景知識(Prior Knowledge),例如「假設受眾完全不懂技術術語」。
  • 如果 AI 答非所問或偏離焦點:
    • 檢查 A (Aim):你的目標動詞是否不夠強烈?將「描述…」改為「說服…」或「批判性地分析…」。
    • 引入負向提示 (Negative Prompting):在 Structure 中明確列出「不要做什麼」。例如:「請勿使用陳腔濫調的行銷術語」、「不要列點,請使用敘事性段落」。

6.2 上下文視窗(Context Window)的戰略應用

Gemini 3 Pro 擁有驚人的 100 萬 token(甚至 200 萬)上下文視窗。這意味著我們可以在 PARTS 架構中,嵌入前所未有的巨量資訊。

這帶來了一種新的指令模式:In-Context Learning (上下文學習) 的極致化。

在 S (Structure) 或 Context (隱含在 Theme 中) 的部分,我們不再只是給予一兩個範例(Few-shot),而是可以上傳整本風格指南(Brand Guidelines)、過去成功的 50 篇文案,甚至是整個專案的代碼庫。

此時,PARTS 中的 Structure 應包含一條指令:「請嚴格參考上傳文件中的語氣與邏輯進行生成。」這使得 Gemini 不再是依靠訓練數據中的「通用知識」來回答,而是基於你提供的「私有知識」進行推理。這對於企業級應用至關重要,因為它大幅降低了幻覺(Hallucination)並提升了品牌一致性。

第七章:陰影下的挑戰—PARTS 無法解決的問題

雖然 PARTS 是目前最先進的通用指令架構,但我們必須保持清醒:它不是萬靈丹。在與大型語言模型博弈的過程中,即使是最完美的 PARTS 指令,也面臨著內在的熱力學熵增—即不確定性。

7.1 複雜度的代價 (The Cost of Complexity)

撰寫一個高品質的 PARTS 指令需要時間。如果你的任務只是「幫我把這段話翻成英文」,使用繁瑣的 PARTS 架構顯然是殺雞用牛刀,甚至可能因為指令過長而引入不必要的雜訊。

筆者觀點:在工程學中,我們追求的是「性價比」。對於簡單任務,PTCF 甚至簡單的 Zero-shot 指令依然有效。PARTS 應該被視為一種「重型武器」,用於處理複雜推理、長文寫作或高風險的商業決策輔助。

7.2 模型的注意力分散 (Attention Dispersion)

這是提示工程中一個反直覺的現象:有時候指令寫得越長、越細,模型反而表現得越差。

這與 Transformer 架構的注意力機制有關。當 Prompt 過長,模型可能會在眾多約束條件中迷失,「忘記」了早期的某些指令(這被稱為 “Lost in the Middle” 現象)。

應對策略: 如果你的 PARTS 指令超過了 500 個單詞,建議採用 Chain of Thought (CoT) 策略,將一個巨大的 PARTS 指令拆解為多個步驟的對話:

  1. 第一輪:設定 P 和 R,確認 AI 理解角色與受眾。
  2. 第二輪:提供 A 和 T,要求 AI 生成大綱。
  3. 第三輪:提供 S,要求 AI 根據大綱撰寫正文。

這種「分而治之」(Divide and Conquer)的策略,是計算機科學解決複雜問題的基石,同樣適用於 AI 指令控制。

7.3 刻板印象的放大器

在設定 P (Persona) 時,我們必須格外小心。如果你設定「你是一位嚴厲的傳統數學老師」,AI 可能會無意中表現出性別刻板印象或過度的攻擊性。PARTS 架構增強了 AI 的角色扮演能力,同時也放大了訓練數據中隱含的社會偏見。

作為指令的設計者(Prompt Designer),我們有責任在 T (Theme) 中加入道德約束,例如:「保持客觀中立」、「避免性別預設」。

第八章:跨越模態—PARTS 在多模態時代的變形

我們正處於從「文字網路」向「多模態網路」遷移的關鍵時刻。Gemini 的核心優勢在於其原生多模態(Native Multimodal)能力。那麼,PARTS 架構能否應用於生成圖片、影片或分析音訊呢?

答案是肯定的,但需要進行語義上的「轉義」。

8.1 視覺生成中的 PARTS

當我們使用 Gemini 或 Nano Banana 生成圖像時,PARTS 的定義發生了微妙的變化:

  • P (Persona/Medium):這裡的「角色」轉化為「媒介」。
    • 例:「你是一台裝有 35mm 鏡頭的 Leica 相機」或「你是一位印象派油畫家」。
  • A (Aim/Subject):目標轉化為「主體內容」。
    • 例:「一隻在雨中奔跑的柴犬」。
  • R (Recipients/Viewer):受眾轉化為「觀看者視角」或「構圖」。
    • 例:「低角度仰視拍攝」、「微距視角」。
  • T (Theme/Lighting & Style):風格轉化為「光影與藝術風格」。
    • 例:「賽博龐克霓虹光」、「柔和的自然光」、「吉卜力工作室風格」。
  • S (Structure/Composition):結構轉化為「畫面佈局」。
    • 例:「黃金分割構圖」、「主體位於畫面中央」。

8.2 影片與音訊分析

當你上傳一段財報會議的錄音檔給 Gemini 並要求分析時:

  • P:你是資深財務分析師。
  • A:提取管理層對未來一季的營收指引(Guidance)。
  • R:投資人。
  • T:客觀、數據驅動。
  • S:這點最關鍵。你可以要求 AI 結合時間戳記(Timecode)。
    • 例:「請列出關鍵論點,並附上錄音檔中的具體時間點(mm:ss),以便我回聽查證。」

這證明了 PARTS 架構具有極強的泛化能力(Generalization),它是處理資訊的一種通用拓撲結構,而不僅僅是文字遊戲。

第九章:未來展望與結論—人機協作的新契約

9.1 AI Agent 與自動化指令

展望未來,隨著 AI Agent(智能體) 的興起,我們可能不再需要每次都手動撰寫 PARTS 指令。

未來的系統可能會演變成這樣:你只需給出一個模糊的意圖(例如:「幫我策劃一場婚禮」),一個「Meta-Prompting System」(元指令系統)會自動在後台為你生成五個不同的 PARTS 指令,分別指派給負責預算、場地、菜單的子 Agent。

但在那個時代到來之前,掌握 PARTS 架構,就等於掌握了指揮這些數位勞動力的「程式語言」。

9.2 結論:回歸人的價值

在結束這篇長文之際,回到一個哲學問題:如果 AI 能寫出完美的指令,人類還剩下什麼?

從 PTCF 到 PARTS 的演進,表面上是技巧的提升,實則是對人類「提問能力」的更高要求。AI 可以幫你寫作、幫你畫圖、幫你寫程式,但它無法替你定義什麼是有價值的問題。

PARTS 中的 Aim (目標) 和 Recipients (受眾),始終需要人類的同理心與價值判斷來填充。機器擁有算力,但人類擁有意義。

在這個 AI 搜尋與生成的新時代,優化指令不是為了取悅演算法,而是為了更清晰地梳理我們自己的思緒。正如《聖經》所言:「太初有道」(In the beginning was the Word)。在 AI 的世界裡,那句 Prompt,就是你的「道」。願你能善用 PARTS,在這個新世界中,創造出屬於你的光。

FAQ 問答集

為了滿足讀者在閱讀完本文後可能產生的延伸疑問,以下整理了 5 個核心問答。

Q1: PARTS 架構一定比 PTCF 架構好嗎?在什麼情況下我應該繼續使用 PTCF?

A: 並不盡然。PARTS 與 PTCF 的關係並非「替代」,而是「升級與互補」。

  • PARTS 適合需要高創意、複雜推理、長文本生成或特定語氣風格的任務(如:撰寫行銷文案、商業分析報告、角色扮演)。它提供了更細膩的控制變數。
  • PTCF 則在處理簡單、明確、功能導向的任務時依然高效(如:數據格式轉換、簡單翻譯、代碼除錯)。 結論:殺雞焉用牛刀。若任務單一且明確,PTCF 的效率更高;若任務涉及模糊意圖與風格調控,PARTS 是不二之選。

Q2: 我可以在 ChatGPT 或 Claude 上使用 Google 的 PARTS 架構嗎?

A: 完全可以。雖然 PARTS 是 Google 在推廣 Gemini 時提出的架構,但其底層邏輯是基於大型語言模型(LLM)通用的注意力機制與語義理解原理。 無論是 GPT、Claude 還是 Llama ,它們都受益於清晰的角色設定(P)、明確的目標(A)和受眾分析(R)。事實上,由於 PARTS 強調了「受眾」與「結構」,在 Claude 這種擅長長文寫作的模型上,使用 PARTS 往往能獲得比在 Gemini 上更驚豔的效果。

Q3: 初學者如何快速練習寫出高品質的 PARTS 指令?有無捷徑?

A: 最快的捷徑是「讓 AI 幫你寫」(Meta-Prompting)。 你可以創建一個這樣的指令:「你是一位 Prompt Engineering 專家。我想完成 [你的任務],請根據 PARTS 架構(Persona, Aim, Recipients, Theme, Structure),幫我撰寫一個最佳化的指令,讓我可以用來輸入給 AI。」 透過逆向工程,觀察 AI 如何將你模糊的需求轉化為結構化的 PARTS 指令,是學習速度最快的方法。此外,建立個人的「Prompt Library」(指令庫),將常用的 PARTS 模組存儲起來,也能大幅提升效率。

Q4: 在 PARTS 架構中,最容易被忽略但最關鍵的要素是哪一個?

A: 經驗顯示,Structure (結構) 和 Recipients (受眾) 是最常被忽略的。 大多數人習慣只給任務(Aim),卻忘了告訴 AI「怎麼組織內容」(Structure)。這導致 AI 輸出的內容往往是一大塊缺乏層次的文字。明確要求「使用 H2/H3 標題」、「先總結後條列」、「使用表格比較」,能瞬間提升可讀性。 同樣,忽略 Recipients 會導致內容難度不匹配。明確指出受眾層級,能讓 AI 精準調控用詞的難易度(Perplexity),這是區分新手與高手指令的關鍵。

Q5: 隨著 Gemini 模型的升級,PARTS 架構未來會過時嗎?

A: 具體的「縮寫」可能會變,但其核心精神—語境解構(Context Deconstruction)—不會過時。 未來的模型(如 Gemini 4 或 AGI 原型)可能會具備更強的意圖推測能力,使得我們不再需要詳盡地寫出每一個字母。例如,模型可能透過你的歷史數據自動推斷 Persona 和 Theme。 然而,只要人類與機器的溝通仍依賴語言,明確目標(Aim)與規範形式(Structure)的需求就永遠存在。PARTS 可能會簡化為 “AS” 或演變成多模態的互動面板,但它所代表的「結構化溝通思維」將是 AI 時代的基礎素養。

如果你對採用 PARTS 或傳統的 PTCF 結構有選擇困難,也歡迎使用 Leggie 團隊開發的 GEM Instruction Architect GEM 工具。在最新的版本中我們已經加入了 PARTS 與 PTCF 的自動判別機制,系統會根據你的任務內容自動輸出最適合的架構並說明理由。

進一步閱讀
  1. Gemini GEM 指令寫作指南:從入門到精通,打造你的專屬 AI 助理
  2. Gemini Deep Research 最佳提示詞指南
  3. Google Gemini 多模態提示詞指南
  4. Gemini Prompt 專家指南
  5. Gemini Prompt 入門指南