Web3.0 vs Web3: 未來網路的兩種願景

Web3.0

Photo by Bastian Riccardi on Unsplash

在探索網路的未來時,兩個重要的概念浮現在視線中:Web3.0和Web3。這兩種概念都代表了對網路下一階段的願景,但它們的定義、起源和主要特點卻有所不同。本文將深入探討這兩種概念,並比較它們的相似之處和不同之處。

Web3.0的定義和起源

Web3.0,也被稱為語義網,是世界萬維網的創造者Tim Berners-Lee提出的下一代網路的概念。這是一個更連接和智能的線上生態系統,所有的數據都存儲在一個地方,並且用戶可以完全控制誰可以訪問它。Web3.0的目標是使網路能夠以類似人類的智能來處理資訊,從而使用戶能夠通過不同平台的連結來連接所有的線上資訊。

Web3.0的起源可以追溯到2000年代初,當時網路正從Web 1.0的靜態網頁轉變為Web 2.0的互動網路。在這個過程中,人們開始意識到網路的潛力不僅僅是提供資訊,還可以進行交互和創建內容。然而,隨著網路的發展,人們也開始意識到Web 2.0的一些限制,例如資訊的碎片化和用戶數據的隱私問題。為了解決這些問題,Tim Berners-Lee提出了Web3.0的概念,並開始研究如何實現這種新型的網路。

在Web3.0中,數據存儲在所謂的Solid Pods中,這些是用戶的個人資料庫,使得訪問、更新或分享資訊變得無縫。用戶需要一個WebID(類似於加密地址)進行身份識別和訪問數據的授權。這種方式的數據存儲不僅提供了更高的安全性,也使得數據的所有權真正歸還給了用戶。這就是Web3.0的起源和定義,它代表了網路的下一個階段,並將繼續影響我們的線上體驗。

Web3的定義和起源

Web3,有時也被稱為Web 3.0,是由以太坊的共同創始人Gavin Wood在2014年提出的,代表他對於一個更去中心化和民主化的網路的願景。Web3的主要特點是它的去中心化特性,這意味著沒有單一的實體或組織控制網路的所有部分。相反,權力和控制權分散在網路的所有用戶中。

Web3的起源與區塊鏈技術和加密貨幣的興起密切相關。在比特幣的創新之後,以太坊的創建者們看到了區塊鏈技術在去中心化應用(DApps)中的潛力,這些應用可以在網路上提供各種服務,而不需要中央服務器或權威機構。Web3的概念就是在這種背景下誕生的,它的目標是創建一個由用戶和開發人員共同擁有和控制的網路。

在Web3的視角中,網路不再是一個由中央服務器提供服務的平台,而是一個去中心化的生態系統,其中的每個節點都可以提供和接收服務。這種去中心化的設計使得Web3能夠提供更高的隱私保護,並防止單一點故障或攻擊。此外,Web3還強調用戶對自己數據的所有權,這是一種與Web2.0(在Web2.0中,數據通常由服務提供商擁有和控制)截然不同的設計理念。這就是Web3的起源和定義,它代表了一種全新的網路願景,並將對未來的網路產生深遠影響。

Web3.0和Web3的比較

Web3.0和Web3雖然名稱相似,但它們代表的是兩種不同的網路發展願景。這兩種願景在許多方面都有相似之處,但也有一些關鍵的差異。

在相似之處,Web3.0和Web3都強調用戶對自己數據的控制權。在Web3.0中,這是通過將數據存儲在用戶控制的Solid Pods中實現的。在Web3中,這是通過區塊鏈技術實現的,區塊鏈技術允許用戶在不需要中央服務器的情況下進行交易和互動。此外,Web3.0和Web3都強調網路的智能化和連接性,並且都希望創建一個更公平、更民主的網路。

然而,Web3.0和Web3在實現這些目標的方法上有所不同。Web3.0的焦點是創建一個語義網,其中的機器可以理解和處理資訊,就像人類一樣。這需要大量的數據和複雜的機器學習算法。相反,Web3的焦點是創建一個去中心化的網路,其中的每個節點都可以提供和接收服務。這需要區塊鏈技術和智能合約。

結語

Web3.0和Web3對未來網路的影響將是深遠的,並可能在許多方面改變我們的線上體驗。

Web3.0的實現將使網路變得更加智能和連接。機器將能夠理解和處理資訊,就像人類一樣,這將使得搜尋和瀏覽網路變得更加容易和有效。此外,由於所有的數據都存儲在一個地方,並且用戶可以完全控制誰可以訪問它,Web3.0將提供更高的隱私保護和數據安全性。這將使得用戶能夠更自由地分享和使用自己的數據,而不需要擔心隱私被侵犯。

另一方面,Web3將使網路變得更加去中心化和民主化。由於每個節點都可以提供和接收服務,用戶將能夠直接參與網路的運作,而不需要通過中央服務器。這將使得網路更加公平,因為所有的用戶都有機會參與和獲益。此外,由於用戶對自己的數據有完全的控制權,Web3將提供更高的隱私保護和數據安全性。

Web3.0和Web3都將對未來的網路產生重大影響。它們將使網路變得更加智能、連接、去中心化和民主化,並將提供更高的隱私保護和數據安全性。這些變化將深刻地改變我們的線上體驗,並可能帶來許多新的機會和挑戰。

ChatGPT暫停”Browse with Bing”功能

OpenAI disabled "Browse with Bing"

圖片來源:OpenAI官方Twitter

根據PiunikaWeb的報導,ChatGPT的”Browse with Bing”功能已經被暫時停用。這個功能將Microsoft的Bing搜尋引擎整合到對話中,使模型能夠從網路上抓取並呈現資訊。這項整合大大提升了ChatGPT的實用性,將其轉變成一個能夠連接AI與網路的多功能工具。

這個功能的停用讓許多ChatGPT的使用者感到失望。”Browse with Bing”功能原本只對Plus訂閱者開放,訂閱者對於能夠擁有這個額外功能感到非常高興。這個功能提供了無縫的體驗,並提升了整體的使用者體驗。

然而,最近的發展讓使用者感到挫折和不滿。使用者無法使用”Browse with Bing”功能,而是遇到一個錯誤訊息,說明”您的帳戶中有異常的流量”。這個意外的障礙讓那些熱切期待使用這個功能的人感到困惑和惱怒。

更糟的是,支付這個功能費用的使用者現在正在要求退款。他們覺得,既然他們支付了一項現在無法使用的服務,他們應該得到相應的賠償。

OpenAI的支援團隊已經澄清,”Browse with Bing”功能因為技術問題而被暫時停用。該公司承認,這個功能偶爾會顯示不適當或未經意的內容,這導致了其被停用。

OpenAI團隊正在努力解決這些問題,並計劃在功能達到期望的性能和內容準確性後重新推出。然而,他們並未提供功能將何時恢復的具體時間表,讓使用者感到困惑。

如何在Facebook最新動態消息演算法下優化你的社群行銷策略

Meta

圖片來源:unsplash

Facebook已成為全球最大的社群平台,吸引了數十億的用戶。對於企業來說,無論是大型企業還是小型創業公司,Facebook都是一個不可忽視的行銷管道。然而,要在這個龐大的平台上脫穎而出,並成功吸引並保持用戶的關注,就需要深入理解並適應Facebook的動態消息演算法。

Facebook的動態消息演算法決定了用戶在其動態消息上看到哪些內容。這個演算法會根據各種因素,如用戶的行為、與內容創建者的關係,以及內容本身的類型和品質,來決定每一則貼文的顯示順序和優先級。因此,了解這個演算法的運作方式,並根據其規則來優化你的社群行銷策略,對於提高你的貼文的曝光率和參與度非常重要。

本文將深入探討Facebook最新的動態消息演算法,並提供一些實用的策略和建議,幫助你在這個變化莫測的網路世界中,優化你的社群行銷策略,並最大化你的貼文效果。無論你是一個經驗豐富的社群行銷人員,還是剛剛踏入這個領域的新手,這篇文章都將為你提供寶貴的資訊和洞見。

Facebook動態消息演算法的基本概念

Facebook Algorithm

Facebook的動態消息演算法是一種複雜的人工智能系統,由多個機器學習模型組成,這些模型和他們的輸入信號是動態的,並會隨著系統學習和改進而變化。這個系統的主要目的是為每個用戶提供最相關和有價值的內容。

當用戶打開Facebook時,演算法會從數以千計的可能的貼文中選擇一部分來顯示在用戶的動態消息螢幕上。這些可能的貼文來自用戶的朋友、他們關注的頁面,以及他們加入的群組。演算法會考慮各種輸入信號,例如誰創建了貼文,用戶以前如何與他們互動,貼文的類型(例如照片、視頻或連結),以及貼文的人氣等。

在收集了所有可能的貼文後,演算法會運行一個輕量級模型,選擇大約500個最相關的貼文。然後,這些貼文會被送入一個更複雜的模型,該模型會預測用戶對每一則貼文的可能反應,例如點讚、分享、留言或報告為垃圾郵件。最後,這些貼文會根據預測的反應得分進行排序,並顯示在用戶的動態消息上。

這個過程是實時且動態的,每當用戶刷新他們的動態消息螢幕時,都會重新運行。因此,了解這個演算法的運作方式,並根據其規則來優化你的貼文,提高你的貼文的曝光率和參與度。

Facebook最新動態消息演算法的變化

Facebook的動態消息演算法並非一成不變,而是會根據用戶的行為和反饋、社群的變化以及Facebook的目標和價值觀進行調整。近期,Facebook進行了一些重要的更新,這些更新對於社群行銷人員來說具有重大影響。

首先,Facebook增加了對用戶行為的權重。換句話說,如果一個用戶經常與某個頁面或某種類型的貼文互動,那麼該頁面或該類型的貼文在該用戶的動態消息上的顯示優先級將會提高。這意味著,為了提高貼文的曝光率,社群行銷人員需要創建能夠引發用戶互動的內容。

其次,Facebook開始對可能是問題性或低質量的內容進行降級。這包括點擊誘餌連結、可能被報告或隱藏的評論、引誘用戶參與的內容、請求不必要用戶資料的網路連結、低質量的評論、活動、視頻等。這意味著,社群行銷人員需要確保他們的貼文提供有價值的內容,並避免使用可能會被視為問題性或低質量的策略。

最後,Facebook對於健康相關的內容有特別的規定。他們會降級那些有低質量或垃圾健康內容跡象的貼文和連結,例如那些帶有驚人或誇大的健康聲明,以及試圖基於健康相關聲明銷售產品或服務的貼文。這對於在健康和醫療領域進行社群行銷的人員來說,是一個重要的考慮因素。

這些變化顯示,Facebook正在努力為用戶提供更高質量和更相關的內容,並打擊垃圾和誤導性的內容。因此,社群行銷人員需要適應這些變化,並調整他們的策略,以確保他們的貼文能夠達到最佳的效果。

例如,他們需要創建能夠引發用戶互動的內容,提供有價值和高質量的資訊,並避免使用可能會被視為問題性或低質量的策略。對於在健康和醫療領域進行行銷的人員,他們需要特別注意避免使用驚人或誇大的健康聲明,並確保他們的貼文提供準確和實證支持的健康資訊。

如何優化你的社群行銷策略

在Facebook最新的動態消息演算法下,社群行銷人員需要採取一些策略來優化他們的貼文,以提高曝光率和參與度。以下是一些具體的建議:

  1. 創建引人入勝的內容:首先,創建引人入勝的內容是提高用戶參與度的關鍵。這包括分享有價值的資訊,提供獨特的觀點,或者講述吸引人的故事。視覺內容,如照片和影片,通常能夠引起更多的關注和互動。
  2. 鼓勵用戶互動:鼓勵用戶參與並與你的貼文互動,例如留言、分享或點讚,可以提高你的貼文在他們的動態消息上的顯示優先級。你可以問問題,發起討論,或者請求用戶分享他們的想法和經驗。
  3. 定時發布:發布時間也會影響你的貼文的曝光率。你需要找出你的目標受眾在線最活躍的時間,並在這些時間發布你的貼文。
  4. 避免問題性或低質量的內容:根據Facebook的新規定,問題性或低質量的內容會被降級。這包括點擊誘餌連結、可能被報告或隱藏的評論、引誘用戶參與的內容、請求不必要用戶資料的網路連結、低質量的評論、活動、影片等。你需要確保你的貼文提供有價值的內容,並避免使用可能會被視為問題性或低質量的策略。
  5. 遵守健康相關的規定:如果你的貼文涉及健康相關的內容,你需要特別注意避免使用驚人或誇大的健康聲明,並確保你的貼文提供準確和實證支持的健康資訊。

透過這些策略,你可以優化你的社群行銷策略,並在Facebook最新的動態消息演算法下,提高你的貼文的曝光率和參與度。然而,請記住,每個社群和受眾都是獨特的,因此你需要不斷嘗試和調整你的策略,以找出最適合你的方法。最重要的是,始終專注於提供有價值和有意義的內容,並與你的受眾建立真誠的連結。這不僅可以提高你的貼文的效果,也可以建立和深化你與你的受眾之間的關係,這是任何成功的社群行銷策略的核心。

預測未來的趨勢

以下是一些可能的趨勢和建議:

  1. 更多的個性化:隨著機器學習和人工智能的發展,Facebook的動態消息演算法可能會提供更多的個性化內容。這意味著,你需要更加了解你的受眾,並創建能夠滿足他們獨特需求和興趣的內容。
  2. 更嚴格的內容規定:考慮到近年來對假新聞和誤導性內容的關注,Facebook可能會對內容的質量和準確性有更嚴格的要求。這意味著,你需要確保你的貼文提供準確、實證支持的資訊,並避免使用誤導性或誇大的聲明。
  3. 更大的用戶參與:Facebook可能會繼續鼓勵用戶參與和互動,並將這些因素納入其演算法。這意味著,你需要創建能夠引發用戶互動的內容,並鼓勵他們與你的貼文互動。
  4. 更多的影片內容:影片內容在Facebook上的流行可能會繼續增長。這意味著,你可能需要增加你的影片內容,並確保它們是高質量和有價值的。

結語

在Facebook這個全球最大的社群平台上,了解並適應其動態消息演算法是實現有效社群行銷的關鍵。這需要創建引人入勝的內容,鼓勵用戶互動,選擇適當的發布時間,並避免問題性或低質量的內容。對於健康相關的內容,需要特別注意避免使用驚人或誇大的健康聲明,並確保提供準確和實證支持的健康資訊。

同時,社群行銷人員需要關注未來的趨勢,包括更多的個性化內容,更嚴格的內容規定,更大的用戶參與,以及視頻內容的增長。這些趨勢將影響Facebook的動態消息演算法,並需要社群行銷人員不斷學習、適應和創新。

最後,無論演算法如何變化,始終專注於提供有價值和有意義的內容,並與你的受眾建立真誠的連結,這將是任何成功的社群行銷策略的核心。希望這篇文章能夠幫助你優化你的社群行銷策略,並在Facebook上實現最佳的行銷效果。

如何防止AI聊天機器人抓取網站內容

Google Bard

圖片來源:unsplash

現今,AI聊天機器人無需獲得許可即可自由地抓取你的網站內容。這對於許多網站擁有者來說可能是一個令人擔憂的問題。然而,有一些方法可以防止AI工具訪問你的網站,但這些方法也有一些限制。

AI聊天機器人如何訪問你的網站內容?

AI聊天機器人通過使用多種數據集進行訓練,其中一些是開源的並且可以公開獲取。例如,GPT3就是使用五個數據集進行訓練的,這是根據OpenAI發表的一篇研究論文:

  • Common Crawl(訓練中佔60%的權重)
  • WebText2(訓練中佔22%的權重)
  • Books1(訓練中佔8%的權重)
  • Books2(訓練中佔8%的權重)
  • Wikipedia(訓練中佔3%的權重)

Common Crawl包含自2008年以來收集的來自網站的數據,其數據量以PB(數千TB)計算,這與Google的搜尋算法抓取網頁內容的方式相似。WebText2是OpenAI創建的數據集,包含來自Reddit貼文的約4500萬個網頁連結,這些貼文至少獲得了三個讚。

因此,對於ChatGPT這種AI機器人來說,它並不是直接訪問和抓取你的網頁——至少現在還不是。然而,OpenAI宣布將推出一款由ChatGPT主導的網頁瀏覽器,這引發了人們對這種情況可能即將改變的擔憂。

與此同時,網站擁有者應該密切關注其他AI聊天機器人,因為市場上的這種機器人越來越多。Bard是該領域的另一個重要名字,但我們對用於訓練它的數據集知之甚少。顯然,我們知道Google的搜尋機器人不斷地抓取網頁,但這並不一定意味著Bard可以訪問相同的數據。

為什麼有些網站擁有者會感到擔憂?

對於網站擁有者來說,他們最大的擔憂是像ChatGPT、Bard和Bing Chat這樣的AI機器人會貶低他們的內容價值。AI機器人使用現有的內容來生成他們的回應,但同時也減少了用戶訪問原始來源的需求。用戶不再需要訪問網站來獲取資訊,他們可以簡單地讓AI機器人生成他們需要的資訊摘要。

對於AI聊天機器人在搜尋中的應用,網站擁有者最大的擔憂是流量的損失。在Bard的情況下,這個AI機器人在其生成的回應中很少包含引用,告訴用戶它從哪些頁面獲取的資訊。所以,除了用AI回應取代網站訪問之外,Bard幾乎完全消除了源網站接收流量的可能性——即使用戶想要更多的資訊。另一方面,Bing Chat更常見的是連結到資訊來源。

換句話說,當前的生成型AI工具正在使用內容創作者的工作來系統性地取代內容創作者的需要。最終,我們必須問的是,這還留給網站擁有者繼續發布內容的動力嗎?並且,當網站停止發布AI機器人依賴的內容時,AI機器人會發生什麼?

如何阻止AI機器人訪問你的網站?

如果你不希望AI機器人使用你的網頁內容,你可以使用robots.txt文件來阻止它們訪問你的網站。不幸的是,你必須阻止每一個單獨的機器人並按名稱指定它們。

例如,Common Crawl的機器人被稱為CCBot,你可以通過在你的robots.txt文件中添加以下代碼來阻止它:

User-agent: CCBot
Disallow: /

這將阻止Common Crawl在未來抓取你的網站,但它不會刪除已經從之前的抓取中收集的任何數據。

如果你擔心ChatGPT的新插件訪問你的網頁內容,OpenAI已經發布了阻止其機器人的指南。在這種情況下,ChatGPT的機器人被稱為ChatGPT-User,你可以通過在你的robots.txt文件中添加以下代碼來阻止它:

User-agent: ChatGPT-User
Disallow: /

然而,阻止搜尋引擎AI機器人抓取你的內容是另一個完全不同的問題。由於Google對其使用的訓練數據保密,因此無法確定需要阻止哪些機器人,也無法確定它們是否會尊重你的robots.txt文件中的命令(許多爬蟲不會)。

這種方法有多有效?

在你的robots.txt文件中阻止AI機器人是目前可用的最有效方法,但並不特別可靠。

首先,你必須指定要阻止的每一個機器人,但誰能跟蹤市場上每一個AI機器人呢?下一個問題是,你的robots.txt文件中的命令是非強制性的指示。雖然Common Crawl、ChatGPT和許多其他機器人尊重這些命令,但許多機器人不會。

另一個大的限制是,你只能阻止AI機器人進行未來的抓取。你無法刪除之前抓取的數據,也無法向像OpenAI這樣的公司發送請求,要求刪除所有的數據。

你應該阻止AI工具訪問你的網站嗎?

不幸的是,沒有簡單的方法可以阻止所有AI機器人訪問你的網站,並且手動阻止每一個單獨的機器人幾乎是不可能的。即使你跟上了最新的AI機器人,也不能保證他們都會遵守你的robots.txt文件中的命令。

這裡的真正問題是,結果是否值得努力,簡單的答案是(幾乎肯定)不。

阻止AI機器人訪問你的網站也有可能的缺點。最重要的是,你將無法從搜尋引擎的流量中獲益,這可能對你的網站有重大影響。此外,你可能會阻止一些有益的機器人,如網站分析工具或搜尋引擎優化(SEO)工具。

然而,這並不意味著你應該完全無視AI機器人對你網站的影響。相反,你應該密切關注這個問題,並考慮你的選擇。例如,你可能想要阻止某些特定的機器人,或者你可能想要尋找其他方法來保護你的內容。

AI機器人是一個複雜的問題,並且沒有簡單的解決方案。但是,通過了解這些工具是如何工作的,以及你可以採取的步驟,你可以更好地保護你的網站和你的內容。

NVIDIA與WPP合作開發AI驅動的數位廣告內容引擎

Digital Marketing

Photo by fabio on Unsplash

在全球最大的廣告集團WPP與科技巨頭NVIDIA的合作下,一款突破性的內容引擎正在開發中。該引擎利用NVIDIA的Omniverse™和人工智慧技術,讓創意團隊能夠更快速、更有效率且更大規模地製作高品質的商業內容,同時完全符合客戶品牌的定位。

這款新引擎將連接一個由3D設計、製造和創意供應鏈工具組成的生態系統,包括Adobe和Getty Images的工具,讓WPP的藝術家和設計師能夠將3D內容創作與生成式AI整合。這使得他們的客戶能夠以高度個性化和吸引人的方式接觸消費者,同時保留其公司品牌身份、產品和標誌的品質、準確性和保真度。

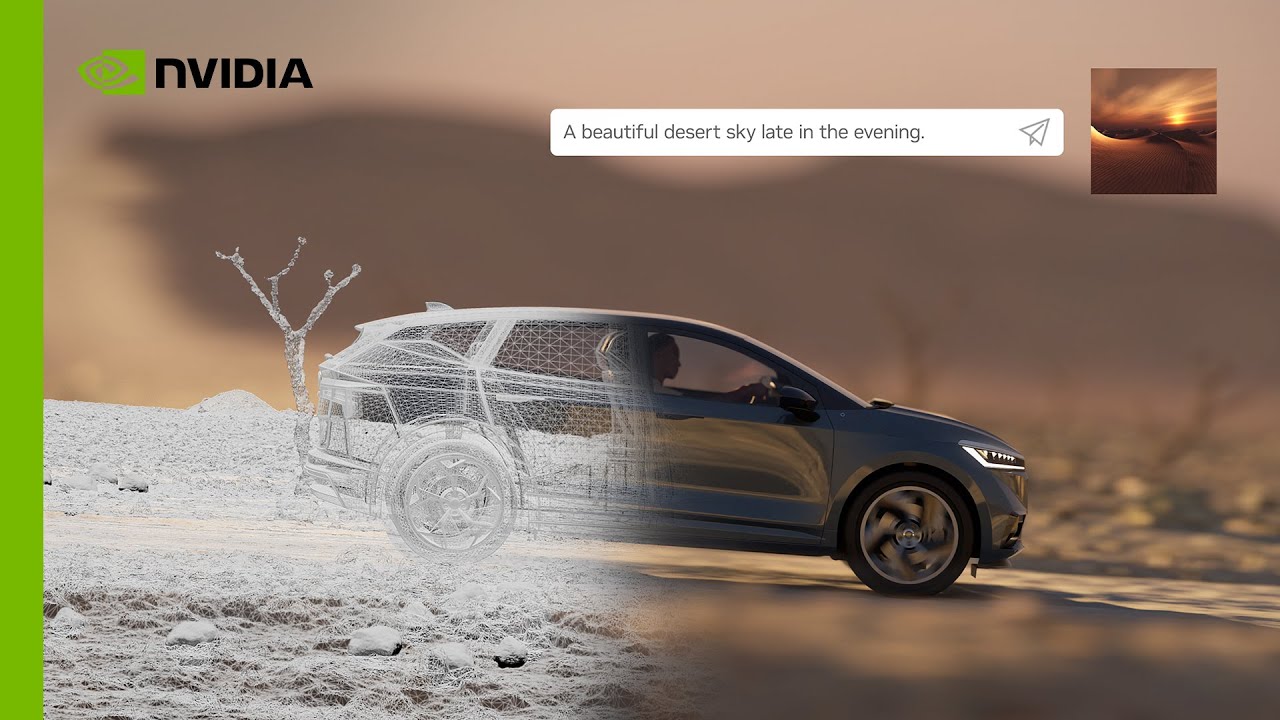
NVIDIA創始人兼CEO黃仁勳在其COMPUTEX主題演講中揭示了這款引擎,展示了客戶如何與WPP的團隊合作,製作大量的品牌廣告內容,如圖像或影片,以及像3D產品配置器這樣的體驗,使其更加定制化和沉浸式。

「全球的行業,包括7000億美元的數位廣告業,都在競相實現AI的好處。」 黃仁勳說,「通過Omniverse Cloud和生成式AI工具,WPP正在給品牌提供以前無法實現的真實性和規模的產品體驗和引人入勝的內容的創建和部署的能力。」

「生成式AI正在以驚人的速度改變行銷世界。」WPP的CEO Mark Read說,「我們與NVIDIA的合作讓WPP通過一種只有在當今市場上無處可尋的AI解決方案獲得了獨特的競爭優勢。這種新技術將改變品牌為商業用途創建內容的方式,並鞏固了WPP作為全球頂級品牌創意應用AI的行業領導者的地位。」這款新的內容引擎將基於Omniverse Cloud,這是一個連接3D工具,以及開發和部署高度個性化和引人入勝的視覺內容的平台。

在NVIDIA的CEO黃仁勳在COMPUTEX台北的演示中,他展示了WPP如何創建了一段真實的汽車在沙漠中行駛的影片。這種AI驅動的內容引擎意味著,同一輛汽車可以被放置在倫敦的街道上,或者在里約熱內盧的巴西市場中,而不需要昂貴的實地拍攝。

YouTube thumbnailYouTube icon
影片來源:NVIDIA

這種新的內容創建方式不僅可以快速地為不同的國家或城市調整廣告活動,還可以為不同的數位媒體,如Facebook或TikTok,以及他們的用戶進行定制。NVIDIA的開發者計劃副總裁Greg Estes對CNN表示:「你可以建立非常精細調整的活動來與觀眾產生共鳴……另一方面,你可以創造出在現實生活中從未存在的虛擬場景。」

這個平台是AI被大公司快速部署以提高生產力和向客戶提供新產品的最新例子。許多廣告和媒體行業的人擔心,由於AI能夠聚合資訊並創建與攝影無法區分的視覺內容,他們的工作可能會受到威脅。然而,WPP表示,他們的新平台「超越了目前的方法」,讓人們「使用來自斷開的工具和系統的不連貫數據手動創建數十萬件內容」。換句話說,新技術可能意味著更小的創意團隊最終能夠完成同樣的工作量。

WPP的CEO Mark Read在接受Financial Times採訪時表示:「我們已經將AI大量應用到我們的媒體業務中,但對我們的創意業務的應用非常少。識別AI將破壞的工作要比識別AI將創建的工作容易得多。」

這表明,儘管AI在許多領域中的應用已經變得越來越普遍,但在創意領域,特別是在廣告和媒體產業中,其潛力還有待挖掘。這也正是WPP與NVIDIA合作開發新的內容引擎的原因。

這款新的內容引擎將很快在全球範圍內獨家提供給WPP的客戶。