
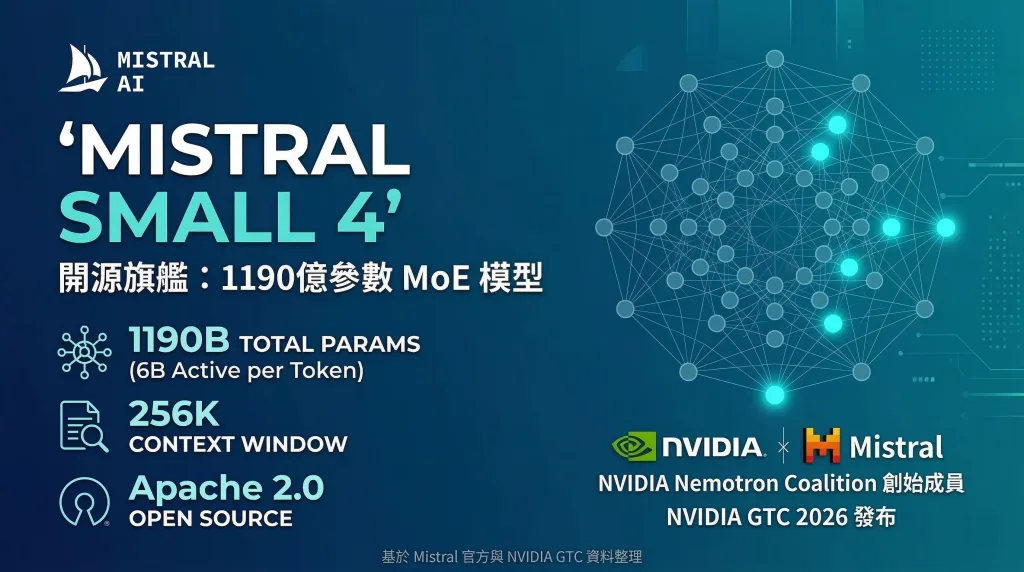
法國 AI 新創 Mistral 於 NVIDIA GTC 2026 發布全新旗艦開源模型,以 Apache 2.0 授權、256K 上下文窗口及可配置推理能力,直接向 OpenAI 與阿里雲 Qwen 宣戰
重點摘要
- Mistral Small 4 採用 MoE 架構,1190億總參數但每個 token 僅啟動 60億,實現高效能運算
- 推理速度較前代 Small 3 提升 40%,吞吐量暴增 3 倍
- 在 LiveCodeBench 程式編寫測試中擊敗 GPT-OSS 120B,輸出量卻減少 20%
- Mistral 成為 NVIDIA Nemotron Coalition 創始成員,聯手開發下一代基礎模型
- 完整支援企業部署:從 H100/H200 到 DGX B200,單機即可運行
為什麼這很重要:一個模型搞定所有任務
在企業 AI 採用的關鍵轉折點,Mistral 正在重新定義「開源模型」的商業價值。不同於過去需要 Magistral 做推理、Pixtral 處理圖像、Devstral 寫程式的複雜組合,Small 4 首次將三大核心能力整合於單一模型—這意味著企業不再需要為不同任務切換模型,大幅降低部署複雜度與營運成本。
對於正在評估 AI 策略的企業領導者而言,這不只是技術規格的競賽,而是關乎「供應商鎖定」與「數據主權」的戰略選擇。Apache 2.0 授權意味著企業可以完全掌控模型,無需擔心 API 調漲或服務中斷—這在當前地緣政治不確定性下,對金融、醫療、政府等敏感行業尤具吸引力。
核心規格與技術架構
| 規格項目 | Mistral Small 4 | 業界對比 |
|---|---|---|
| 總參數量 | 1190億 | GPT-OSS 120B 級距 |
| 每 Token 啟動參數 | 60億(含嵌入 80億) | 約 5% 運算效率 |
| 上下文窗口 | 256K tokens | 等同 Claude 3.5 Sonnet |
| 專家數量 | 128 位專家,每 Token 啟動 4 位 | MoE 架構標竿 |
| 授權條款 | Apache 2.0(可商用) | 完全開源 |
| 多模態支援 | 文字 + 圖像輸入 | 原生整合 |
可配置推理:一鍵切換「快思考」與「深思考」
Small 4 最具突破性的功能是其 單一參數 reasoning_effort,讓開發者無需更換模型即可調整推理深度:
"none"模式:快速直接回應,適合客服機器人、即時問答"high"模式:逐步鏈式思考(Chain-of-Thought),適合複雜分析、程式除錯、研究任務
這種靈活性讓同一個模型能夠同時服務「需要即時回應」與「需要深度分析」的場景,簡化企業的模型管理。
性能實測:用更少輸出達成更高準確率
Mistral 公布的基準測試數據顯示,Small 4 在多項關鍵指標上超越競爭對手:
程式編寫能力:LiveCodeBench
| 模型 | 性能表現 | 輸出字元數 |
|---|---|---|
| Mistral Small 4 | 領先 GPT-OSS 120B | 減少 20% |
| GPT-OSS 120B | 基準線 | 基準線 |
推理效率:AA LCR 測試
| 模型 | 準確率 | 輸出字元數 | 效率比 |
|---|---|---|---|
| Mistral Small 4 | 0.72 | 1,600 | 基準 |
| 阿里雲 Qwen | 相近 | 5,800 – 6,100 | 少 3.5-4 倍輸出 |
這組數據的商業意義重大:輸出字元數直接關聯到推理成本與延遲。Small 4 用不到對手四分之一的輸出量達到相同準確度,意味著在實際部署中可顯著降低運算開支—對於需要處理大量請求的企業應用,這可能轉化為數十萬美元的年度節省。
NVIDIA 戰略結盟: Nemotron Coalition 創始成員
Mistral 此次發布的另一個重磅消息是與 NVIDIA 的深度合作。作為 Nemotron Coalition 的創始成員,Mistral 將與以下產業領導者共同推動開放式 AI 生態:
- Black Forest Labs(FLUX 圖像生成模型開發商)
- Cursor(AI 程式編輯器獨角獸)
- LangChain(LLM 應用框架)
- Perplexity(AI 搜尋引擎)
- Reflection AI(AI 安全與對齊)
- Sarvam(印度本土 AI 公司)
- Thinking Machines Lab(前 OpenAI 首席科學家 Ilya Sutskever 創立)
首個合作項目:Nemotron 4 基礎模型
雙方將在 NVIDIA DGX Cloud 上共同開發 Nemotron 4 系列基礎模型,Mistral 負責模型訓練與架構設計,NVIDIA 提供世界級的運算基礎設施。
「開放的前沿模型是 AI 成為真正平台的關鍵。與 NVIDIA 合作,我們將在規模化訓練與推進前沿模型方面發揮主導作用。」
— Arthur Mensch,Mistral CEO
這段話揭示了 Mistral 的宏大願景:他們不只想做「歐洲的 OpenAI」,而是要建立一個不受單一公司控制的開放 AI 平台。NVIDIA 的背書—無論是技術資源還是市場影響力—都大幅提升了這一願景的可信度。
企業部署指南:從原型到生產
Mistral Small 4 提供完整的部署選項,滿足不同階段的企業需求:
快速原型開發(免費)
- Mistral API / AI Studio:官方託管服務
- Hugging Face:開源社群平台
- build.nvidia.com:NVIDIA 免費原型環境
生產環境部署
- NVIDIA NIM:企業級微服務容器
- vLLM / SGLang / llama.cpp / Transformers:開源推理框架全支援
硬體需求
| 部署規模 | 最低配置 | 推薦配置 |
|---|---|---|
| 小型部署 | 4x NVIDIA HGX H100 | 4x NVIDIA HGX H100 |
| 中型部署 | 2x NVIDIA HGX H200 | 4x NVIDIA HGX H200 |
| 大型部署 | 1x NVIDIA DGX B200 | 2x NVIDIA DGX B200 |
對於已投資 NVIDIA 基礎設施的企業,Small 4 提供了無縫的升級路徑。單台 DGX B200 即可運行完整模型,這在 1190億參數級別的模型中屬於相對親民的硬體門檻。
產業影響與競爭格局
對 OpenAI 的挑戰
Small 4 的發布時機精準—正值 OpenAI 發布 GPT-OSS 系列之際。Mistral 選擇在 NVIDIA GTC 這個全球 AI 開發者盛會上亮相,明顯是衝著企業市場而來。Apache 2.0 授權 vs. OpenAI 的「開放但有限制」策略,將成為企業選型時的關鍵考量。
對中國模型的壓力
阿里雲 Qwen 系列近年來在開源社群聲勢看漲,但 Small 4 在 AA LCR 測試中展現的「高效率推理」優勢—用不到四分之一的輸出達到相同效果—直接挑戰了 Qwen 的性價比定位。
對企業 IT 決策者的意義
- 降低供應商依賴:開源模型讓企業掌握主導權
- 數據隱私保障:可完全本地部署,敏感數據不出境
- 成本可預測:無 API 調價風險,硬體投資可攤提
- 客製化彈性:可針對特定領域進行微調
結語:開源 AI 的轉折點
Mistral Small 4 不只是一款性能強勁的新模型,它代表了開源 AI 運動的成熟—從「愛好者玩具」進化為「企業級基礎設施」。透過與 NVIDIA 的戰略結盟,Mistral 正在建立一個從晶片到應用的完整生態系統,挑戰封閉模型的商業模式。
對於企業領導者而言,現在是重新評估 AI 策略的時機。開源模型已經不再是「便宜但性能差」的選項—Small 4 證明,它們可以在效率、靈活性與成本之間取得最佳平衡。隨著 Nemotron Coalition 的成形,我們可能正見證 AI 產業權力結構的重大轉移。
關鍵數據速覽
- 📅 發布日期:2026年3月16日(NVIDIA GTC 2026)
- 🏗️ 架構:MoE(128專家,每Token 4專家啟動)
- 🔢 參數:1190億總量 / 60億啟動
- 📏 上下文:256K tokens
- 📜 授權:Apache 2.0(完全開源商用)
- 🖼️ 多模態:文字 + 圖像輸入
- ⚡ 速度提升:較 Small 3 快 40%
- 📈 吞吐量提升:較 Small 3 增 3 倍