YouTube 將強制揭露人工智能產生的內容

人工智能(AI)技術的快速發展,為內容創作領域帶來了革命性的變化。越來越多的創作者開始利用 AI 工具來輔助或全面生成影音內容。然而,這也引發了對於內容真實性和透明度的擔憂。為了應對這一挑戰,全球最大的影音平台YouTube 決定採取行動,推出新的政策來規範 AI 產生的內容。

YouTube 強制揭露 AI 產生內容的新規定

YouTube 宣布,從2024年3月18日開始,創作者在上傳含有 AI 合成或變造內容的影片時,必須主動進行揭露。這項新規定適用於所有可能被誤認為真實畫面的 AI 產生內容。創作者在上傳影片時,需要確認是否使用了「經過變造或合成」的內容。需要揭露的 AI 產生內容類型包括:將影片中的人臉替換成他人的臉孔;合成生成人物的聲音用於旁白;修改真實事件或地點的畫面,使其呈現與現實不符的樣貌;生成描繪虛構重大事件的逼真場景等。這些內容如果沒有適當的標示,可能會誤導觀眾,使其誤以為是真實發生的事物。不過,並非所有使用 AI 技術的內容都需要進行揭露。 YouTube 明確指出,對於明顯不真實或屬於動畫、特效範疇的內容,無需標示為 AI 產生。此外,一些輕微的後製調整,如色彩校正、光線濾鏡、背景模糊等,也不在揭露範圍內。至於使用 AI 進行美化增強或添加視覺濾鏡的情況,同樣不需要特別說明。值得注意的是,如果創作者單純使用 AI 工具來輔助製作流程,例如生成腳本、提供創意靈感、自動生成字幕等,這些應用也無需披露。 YouTube 的新政策主要針對那些可能造成混淆或誤導的 AI 合成內容,而非所有 AI 賦能的創作行為。

揭露標籤與執行方式

為了讓觀眾能夠清楚辨識 AI 合成或變造的內容, YouTube 將採用揭露標籤的方式進行提示。當創作者表明影片中包含此類內容時, YouTube 會在影片說明欄位或直接在播放器上添加相應的標籤。對於涉及敏感話題(如健康、選舉、財經等)的 AI 產生內容, YouTube 將採取更顯著的標示方式,確保觀眾能夠一目了然地察覺。這些領域的資訊往往與公眾利益息息相關,因此需要格外謹慎對待,避免可能的誤導或負面影響。 YouTube 表示,如果創作者未能按照規定進行 AI 內容揭露,平台方可能會主動添加相應的標籤,尤其是對於可能誤導觀眾的內容。對於屢次違規的創作者, YouTube 將採取更嚴厲的處置措施,包括移除相關內容,甚至暫停其參與 YouTube 合作夥伴計畫的資格。

政策推行的影響與意義

YouTube 推出強制 AI 內容揭露的新政策,旨在提高平台內容的透明度,幫助觀眾區分真實和合成的內容。隨著 AI 技術在內容創作領域的應用日益普及,各大平台都在積極採取措施,以減少可能出現的誤導和混淆。對於創作者而言,這項新政策意味著他們需要適應新的遊戲規則,在創作過程中負責任地使用 AI 工具,並主動向觀眾披露相關資訊。這可能會對一些創作者造成一定的挑戰,需要他們在創意表達和合規要求之間尋找平衡。但從長遠來看,提高透明度有助於建立創作者與觀眾之間的信任,營造更健康的內容生態。從平台的角度來看, YouTube 的做法體現了其對於 AI 技術發展的前瞻性思考和應對。作為全球最大的影音分享平台, YouTube 有責任引領行業標準,推動 AI 在內容創作領域的負責任應用。這不僅關乎平台自身的健康發展,也關乎整個創意產業的未來走向。

業界對 YouTube 新政策的反應

YouTube 推出強制 AI 內容揭露政策,引發了業界的廣泛討論和反響。對於創作者群體而言,這項新規定無疑帶來了一定的挑戰和調適壓力。一些創作者表示,雖然理解平台方的良苦用心,但過於嚴格的規範可能會限制創意表達的自由度,影響創作的多樣性。不過,也有不少創作者對此表示支持和理解。他們認為,主動揭露 AI 生成內容有助於維護創作生態的誠信,長遠來看對所有參與者都有益處。一些創作者已經開始探索如何在遵守新規則的同時,繼續利用 AI 技術來提升內容品質和生產效率。對於觀眾而言, AI 內容揭露標籤的出現可能需要一個適應和接受的過程。有觀眾表示,看到標籤時可能會下意識地對內容的真實性產生懷疑,影響觀看體驗。但也有觀眾認為,標籤的存在提醒了他們保持理性思考和判斷,不被表面的真實感所迷惑。 YouTube 的做法也引起了其他平台的關注和效仿。一些視頻和社群平台紛紛表態,計劃推出類似的 AI 內容管理政策,以應對日益複雜的內容生態。業界普遍認為,隨著 AI 技術的發展,建立透明、負責任的內容標準將成為各平台必須面對的課題。

AI 在內容創作領域的未來展望

未來 AI 技術勢必將對內容創作領域產生深遠而廣泛的影響。隨著算法和模型的不斷進化, AI 生成的內容在質量和真實感方面將不斷提升,為創作者提供更多助力和可能性。與此同時, AI 的應用也將對傳統的創作模式和產業格局帶來衝擊和重塑。但 AI 的發展也伴隨著諸多挑戰和風險。除了內容真實性和透明度問題外,還涉及隱私保護、知識產權、倫理道德等多個層面。平台方和監管機構需要在鼓勵創新和維護公共利益之間尋找平衡,建立起適應 AI 時代的治理框架和行業規範。對於創作者和觀眾而言,重要的是需要提高對 AI 的認知和理解。創作者需要學習如何合理、合規地使用 AI 工具,發揮其優勢而避免濫用。觀眾則需要培養媒體識讀能力,辨別真偽,獨立思考。一方面, AI 可以成為創作者的得力助手,提供靈感、素材和技術支持;另一方面,創作者也需要學會如何駕馭 AI ,而非完全依賴。人機協作、共創的新模式值得期待和探索。

如何充分發揮 Claude 潛力的 Prompt 技巧

隨著自然語言處理( NLP )技術的快速發展,大型語言模型如 GPT-4 Turbo 和 Claude 3 等已經能夠生成接近人類水平的文本。然而,為了充分發揮這些模型的潛力,我們還需要掌握一項重要的技能—— Prompt Engineering 。簡單來說,Prompt Engineering 就是設計最佳的輸入( Prompt ),以引導語言模型生成我們想要的輸出。一個設計良好的 Prompt 可以顯著提升模型的表現,而糟糕的 Prompt 則可能導致模型生成無關、偏頗或有害的內容。因此,學習如何為 Claude 設計優質的 Prompt,是有效運用這個強大工具不可或缺的一步。

清楚描述任務

為了獲得理想的輸出,我們首先需要清楚且具體地描述我們希望 Claude 執行的任務。Claude 偏好直接、明確且詳盡的指示,這有助於它正確理解我們的需求並給出相應的回應。舉例來說,假設我們想要 Claude 幫忙從一段文本中移除個人識別資訊( Personally Identifiable Information,簡稱 PII ),我們就需要在 Prompt 中明確定義什麼是 PII。

一個清晰的 PII 定義可能是:「 PII 包括但不限於姓名、電話號碼、電子郵件地址、身份證號碼、信用卡號碼、銀行帳戶資訊等任何可以直接或間接識別個人身份的資訊。」有了這個定義,我們就可以給 Claude 一個明確的任務指示,例如:「請從下面的文本中移除所有的個人識別資訊(PII),並用 ‘[REDACTED]’ 替換被移除的內容。」

以下是一個示範如何提供清晰任務描述的 Prompt:

<prompt>

請從下面的文本中移除所有的個人識別資訊(PII),並用 '[REDACTED]' 替換被移除的內容。

PII 的定義:

PII 包括但不限於姓名、電話號碼、電子郵件地址、身份證號碼、信用卡號碼、銀行帳戶資訊等任何可以直接或間接識別個人身份的資訊。

原始文本:

John Doe 是一位 35 歲的軟體工程師,他的電子郵件是 [email protected],電話號碼是 (123) 456-7890。John 的身份證號碼是 A123456789,他有一張 Visa 信用卡,卡號為 4111 1111 1111 1111。John 在 XYZ 銀行開了一個帳戶,帳號是 9876543210。

</prompt>

在這個 Prompt 中,我們首先給出了一個明確的任務指示,接著提供了 PII 的詳細定義,最後是一段包含各種 PII 的原始文本。這樣的 Prompt 結構清晰、資訊完整,能夠幫助 Claude 準確理解我們的需求並生成符合預期的輸出。

使用 XML 標籤區隔不同元素

在設計 Prompt 時,我們可以使用 XML 標籤來區隔不同的元素,如指示、輸入文本、輸出範例等。XML 標籤的格式是 <tag>內容</tag>,其中 “tag” 可以是任何有意義的標識符,如 <instruction>、<input>、<output> 等。Claude 經過了特殊的訓練,能夠識別並處理 XML 標籤中的內容。

讓我們以之前的 PII 移除任務為例,看看如何在 Prompt 中運用 XML 標籤:

<prompt>

<instruction>

請從下面的文本中移除所有的個人識別資訊(PII),並用 '[REDACTED]' 替換被移除的內容。

</instruction>

<definition>

PII 包括但不限於姓名、電話號碼、電子郵件地址、身份證號碼、信用卡號碼、銀行帳戶資訊等任何可以直接或間接識別個人身份的資訊。

</definition>

<input>

John Doe 是一位 35 歲的軟體工程師,他的電子郵件是 [email protected],電話號碼是 (123) 456-7890。John 的身份證號碼是 A123456789,他有一張 Visa 信用卡,卡號為 4111 1111 1111 1111。John 在 XYZ 銀行開了一個帳戶,帳號是 9876543210。

</input>

</prompt>

在這個例子中,我們使用 <instruction>、<definition> 和 <input> 三個標籤分別標記任務指示、PII 定義和輸入文本。這種結構化的 Prompt 可以幫助 Claude 更好地理解任務的各個部分,從而生成更加準確和連貫的輸出。

使用 XML 標籤的另一個好處是,我們可以在 Prompt 中提供輸出範例,並用 <output> 標籤標記。這可以幫助 Claude 學習我們期望的輸出格式和風格。以下是一個包含輸出範例的 PII 移除任務 Prompt:

<prompt>

<instruction>

請從下面的文本中移除所有的個人識別資訊(PII),並用 '[REDACTED]' 替換被移除的內容。

</instruction>

<definition>

PII 包括但不限於姓名、電話號碼、電子郵件地址、身份證號碼、信用卡號碼、銀行帳戶資訊等任何可以直接或間接識別個人身份的資訊。

</definition>

<input>

John Doe 是一位 35 歲的軟體工程師,他的電子郵件是 [email protected],電話號碼是 (123) 456-7890。John 的身份證號碼是 A123456789,他有一張 Visa 信用卡,卡號為 4111 1111 1111 1111。John 在 XYZ 銀行開了一個帳戶,帳號是 9876543210。

</input>

<output>

[REDACTED] 是一位 35 歲的軟體工程師,他的電子郵件是 [REDACTED],電話號碼是 [REDACTED]。[REDACTED] 的身份證號碼是 [REDACTED],他有一張 [REDACTED] 信用卡,卡號為 [REDACTED]。[REDACTED] 在 [REDACTED] 銀行開了一個帳戶,帳號是 [REDACTED]。

</output>

</prompt>

透過提供輸出範例,我們可以明確告訴 Claude 應該如何處理輸入文本中的 PII,以及最終輸出的格式。這種方法可以顯著提高 Claude 生成符合預期輸出的機率,減少反覆修正 Prompt 的需要。

總之,使用 XML 標籤可以幫助我們創建結構清晰、資訊完整的 Prompt,更好地引導 Claude 理解任務並生成高品質的輸出。在設計 Prompt 時,我們可以根據任務的需要,靈活運用不同的標籤和組合方式,以充分發揮 Claude 的潛力。

提供大量範例

在設計 Prompt 時,提供足夠多的高品質範例可以顯著提升 Claude 的學習成效。範例越多,Claude 就能更全面地理解任務的要求和預期輸出的格式。此外,多樣化的範例還可以幫助 Claude 學習處理不同情境下的輸入,提高其泛化能力。

讓我們繼續以 PII 移除任務為例,看看如何在 Prompt 中提供大量範例:

<prompt>

<instruction>

請從下面的文本中移除所有的個人識別資訊(PII),並用 '[REDACTED]' 替換被移除的內容。

</instruction>

<definition>

PII 包括但不限於姓名、電話號碼、電子郵件地址、身份證號碼、信用卡號碼、銀行帳戶資訊等任何可以直接或間接識別個人身份的資訊。

</definition>

<examples>

<example>

<input>

John Doe 是一位 35 歲的軟體工程師,他的電子郵件是 [email protected],電話號碼是 (123) 456-7890。

</input>

<output>

[REDACTED] 是一位 35 歲的軟體工程師,他的電子郵件是 [REDACTED],電話號碼是 [REDACTED]。

</output>

</example>

<example>

<input>

Jane Smith 是一名 28 歲的護士,她的身份證號碼是 B987654321,住在台北市信義區松仁路 100 號。

</input>

<output>

[REDACTED] 是一名 28 歲的護士,她的身份證號碼是 [REDACTED],住在台北市信義區 [REDACTED]。

</output>

</example>

<example>

<input>

Bob Johnson 的信用卡號碼是 5555 6666 7777 8888,CVV 是 123,有效期至 2025 年 12 月。他的 PayPal 帳號是 [email protected]。

</input>

<output>

[REDACTED] 的信用卡號碼是 [REDACTED],CVV 是 [REDACTED],有效期至 [REDACTED]。他的 PayPal 帳號是 [REDACTED]。

</output>

</example>

</examples>

<input>

Michael Brown 是一名 42 歲的銷售經理,他的辦公室電話是 (987) 654-3210,手機號碼是 0912-345-678。Michael 的身份證字號是 A123456789,他有一張美國運通卡,卡號為 3782 822463 10005。

</input>

</prompt>

在這個 Prompt 中,我們使用 <examples> 標籤提供了三組輸入和輸出範例,每組範例都包含不同類型的 PII,如姓名、電子郵件、電話號碼、地址、身份證號碼、信用卡資訊等。這些範例涵蓋了各種常見的 PII 形式,可以幫助 Claude 學習全面識別和處理 PII。

除了數量,範例的品質也非常重要。一個好的範例應該具備以下特質:

  1. 相關性:範例應該與任務密切相關,體現任務的核心要求。
  2. 多樣性:範例應該涵蓋各種可能的情境和變化,幫助 Claude 學習泛化。
  3. 清晰性:範例中的輸入和輸出應該格式清晰、易於理解,避免歧義。
  4. 一致性:所有範例應該遵循一致的格式和風格,體現同樣的任務要求。

透過提供大量高品質的範例,我們可以幫助 Claude 更快、更準確地學習任務,並生成符合預期的輸出。在實踐中,我們可以根據任務的複雜度和重要性,調整提供範例的數量和種類,以達到最佳的學習效果。

善用長文本脈絡

Claude 是一個強大的語言模型,它能夠處理長達 10,000 個 tokens 的文本,大約是 6000-7000 個英文單詞或 3000-5000 個中文字符,但具體的 token上限可能會隨著模型的更新而有所變化。這意味著我們可以在 Prompt 中提供大量的背景資訊和上下文,幫助 Claude 更全面地理解任務和輸入。這個長度已經足以應付大部分的寫作和對話任務。不過對於特別長的文章、書籍等,可能仍需要切分成多個部分來處理。

讓我們考慮一個需要對長文本進行摘要的任務。與其直接把長文本餵給 Claude,不如先在 Prompt 中提供一些背景資訊,說明文本的主題、目的和目標受眾,以幫助 Claude 更好地理解文本的重點和生成合適的摘要。以下是一個利用長文本脈絡的摘要任務 Prompt:

<prompt>

<background>

以下是一篇關於全球暖化對珊瑚礁影響的科普文章。這篇文章旨在向大眾介紹全球暖化如何導致珊瑚白化和死亡,以及這對海洋生態系統和人類社會的影響。文章的目標受眾是對環境問題感興趣,但沒有太多科學背景的普通讀者。

</background>

<instruction>

請為以下文章生成一個 100 字左右的中文摘要,突出全球暖化對珊瑚礁的影響,以及這種影響對海洋生態系統和人類社會的潛在後果。摘要應該以通俗易懂的語言寫成,避免使用過於專業的術語。

</instruction>

<article>

珊瑚礁是地球上最多樣化的生態系統之一,為海洋中 25% 的物種提供了棲息地。然而,由於氣候變遷導致海水溫度上升,全球的珊瑚礁正面臨著前所未有的威脅。

當海水溫度升高時,珊瑚會驅逐體內共生的藻類,導致珊瑚白化。如果高溫持續太久,珊瑚就會因缺乏藻類提供的營養而死亡。過去 30 年裏,全球已經損失了 50% 的珊瑚礁,預計到 2050 年,即使在樂觀的低排放情境下,也將有 90% 的珊瑚礁面臨風險。

珊瑚礁的消失不僅會導致海洋生物多樣性的喪失,也會對依賴珊瑚礁的沿海社區造成嚴重影響。珊瑚礁每年為全球經濟貢獻超過 3000 億美元,提供食物、旅遊收入和沿海保護等服務。如果不採取行動遏制全球暖化,我們將失去這些寶貴的生態系統及其提供的諸多惠益。

為了保護珊瑚礁,我們必須採取緊急措施減少溫室氣體排放,將全球變暖控制在 1.5°C 以內。同時,我們也需要加強對已受損珊瑚礁的保護和修復工作,提高其應對氣候變遷的復原力。只有通過全球協調行動,我們才能為後代保留這些海洋瑰寶。

</article>

</prompt>

在這個 Prompt 中,我們首先提供了一段背景資訊,說明文章的主題、目的和目標受眾,為 Claude 理解文章內容提供了重要的脈絡。接著,我們給出明確的摘要指示,說明摘要的重點、長度要求和語言風格。最後,我們把完整的文章內容提供給 Claude,讓它在充分理解上下文的基礎上生成摘要。

這種方式利用了 Claude 處理長文本的能力,通過在 Prompt 中提供詳盡的背景脈絡,幫助 Claude 更準確地把握文章的核心內容,生成切題、清晰、易懂的摘要。在實踐中,我們可以根據任務的需要,靈活調整 Prompt 中背景脈絡的詳細程度和長度,以幫助 Claude 充分理解輸入並生成高品質的輸出。

給予 Claude 思考的時間

研究表明,給予語言模型一些 “思考” 的時間,讓它在輸出最終答案之前先分析問題並擬定解決方案,可以顯著提高輸出的品質。在 Claude 中,我們可以使用思考標籤 <think> 和 </think> 來實現這一點。

以下是一個使用思考標籤的問題回答 Prompt:

<prompt>

<question>

如何在人工智慧研究中處理偏見和公平問題?請從技術和倫理兩個角度討論。

</question>

<think>
讓我先從技術角度分析:

1. 資料偏見:訓練資料中的偏見可能導致模型產生不公平的輸出,需要仔細審查和處理資料集。

2. 演算法偏見:某些機器學習演算法可能放大資料中的偏見,需要採用更加公平的演算法設計。

3. 模型評估:需要使用公平性指標來評估模型的表現,如不同群體的準確率和錯誤率是否一致。

4. 可解釋性:可解釋的AI有助於識別模型中的偏見,並進行針對性的改進。

從倫理角度來看:

1. 價值觀:AI系統應體現人類的價值觀,如平等、非歧視和包容性。

2. 透明度:AI系統的開發和使用應透明公開,接受公眾監督。

3. 問責制:應明確AI系統的責任歸屬,確保出現問題時能夠追究責任。

4. 人權:AI系統不應侵犯個人隱私、自由和尊嚴等基本人權。

5. 社會影響:需要評估AI系統對不同群體和社會整體的影響,確保其公平性和正當性。

綜合來看,處理AI偏見和公平問題需要在技術和倫理兩個層面共同發力。在技術層面,我們需要優化資料處理、演算法設計、模型評估和可解釋性,最大限度地消除偏見;在倫理層面,我們要恪守人類的核心價值觀,提高AI系統的透明度和問責性,並充分評估其對社會的影響。只有技術和倫理協同發展,才能真正實現公平、負責、可信的AI。

</think>

<answer>

人工智慧研究中的偏見和公平問題需要從技術和倫理兩個角度綜合應對。

在技術層面,我們需要:

1. 仔細審查訓練資料,識別和消除其中的偏見;

2. 採用更加公平的機器學習演算法,避免放大資料中的偏見;

3. 使用公平性指標來評估模型的表現,確保其對不同群體一視同仁;

4. 提高AI系統的可解釋性,便於發現和糾正模型中的偏見。

在倫理層面,我們應該:

1. 將平等、非歧視、包容等人類核心價值觀融入AI系統的設計和應用中;

2. 提高AI系統開發和使用的透明度,接受來自公眾和專家的監督;

3. 明確AI系統的責任歸屬,確保問題發生時能夠追究相關方的責任;

4. 尊重並保護個人隱私、自由、尊嚴等基本人權,杜絕AI系統對其的侵犯;

5. 全面評估AI系統對不同群體和社會整體的影響,確保其公平性和正當性。

只有在技術和倫理兩個層面协同发力,我們才能真正實現公平、負責、可信的AI。這需要來自學界、業界、政府和公眾的共同努力,以建設一個更加包容、平等、繁榮的智慧社會。

</answer>

</prompt>

在這個 Prompt 中,我們首先給出了一個複雜的問題,涉及 AI 偏見和公平的技術和倫理層面。接著,我們使用 <think> 標籤讓 Claude 先分析問題,提出解決方案。在 <think> 標籤內,Claude 分別從技術和倫理兩個角度列出了一系列關鍵点,為最終的答案提供了扎實的思考基礎。

最後,在 <answer> 標籤內,Claude 總結了之前的思考,提煉出技術和倫理兩個層面需要採取的關鍵舉措,並強調了兩者協同發展的重要性。同時,Claude 還呼籲學界、業界、政府和公眾共同努力,以期建設一個更加公平和包容的智慧社會。

可以看到,使用思考標籤讓 Claude 有機會在輸出最終答案前 “思考” 問題,有助於其生成更加全面、深入、有邏輯的回答。這種方法特別適用於那些需要多角度分析、論證的開放性問題。我們可以根據問題的復雜程度,調整思考標籤中的內容和長度,以幫助 Claude 充分理解問題,並輸出高品質的答案。

結語

Prompt engineering 是與 Claude 等大型語言模型進行有效互動的關鍵。通過設計優質的 Prompt,我們可以顯著提升 Claude 的表現,充分發揮其在自然語言處理任務中的潛力。

本文介紹了五種提高 Prompt 品質的方法:

  1. 清楚描述任務,提供明確、具體的指示
  2. 使用 XML 標籤區隔 Prompt 的不同部分,創建結構化的輸入
  3. 提供大量高品質、多樣化的範例,幫助 Claude 學習任務
  4. 善用 Claude 處理長文本的能力,在 Prompt 中提供豐富的背景脈絡
  5. 使用思考標籤給予 Claude “思考” 的時間,讓其輸出更加深入、全面的答案

這些方法可以靈活組合,適用於各種不同類型的任務,如文本分類、摘要、問答、創意寫作等。隨著 Claude 等語言模型的不斷發展,Prompt engineering 也在不斷演進。我們需要持續學習和創新,探索更多設計 Prompt 的技巧和最佳實踐。

除了本文介紹的方法,還可以參考 Anthropic 的官方文件和社區資源,學習更多與 Claude 互動的技巧。希望以上的分享能夠對讀者熟練運用 Claude Prompt 有所幫助。

深入解析網路爬蟲:機器人如何探索並塑造網際網路

網路爬蟲,又稱為網路蜘蛛或網頁機器人,是一種自動瀏覽世界網路的網際網路機器人。它們被廣泛用於搜尋引擎或其他網站,用於索引網頁內容。但實際上,網路爬蟲的用途遠遠不止於此。

網路爬蟲的運作原理

網路爬蟲首先從一組初始的網頁開始,讀取這些網頁的內容,然後尋找指向其他網頁的連結,進而訪問這些連結,重複這一過程。這種方式讓爬蟲能夠自動在網際網路上移動,收集資訊。

爬蟲的技術背景

網路爬蟲的技術實現涉及到複雜的編程技術,包括但不限於網路爬取、內容解析和數據存儲等方面。一個高效的網路爬蟲不僅要能夠處理大量的網頁,還要能夠應對網站結構的變化,以及避免被網站的防爬機制所阻擋。

爬蟲與搜尋引擎

搜尋引擎使用網路爬蟲來發現和索引網頁內容。通過不斷的爬取,搜尋引擎能夠發現新的或更新的網頁,並將這些資訊納入其索引庫中,以提供給用戶搜尋。

爬蟲的其他應用

除了搜尋引擎,網路爬蟲還被廣泛用於各種數據收集任務,如市場分析、網站監控、內容聚合等。它們能夠從網路上自動收集特定類型的資訊,供人們進一步分析和利用。

網路爬蟲的挑戰與策略

網路爬蟲在爬取過程中會遇到諸多挑戰,包括網站結構的變化、防爬蟲機制、以及如何高效地處理和存儲大量數據等。

尊重 Robots.txt

Robots.txt是一種網站管理工具,它允許網站告訴爬蟲哪些部分可以被爬取,哪些部分不可以。一個負責任的爬蟲應該遵守這些規則,以避免對網站的正常運作造成干擾。

爬蟲預算的管理

爬蟲預算指的是搜尋引擎分配給特定網站的爬取資源。網站可以通過優化其結構和內容,提高爬蟲的效率,從而獲得更多的爬蟲資源。

Google 搜尋與網路爬蟲

  1. Google 的網路爬蟲 GoogleBot 的工作包括:獲取器( Fetcher )獲取網頁內容、控制器( Controller )整合連結來源、調度器( Scheduler )協調何時獲取什麼內容。
  2. 爬蟲獲取量取決於搜尋需求和網站內容品質。內容品質越高, GoogleBot 就會越頻繁抓取;反之品質差則減少抓取。
  3. 提高網站被 Google GoogleBot 發現的途徑包括:增加高品質內容、自然獲取更多外部連結、內部連結推送新內容等。
  4. 除了連結和 Sitemap 等常規方式, Google 還提供索引 API 用於快速索引特定類型內容,但不推薦濫用。

結語

網路爬蟲是網際網路生態系統中不可或缺的一部分。它們的存在使得搜尋引擎能夠發現和索引網際網路上的內容,並為人們提供搜索服務。同時,網路爬蟲也在其他領域發揮著重要作用,如數據分析和市場研究等。然而,高效且負責任地運用爬蟲技術,既是技術上的挑戰,也是道德上的考驗。

a16z 發布全球前100大生成式 AI 應用報告,ChatGPT 穩居榜首,移動應用崛起

知名矽谷創投公司 Andreessen Horowitz (a16z) 2024年3月13日發布了一份報告,選出了全球前100大生成式 AI 應用。這份報告基於網站和移動應用的流量數據,反映了生成式 AI 正在快速走向大眾,應用場景不斷拓展。

圖片來源:a16z

報告顯示, OpenAI 開發的對話式 AI 應用 ChatGPT 穩居榜首,月活躍用戶高達2億,佔前50大應用總流量的60%。 ChatGPT 自2022年11月推出以來,迅速成為增長最快的消費級應用,展現了生成式 AI 驚人的發展速度和廣泛的應用前景。

值得注意的是,80%的上榜應用都是在過去一年內新推出的,顯示生成式 AI 正處於高速發展期。報告還指出,移動端應用開始崛起,在榜單中佔據近1/3的席位。這些移動應用的開發者遍布全球,其中土耳其的表現尤為亮眼,有多款熱門應用出自該國的工作室,如 AI 換臉應用 Face Dance 和 AI 藝術生成器 Wonder 等。

從應用類型來看,圖像生成、對話、寫作是目前最受歡迎的場景。頭像生成、 AI 鍵盤等針對移動端的獨特應用也備受青睞。不過報告提醒,網頁應用仍是主流,移動端的用戶體驗還有待進一步提升。

在商業模式方面,榜單中的大多數應用已經開始盈利,主要採用訂閱制,平均月費為21美元。這表明消費者願意為優質的生成式 AI 服務付費,市場前景廣闊。不過,科技巨頭也在加速布局,通過收購等方式搶佔先機,給初創公司帶來不小的競爭壓力。

a16z 合夥人 James Currier 表示,這份報告揭示了生成式 AI 正在加速滲透消費市場,不容小覷。 ChatGPT 等明星產品的出現,可能預示著又一個顛覆性技術浪潮的到來。不過他也提醒,技術創新和商業模式仍在探索中,未來發展尚存在不確定性。監管政策、倫理規範等配套亟待完善,需要產業界和社會各界共同努力。

業界普遍認為, a16z 的這份報告是把脈生成式 AI 發展的重要風向標。一方面,它為創業者和投資人提供了宏觀的市場洞見;另一方面,也引發了對生成式 AI 社會影響的更多思考和討論。隨著技術的不斷演進,如何讓 AI 造福大眾,推動經濟增長,仍是擺在眾人面前的一道難題。

Midjourney 推出新的「角色參考」測試功能

2024年3月12日,Midjourney 推出新功能“ Character Reference ”(角色參考)的測試,代表著在人工智能圖像生成領域的一大步。這項創新功能類似於既有的“ Style Reference ”(風格參考),但不同之處在於它專注於根據“角色參考”圖像來匹配角色,而非僅僅匹配參考風格。此功能允許用戶透過在提示命令後加上--cref URL並附上角色圖像的 URL 來使用角色參考,從而使生成的角色能更貼近用戶所提供的參考圖像。用戶還可以透過 --cw 命令來調整參考強度,範圍從100到0不等,以此來控制生成圖像的細節程度,從臉部、頭髮到服裝等各方面的匹配度。

此功能主要設計用於使用 Midjourney 生成的角色圖像,並非針對真實人物或照片。它在處理真人圖像時可能會產生扭曲,這與普通圖像提示的處理方式相似。這意味著,雖然 cref 功能與常規圖像提示在操作上相似,但它更專注於角色特徵,而非逐一複製如雀斑、痣或T恤上的標誌等細節。

進階功能方面, Midjourney 支援使用多個 URL 來融合來自多個圖像的資訊或角色,這類似於使用多個圖像或風格提示。在 Web Alpha 版本上,用戶可以拖動或粘貼圖像至想像欄,並通過選擇三個圖標之一來設定圖像是作為圖像提示、風格參考還是角色參考使用。若要將圖像用於多個類別,則可按住 Shift 鍵選擇適用的選項​​​​。

值得注意的是,儘管此功能目前處於 alpha 測試階段,且隨著 Midjourney V6 正式進入 beta 階段,功能可能會有所變化,但 Midjourney 團隊鼓勵用戶分享他們對於此新功能的想法及反饋。這顯示了 Midjourney 對於社群反饋的重視,並期待此功能能夠幫助用戶更加自由地構建故事和世界​​。

Midjourney 的 “ Character Reference ” 功能為 AI 圖像生成領域帶來了新的可能性,尤其是在創建一致性角色和故事講述方面。隨著技術的不斷發展和完善,期待看到更多創新功能的推出,以及它們將如何幫助創作者擴展他們的創意邊界。

官方使用說明

1.在提示後鍵入--cref URL,其中包含指向字元影像的 URL

2.可以使用 --cw 將引用“ strength ”從100修改為0

3.strength 100(--cw 100)是預設值,使用面部、頭髮和衣服

4.强度為0(--cw 0)時,它只會專注於面部(適合換裝/換發等)

5.可以使用多個 URL 來混合多個影像中的資訊/字元,如 --cref URL1 URL2(這類似於多個影像或樣式提示)

實際測試

讓我們先用上一篇文章 Midjourney 最新更新:引入「一致風格」功能,增強藝術生成體驗 的女主角作為例子:

我們使用以下的 Prompt 進行測試

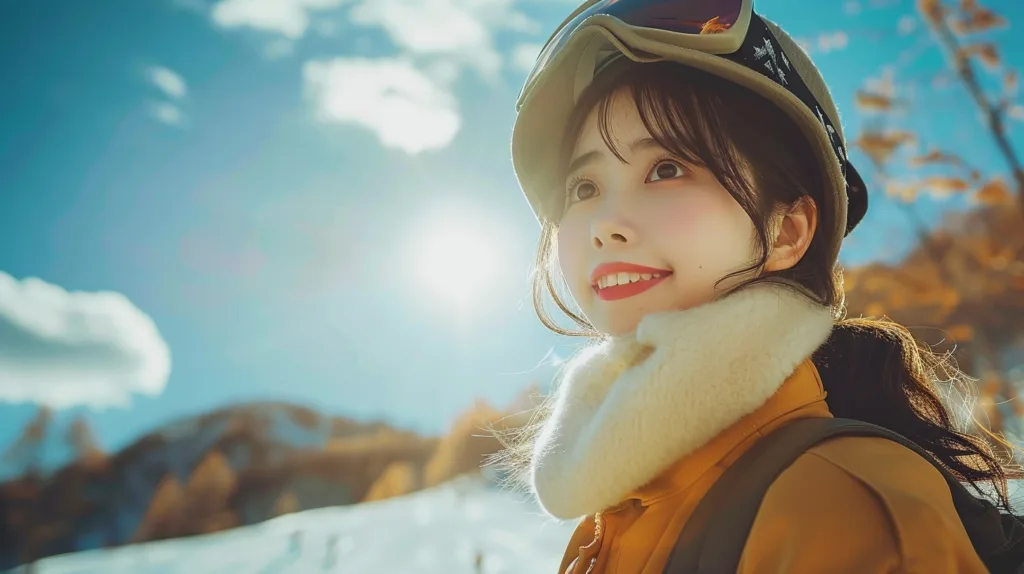
Prompt: 冬季的日本八幡平,一個35歲清新脫俗的日本岩手縣美麗女導遊,她身穿滑雪服裝,在滑雪坡道上拍照。燦爛的陽光從她的背後照射。特寫鏡頭。

In Hachimantai, Japan in winter, a 35-year-old fresh and refined beautiful female tour guide from Iwate Prefecture, Japan, is taking pictures on the ski slopes. The bright sun shines from behind her. Close-up. --ar 16:9 --cref https://s.mj.run/NueRyP4V_No --v 6.0 

參考圖像

預設值 cw=100

由產生的圖像觀察,雖然官方表示處理真人圖像時可能會產生扭曲,但是實際上使用並沒有出現這樣的情形,人物的臉蛋及輪廓、服裝、背景接高度近似原圖。

讓我們繼續調整 cw 看看不同的變化效果:

CW = 70

服裝開始改變,開始露出部份的雪景。

CW = 50

雪景的比例明顯增加,身上穿的衣服也開始調整成雪地的穿著。

CW = 30

太陽的光線更加強烈,已經很明顯地是雪地的背景。

CW = 0

背景及身上的穿著已經完全符合 Prompt ,只保留原女主角的臉部。

融合二張照片

我們用另外一個簡單的 Prompt 融合兩張風格跟 Midjourney 明顯不同,由 Leonardo 所創造出來的圖像測試其融合效果。因為跳脫了 Midjourney 創作的風格框架,這樣會比較符合讀者在現實工作使用時的狀況:

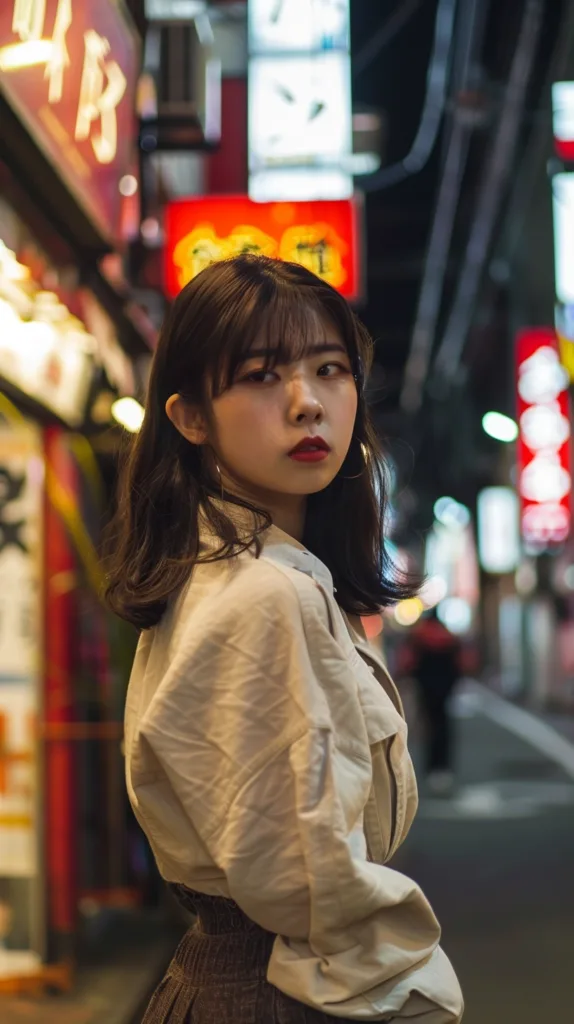
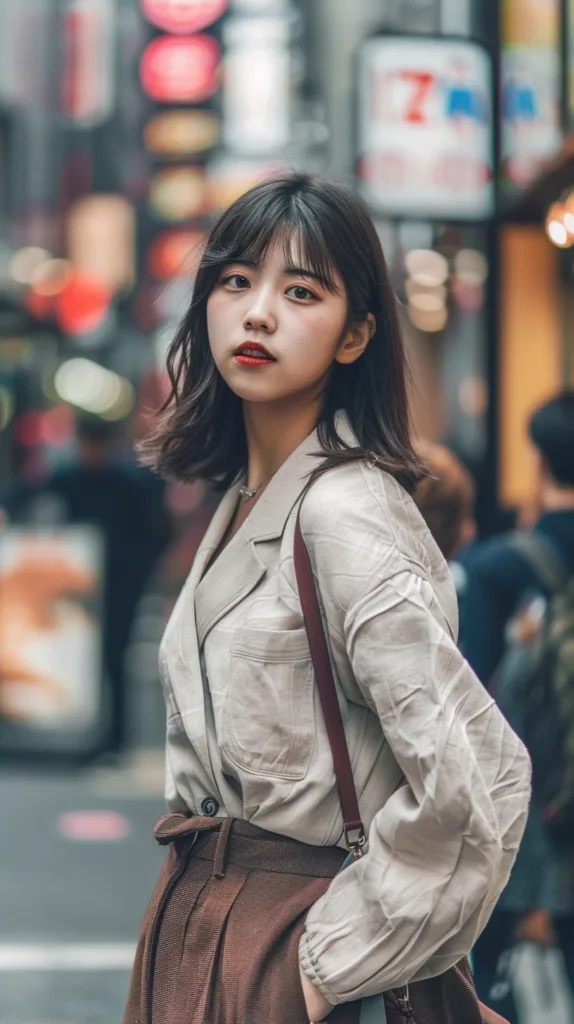
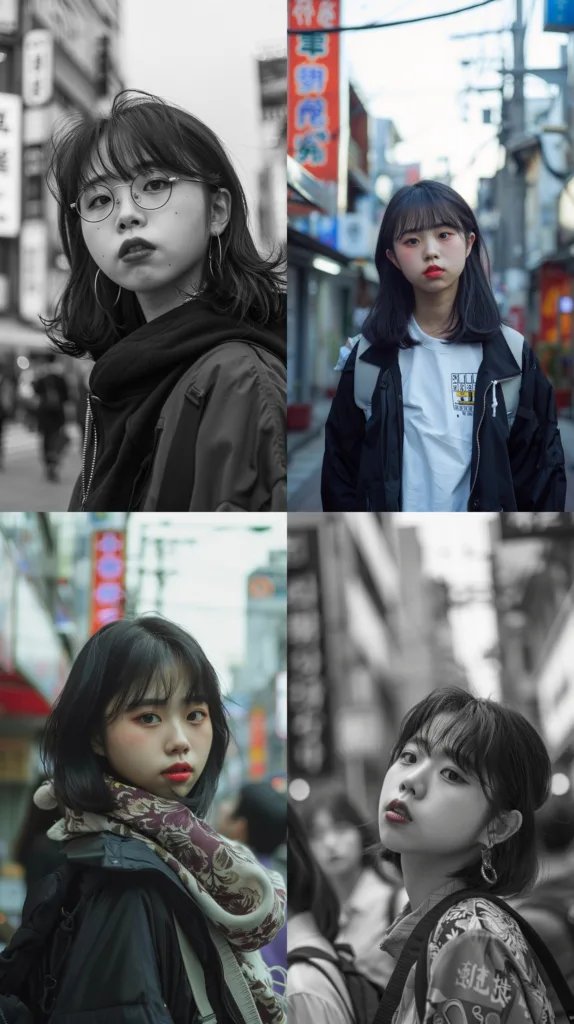
Prompt: 東京年輕女子街拍

Tokyo Young Women's Street Shoot. --ar 9:16 --cref https://s.mj.run/7UIyBjFr-Uk https://s.mj.run/tpdDDGjIAvo --v 6.0
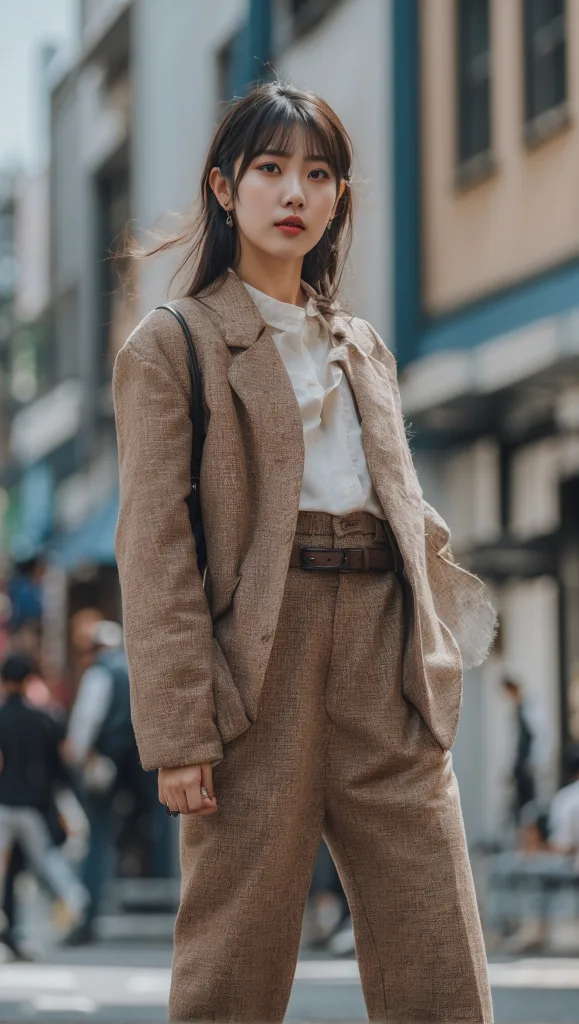
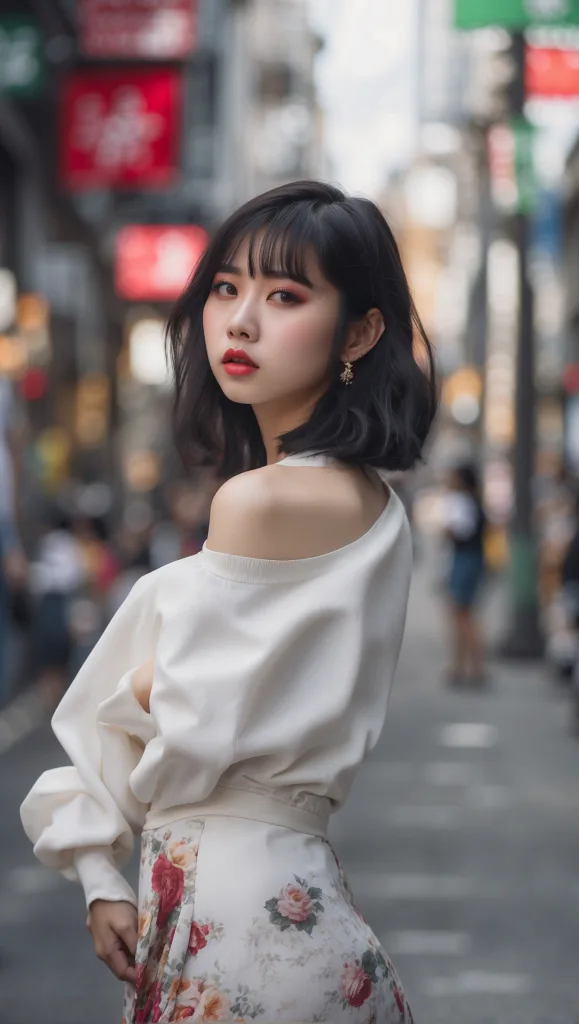
原圖( Leonardo )
輸出( Midjourney )

從輸出看得出確實是融合了我們提供的兩張圖的女主角風格,但是或許是這兩個女主角的臉蛋不太一致,輸出的結果並不是特別美麗。因此我們改以第二張圖像做單張的嘗試。

輸出單張 ( Midjourney )

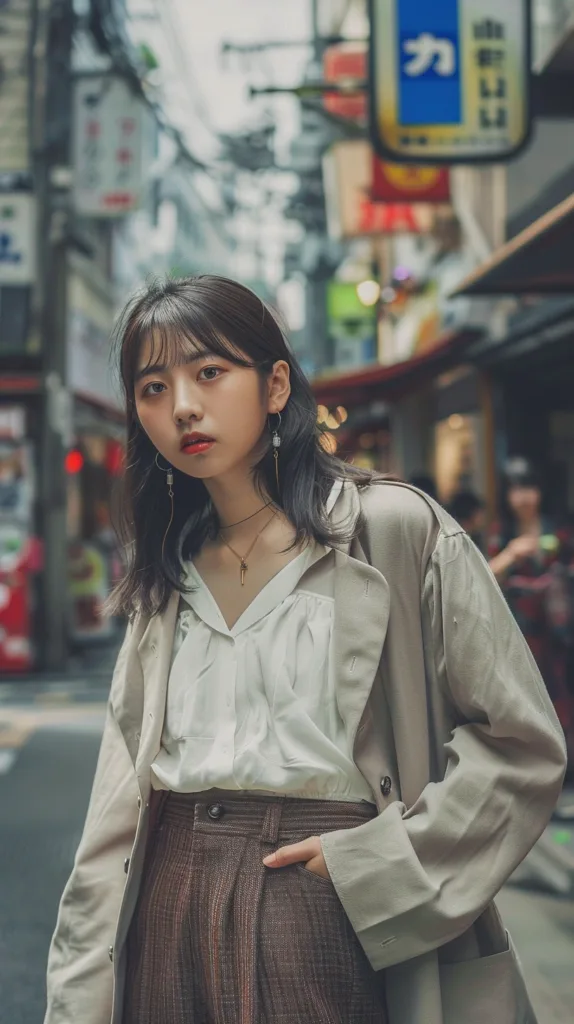
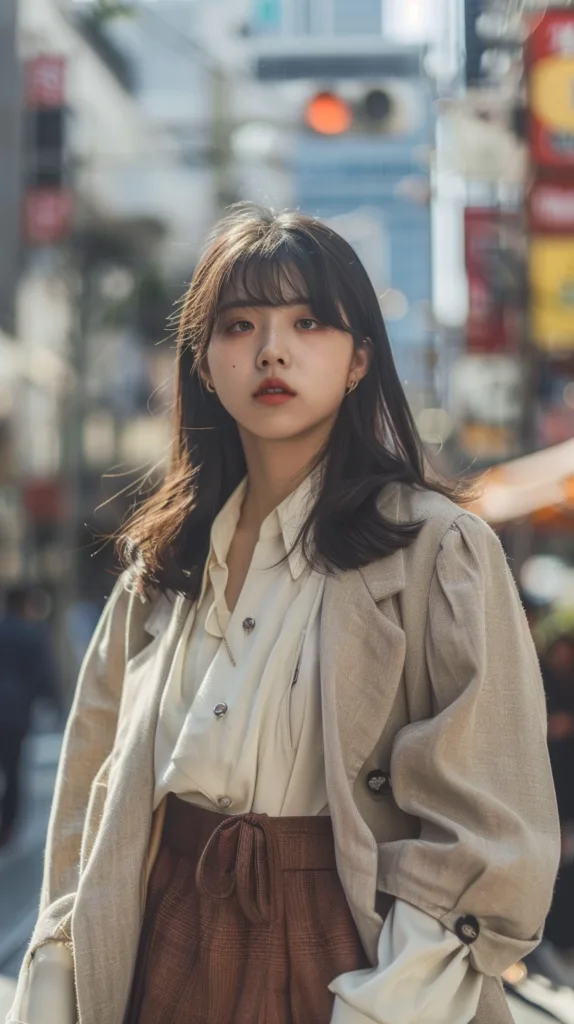
在筆者嘗試的過程中,當 Midjourney 碰到非它生成的參考圖像時,確實有時會出現身體動作不自然的情形,但狀況不嚴重,多嘗試幾次即可。我們可以看到生成的圖像人物的髮型、眼睛、嘴唇、臉龐的確參考原始圖像的風格,但是也呈現了很明顯的 Midjourney 風格。有些讀者可能不太想要這麼強烈的平台風格,只想要擷取原始圖像的臉蛋,所以讓我們再試試去除 Midjourney 的風格,並使用 cw=0 參數:

以上是筆者實際測試的結果展示,各位讀者可以根據需要,參考筆者的參數呈現做出適合自己工作狀況的圖像。

進一步閱讀
  1. Midjourney 推出模型個人化( Model Personalization )功能
  2. 在 Midjourney 中使用 Triple Triple 技巧創造獨特風格的圖像